
📍 你在这里 AI 应用 · 第 2 篇 / 共 8 篇
← 上一篇 检索增强生成 RAG · 下一篇 → Function Calling 与 MCP
向量化的意义及方法
向量化是为了计算问题的关联性,就好比相似度计算,比如在动物模型识别中猫和狗(哺乳动物、四条腿、外形相似等)计算出来他们相似度就比较高。
我们常用的是大语言模型,所以要计算文字特征的相似度。
将文字转化为向量(即文本嵌入,Text Embedding),常见的方法有基于词袋模型的方法、基于Word2Vec等的神经网络方法、基于预训练语言模型(如BERT)的方法 ,以下是具体介绍:
基于词袋模型(Bag of Words,BoW)及其扩展
- 词袋模型
- 原理:把文本看作是一个无序的词集合,忽略语法和词序等信息。构建一个包含所有文本中出现的词的词典,对于每一个文本,统计词典中每个词在该文本中出现的次数,从而得到一个向量表示。例如,对于文本“我喜欢苹果”和“我喜欢香蕉”,词典可能是["我", "喜欢", "苹果", "香蕉"] ,第一个文本对应的向量可能是[1, 1, 1, 0] ,第二个文本对应的向量是[1, 1, 0, 1] 。
- 局限:无法考虑词序,也不能很好地体现词与词之间的语义关系,比如“苹果好吃”和“好吃苹果”在词袋模型下向量表示是一样的,但语义有差别。
- TF-IDF(Term Frequency-Inverse Document Frequency)
- 原理:在词袋模型基础上,对每个词的出现次数进行加权。TF(词频)表示一个词在文本中出现的频率,IDF(逆文档频率)衡量一个词在整个文档集合中的重要性,即一个词在越少的文档中出现,其IDF值越高。通过TF和IDF的乘积来表示每个词在文本中的权重,从而得到更有区分度的文本向量。
- 应用场景:在文本分类、信息检索等领域应用广泛,能帮助突出文本中的关键信息。
基于神经网络的方法(以Word2Vec为例)
- Word2Vec
- Skip - Gram模型:预测给定词上下文的词。例如,对于句子“我喜欢苹果”,给定“喜欢”,模型尝试预测“我”和“苹果”等上下文词。通过大量文本的训练,使得语义相近的词在向量空间中距离较近。
- CBOW(Continuous Bag of Words)模型:与Skip - Gram相反,根据上下文词预测当前词。例如,根据“我”和“苹果”预测“喜欢”。
- 原理:Word2Vec通过神经网络学习词的分布式表示,将每个词映射到一个低维的向量空间中。在这个向量空间里,语义相似的词在空间中的位置相近 ,比如“苹果”和“香蕉”在向量空间中的距离会比“苹果”和“汽车”更近。
- 优点:能有效捕捉词与词之间的语义关系,生成的词向量可以用于多种自然语言处理任务,如词性标注、命名实体识别等。
基于预训练语言模型的方法(以BERT为例)
- BERT(Bidirectional Encoder Representations from Transformers)
- 原理:基于Transformer架构,通过在大规模文本数据上进行无监督的预训练,学习到文本的上下文信息。BERT能够同时考虑一个词的左右上下文,从而生成更准确的词向量表示。例如,在句子“苹果是一种水果”和“我苹果手机坏了”中,“苹果”在不同语境下,BERT可以生成不同但合理的向量表示。
- 微调(Fine-tuning):在预训练完成后,针对具体任务(如文本分类、情感分析等),将BERT模型与特定任务的神经网络层结合,在任务相关的标注数据上进行微调,进一步优化生成的文本向量,使其更适应具体任务需求。
- 应用场景:在众多自然语言处理任务中取得了非常好的效果,如问答系统、文本生成等。
除了上述方法外,还有ELMo(Embeddings from Language Models)、GPT(Generative Pretrained Transformer)系列模型 等也可以用于生成文本向量,不同的方法各有优缺点,在实际应用中,需要根据具体的任务需求、数据规模和计算资源等因素选择合适的方法。
相似度计算公式
常见的用于衡量Embedding向量之间距离,以判断文本相关性的计算方法有以下几种:
1. 余弦相似度(Cosine Similarity)
原理:余弦相似度通过计算两个向量夹角的余弦值来衡量它们的相似程度, 与向量的长度无关,只关注向量的方向。在文本Embedding场景中,即使两个文本的词频等出现差异导致向量长度不同,但只要语义相近,向量方向就会接近。
公式:对于两个向量$ \vec{A}=(a_1,a_2,\cdots,a_n) $和$ \vec{B}=(b_1,b_2,\cdots,b_n) $,余弦相似度$ sim(\vec{A},\vec{B}) $的计算公式为
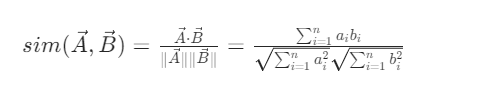
取值范围:$ [-1, 1] $,值越接近1,表示两个向量越相似,即文本相关性越高;值越接近 -1,表示两个向量越不相似;值为0 时,表示两个向量正交(在语义上不相关)。
公式简单解释:
我们来把这个余弦相似度公式拆解开,用更通俗的方式解释每个符号的意义。
1. $ \vec{A} $ 和 $ \vec{B} $
这两个符号代表两个向量,你可以把它们想象成两个“特征列表”。例如:
- 如果是文本,$ \vec{A} $ 可以是文本1的词向量(比如“猫喜欢吃鱼”的Embedding向量)。
- 如果是用户喜好,$ \vec{A} $ 可以是用户A的兴趣向量(比如[0.8, 0.2, 0.1]表示喜欢电影、音乐、书籍)。
2. $ \vec{A} \cdot \vec{B} $(点积)
这是两个向量的“点积”,计算方式是对应位置元素相乘后求和。例如:
- $ \vec{A} = (a_1, a_2, a_3) $,$ \vec{B} = (b_1, b_2, b_3) $
- 点积:$ a_1b_1 + a_2b_2 + a_3b_3 $
- 意义:衡量两个向量在“方向上的对齐程度”。如果两个向量方向一致,点积值较大;如果方向相反,点积值较小。
- $ |\vec{A}| $ 和 $ |\vec{B}| $(模长)
这是向量的“长度”,计算方式是各元素平方和的平方根。例如:
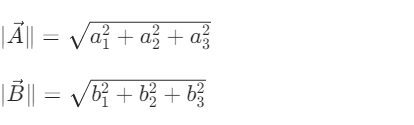
- 意义:对向量进行“归一化”,消除长度差异的影响。例如,如果 $ \vec{A} $ 是 $ \vec{B} $ 的2倍,但方向相同,余弦相似度仍为1。
- $ \cos(\vec{A}, \vec{B}) $(余弦相似度)
最终的相似度值,范围在[-1, 1]之间:
- 值越接近1:向量方向越相似(比如“猫喜欢吃鱼”和“狗喜欢啃骨头”可能有一定相似度)。
- 值越接近0:向量方向无关(比如“猫喜欢吃鱼”和“北京天气很好”)。
- 值越接近-1:向量方向相反(比如“我喜欢猫”和“我讨厌猫”)。
举个例子
假设:
- $ \vec{A} = (1, 2, 3) $(比如文本1的向量)
- $ \vec{B} = (2, 3, 4) $(比如文本2的向量)
计算过程:
- 点积:$ 1 \times 2 + 2 \times 3 + 3 \times 4 = 2 + 6 + 12 = 20 $
- 模长:
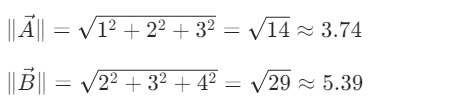
- 余弦相似度:$ \frac{20}{3.74 \times 5.39} \approx 0.99 $(非常相似)
总结
余弦相似度的核心是:不管向量多长,只看方向是否相似。
2. 欧几里得距离(Euclidean Distance)
原理:欧几里得距离是最常见的距离度量方式,它计算的是两个向量在空间中的直线距离。在文本Embedding向量空间里,距离越近意味着文本在语义等方面的差异越小。
公式:对于两个向量$ \vec{A}=(a_1,a_2,\cdots,a_n) $和$ \vec{B}=(b_1,b_2,\cdots,b_n) $,欧几里得距离$ d(\vec{A},\vec{B}) $的计算公式为
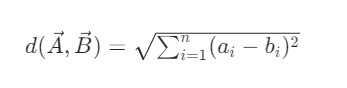
取值范围:$ [0, +\infty) $,值为0时,表示两个向量完全相同,即文本完全一样;值越大,说明两个文本的差异越大,相关性越低 。
3. 曼哈顿距离(Manhattan Distance)
原理:曼哈顿距离也叫城市街区距离,它计算的是两个向量在各个维度上的绝对差值之和。相比于欧几里得距离,曼哈顿距离计算更为简单,且对异常值相对不那么敏感。
公式:对于两个向量$ \vec{A}=(a_1,a_2,\cdots,a_n) $和$ \vec{B}=(b_1,b_2,\cdots,b_n) $,曼哈顿距离$ d_{manhattan}(\vec{A},\vec{B}) $的计算公式为
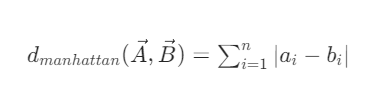
取值范围:$ [0, +\infty) $,取值特点和欧几里得距离类似,值越小文本相关性越高,值越大文本相关性越低。
4. 杰卡德相似度(Jaccard Similarity)
原理:通常用于集合之间的相似度计算,对于文本Embedding向量,如果将向量中的元素看作是某种特征集合(比如词的集合),可以通过杰卡德相似度来衡量文本的相似性。
公式:设$ A $和$ B $是两个集合,杰卡德相似度$ J(A,B) $的计算公式为
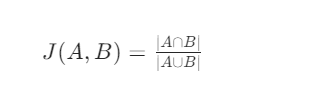
取值范围:$ [0, 1] $,值为0表示两个集合没有交集,对应文本相关性极低;值为1表示两个集合完全相同,文本相关性极高。
不同的距离计算方法适用于不同的场景,在实际应用中, 可以根据具体的任务需求、数据特点等因素来选择合适的距离度量方式。 例如,在需要考虑文本语义方向相似性,不关注向量长度差异的场景中,余弦相似度比较常用;而在一些对计算效率有要求,且希望简单衡量向量间差异的场景中,曼哈顿距离可能更为合适。
计算相似度的步骤
下面以Python语言为例,分别介绍基于余弦相似度、欧几里得距离、曼哈顿距离来计算文本Embedding向量相似度的实现步骤和代码示例:
1. 余弦相似度
步骤:
- 首先需要获取文本的Embedding向量,可以使用现成的预训练模型(如使用
transformers库加载BERT模型获取向量),或者已经计算好的向量数据。 - 利用数学库(如
numpy)按照余弦相似度公式计算两个向量的点积、各自的模长,进而得到余弦相似度值。
示例代码(使用numpy库计算):
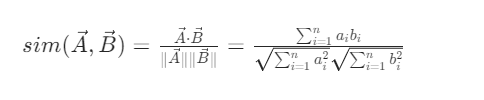
import numpy as np

# 假设已经获取到两个文本的Embedding向量
vector1 = np.array([0.1, 0.2, 0.3])
vector2 = np.array([0.2, 0.3, 0.4])

# 计算点积
dot_product = np.dot(vector1, vector2)
# 计算vector1的模长
norm_vector1 = np.linalg.norm(vector1)
# 计算vector2的模长
norm_vector2 = np.linalg.norm(vector2)
# 计算余弦相似度
cosine_similarity = dot_product / (norm_vector1 * norm_vector2)
print("余弦相似度:", cosine_similarity)
如果使用scikit-learn库,代码会更简洁:
from sklearn.metrics.pairwise import cosine_similarity
import numpy as np

vector1 = np.array([[0.1, 0.2, 0.3]])
vector2 = np.array([[0.2, 0.3, 0.4]])
result = cosine_similarity(vector1, vector2)
print("余弦相似度:", result[0][0])
2. 欧几里得距离
步骤:
- 同样先获取文本的Embedding向量。
- 根据欧几里得距离公式,计算两个向量对应元素差值的平方和,再取平方根。
示例代码(使用numpy库计算):
import numpy as np

vector1 = np.array([0.1, 0.2, 0.3])
vector2 = np.array([0.2, 0.3, 0.4])

# 计算欧几里得距离
euclidean_distance = np.sqrt(np.sum((vector1 - vector2) ** 2))
print("欧几里得距离:", euclidean_distance)
3. 曼哈顿距离
步骤:
- 准备好文本的Embedding向量。
- 按照曼哈顿距离公式,计算两个向量对应元素差值的绝对值之和。
示例代码(使用numpy库计算):
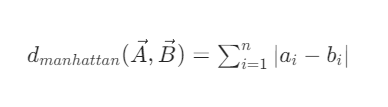
import numpy as np

vector1 = np.array([0.1, 0.2, 0.3])
vector2 = np.array([0.2, 0.3, 0.4])

# 计算曼哈顿距离
manhattan_distance = np.sum(np.abs(vector1 - vector2))
print("曼哈顿距离:", manhattan_distance)
在实际应用中,获取文本Embedding向量通常会借助一些深度学习框架和预训练模型。比如使用transformers库加载BERT模型来获取文本向量,示例如下:
from transformers import BertModel, BertTokenizer
import torch

# 加载BERT模型和分词器
model = BertModel.from_pretrained('bert-base-uncased')
tokenizer = BertTokenizer.from_pretrained('bert-base-uncased')

text1 = "苹果是一种水果"
text2 = "香蕉也是一种水果"
# 对文本进行编码
inputs1 = tokenizer(text1, return_tensors='pt')
inputs2 = tokenizer(text2, return_tensors='pt')

# 获取Embedding向量(这里取最后一层隐藏层的输出作为向量表示)
with torch.no_grad():
    outputs1 = model(**inputs1)
    outputs2 = model(**inputs2)
vector1 = outputs1.last_hidden_state.mean(dim=1).squeeze()
vector2 = outputs2.last_hidden_state.mean(dim=1).squeeze()

# 将向量转换为numpy数组以便后续计算
vector1 = vector1.numpy()
vector2 = vector2.numpy()

# 然后再使用上述计算相似度或距离的代码进行计算
上述代码先通过BERT模型获取了两个文本的Embedding向量,然后就可以按照前面介绍的方法计算它们之间的余弦相似度、欧几里得距离或曼哈顿距离了。
学完这个,你就会RAG了,所以RAG很简单,不要听那些课说的好复杂,其实就是把知识库通过向量模型(就是计算相似性)加工后丢给大模型润色输出就可以了。具体操作请参考:从零到一搭建一个RAG(https://kq4b3vgg5b.feishu.cn/wiki/CYStw9Hl8ihoMKk9z2ncFLvjnTc)
一起交流
分享你的思考,让讨论更进一步。