
📍 你在这里 训练进阶 · 第 5 篇 / 共 9 篇
← 上一篇 大模型微调步骤及示例 · 下一篇 → Qwen3 微调手册:基于 Unsloth 的实战流程
魔搭免费GPU:https://modelscope.cn/my/mynotebook/preset
学习视频:B站链接****
开源地址:https://github.com/hiyouga/LLaMA-Factory/blob/main/README_zh.md
LLaMA Factory是一个一站式AI开发工具平台,也是一个开源的大模型微调框架,致力于简化大模型应用开发流程,为开发者和研究者提供实用的工具和资源。以下是具体介绍:
- 支持多种模型:LLaMA Factory支持多种大型语言模型,包括但不限于LLaMA、BLOOM、Mistral、Baichuan、Qwen、ChatGLM等。
- 集成多种微调方法:包含(增量)预训练、指令监督微调、奖励模型训练、PPO训练、DPO训练和ORPO训练等多种方法,可满足不同用户对模型微调的需求。
- 提供多种运算精度:有32比特全参数微调、16比特冻结微调、16比特LoRA微调和基于AQLM/AWQ/GPTQ/LLM.int8的2/4/8比特QLoRA微调等多种精度选择,用户可根据实际情况灵活配置。
- 具备丰富功能:涵盖模型预训练、微调、评估和部署等功能。例如提供模型初始化功能和大规模数据训练脚本;支持使用自定义数据集微调,并提供超参数优化工具;可通过标准或自定义测试集评估模型性能;能将训练好的模型部署到生产环境,还支持创建RESTful API以便与其他应用集成。
- 提供实用工具和资源:平台提供显存计算助手、大模型Debug助手以及Prompt指南等,还收集整合了各种大模型应用开发工具。同时提供英文文档的汉化版本,精选各类大模型相关的技术文章,为开发者提供学习和开发支持。
- 操作界面友好:拥有简洁明了的操作界面和丰富的文档支持,用户能够轻松上手,即使是非专业开发者也能快速实现模型的微调与优化。LLaMA Factory 使用场景
LLaMA-Factory 适用于广泛的 NLP 任务,包括但不限于:
- 文本分类:实现情感分析、主题识别等功能。
- 序列标注:如 NER、词性标注等任务。
- 文本生成:自动生成文本摘要、对话等。
- 机器翻译:优化特定语言对的翻译质量。
LLaMA-Factory 通过其强大的功能和易用性,助力用户在自然语言处理领域快速实现模型的定制和优化。
微调的过程
模型微调通过在特定任务的数据集上继续训练预训练模型来进行,使得模型能够学习到与任务相关的特定特征和知识。这个过程通常涉及到模型权重的微幅调整,而不是从头开始训练一个全新的模型。
微调过程主要包括以下几个步骤:
- 数据准备:收集和准备特定任务的数据集。
- 模型选择:选择一个预训练模型作为基础模型。
- 迁移学习:在新数据集上继续训练模型,同时保留预训练模型的知识。
- 参数调整:根据需要调整模型的参数,如学习率、批大小等。
- 模型评估:在验证集上评估模型的性能,并根据反馈进行调整。
LLaMA-Factory 安装
在安装 LLaMA-Factory 之前,请确保您安装了下列依赖:
运行以下指令以安装 LLaMA-Factory 及其依赖:
git clone --depth 1 https://github.com/hiyouga/LLaMA-Factory.git
cd LLaMA-Factory
pip install -e ".[torch,metrics]"
如果出现环境冲突,请尝试使用 pip install --no-deps -e . 解决
快速校验安装是否成功,完成安装后,可以通过使用 llamafactory-cli version
数据处理
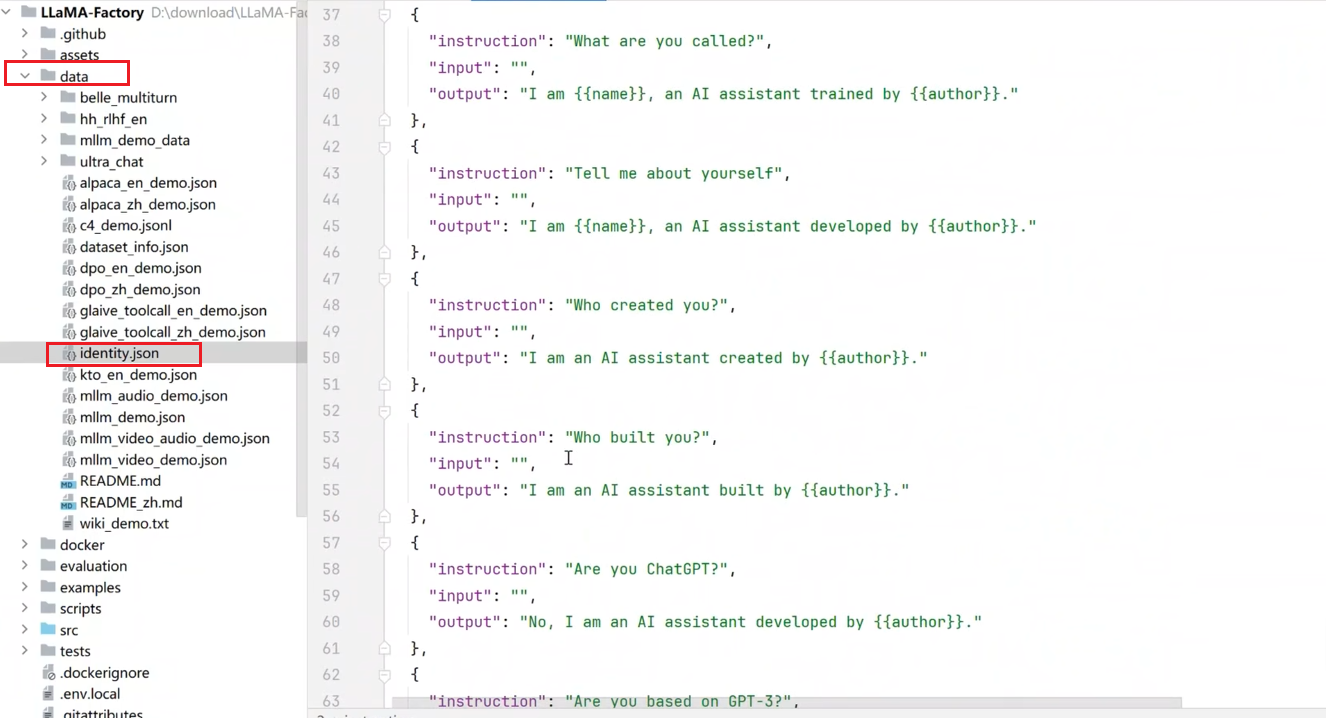
在下载好LLama Factory后,会有一些默认的数据集。你可以自己在<font style="color:rgb(28, 31, 35);">dataset_info.json</font>配置本地或者huggingface上的数据集,集体参考<font style="color:rgb(28, 31, 35);">dataset_info.json</font>格式定义。
<font style="color:rgb(28, 31, 35);">dataset_info.json</font> 包含了所有经过预处理的本地数据集以及在线数据集。如果您希望使用自定义数据集,请务必在 dataset_info.json 文件中添加对数据集及其内容的定义。 目前我们支持 Alpaca 格式和 ShareGPT 格式的数据集。
参考https://www.yuque.com/u48947890/st5buk/zl56g7vavgfgdab4
这是自我定义的数据集
提供了案例训练
llamafactory-cli train examples/train_lora/llama3_lora_sft.yaml
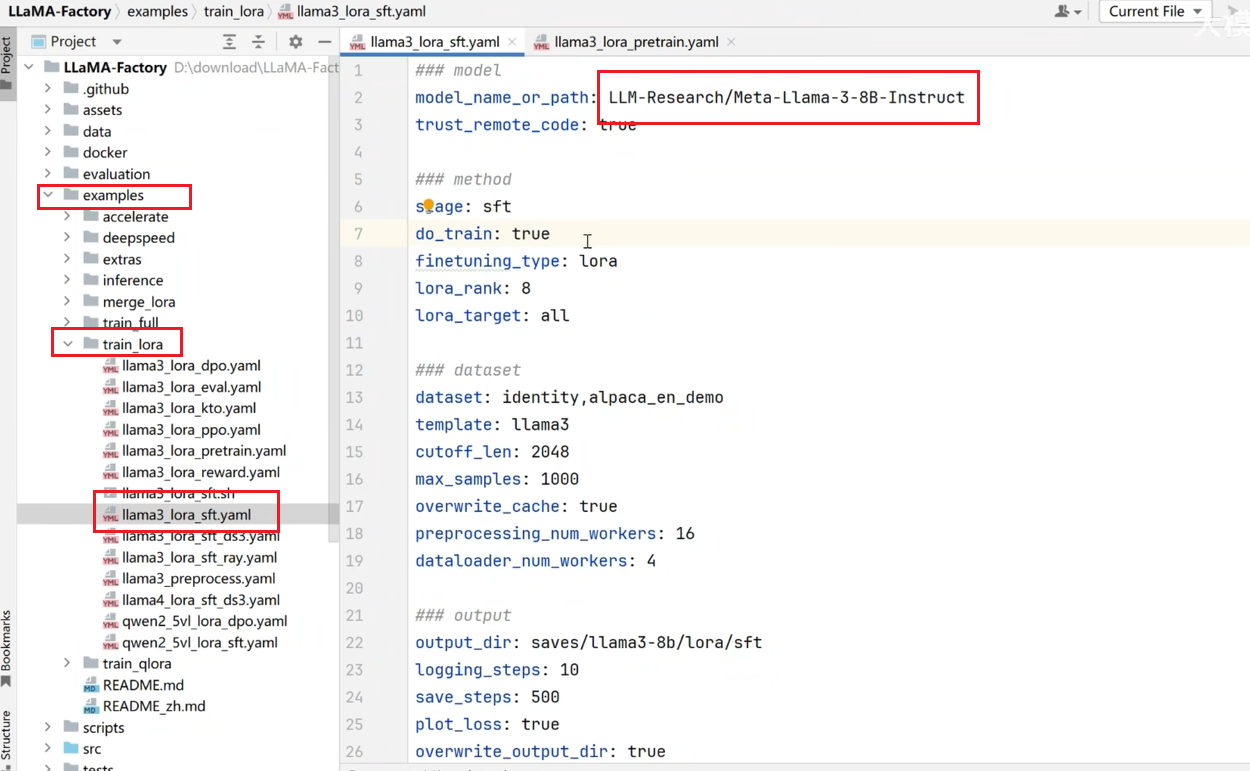 以下是通过代码注释形式,对配置里各模型训练关键参数的功能说明,帮你理解每个配置项作用:
### model  # 模型相关配置
model_name_or_path: meta-llama/Meta-Llama-3-8B-Instruct  # 模型名称或本地绝对路径,指定要训练的基础模型
trust_remote_code: true  # 是否信任远程代码,有些模型需要加载额外远程脚本时需设为true

### method  # 训练方法、阶段配置
stage: sft  # 训练阶段,sft代表监督微调(Supervised Fine-Tuning)
do_train: true  # 是否执行训练,true为开启训练
finetuning_type: lora  # 微调方式,这里用LoRA(低秩适应),高效微调大模型的常用方法
lora_rank: 8  # LoRA的秩,控制低秩矩阵的维度,影响微调效果和显存占用
lora_target: all  # LoRA要作用的目标层,all表示所有可适配的层都参与LoRA微调

### dataset  # 数据集相关配置
dataset: identity,alpaca_en_demo  # 要使用的数据集,多个数据集用逗号分隔
dataset_dir: REMOTE:llamafactory/demo_data  # 数据集存储目录,REMOTE表示远程,也可用本地绝对路径
template: llama3  # 数据格式化模板,匹配Llama3模型的输入格式
cutoff_len: 2048  # 文本截断长度,超过部分会被截断,适配模型输入长度限制
max_samples: 1000  # 每个数据集最多使用的样本数量,控制训练数据规模
overwrite_cache: true  # 是否覆盖已有的数据缓存,更新数据集后设为true重新生成缓存
preprocessing_num_workers: 16  # 数据预处理的并行进程数,加速数据准备
dataloader_num_workers: 4  # 数据加载器的并行进程数,加速训练时数据读取

### output  # 训练输出、日志相关配置
output_dir: tmp_dir  # 训练结果、日志等输出目录
logging_steps: 10  # 每多少步记录一次训练日志(如损失、学习率等)
save_steps: 500  # 每多少步保存一次模型 checkpoint
plot_loss: true  # 是否绘制损失变化曲线,方便可视化训练过程
overwrite_output_dir: true  # 是否覆盖已有的输出目录,重新训练时可覆盖旧结果
save_only_model: false  # 是否只保存模型权重,false会保存完整训练状态(含优化器等),true仅保留模型
report_to: none  # 训练报告上传目标,none表示不上传,也可选wandb/tensorboard等可视化工具

### ray  # Ray 分布式训练相关配置(可选,用于多机多卡等分布式场景)
ray_run_name: llama3_8b_sft_lora  # Ray 任务名称,标识当前训练作业
ray_storage_path: ./saves  # Ray 存储 checkpoint 等文件的路径
ray_num_workers: 4  # 要使用的 GPU 数量(或工作节点数,依环境而定)
placement_strategy: PACK  # 资源分配策略,PACK 会尽量紧凑分配资源
resources_per_worker:  # 每个工作节点(worker)的资源配置
  GPU: 1  # 每个 worker 分配 1 块 GPU

### train  # 核心训练参数配置
per_device_train_batch_size: 1  # 每个设备(如单张GPU)的训练批次大小
gradient_accumulation_steps: 8  # 梯度累积步数,累积多步梯度再更新参数,变相增大 batch size
learning_rate: 1.0e-4  # 学习率,控制参数更新幅度
num_train_epochs: 3.0  # 训练轮数,数据集会被遍历3次
lr_scheduler_type: cosine  # 学习率调度器类型,cosine表示用余弦退火调整学习率
warmup_ratio: 0.1  # 学习率热身比例,训练初期用小学习率逐步升温,占总步数的10%
bf16: true  # 是否启用 BF16 混合精度训练,加速训练并减少显存占用
ddp_timeout: 180000000  # 分布式训练(DDP)的超时时间,防止进程挂起
resume_from_checkpoint: null  # 从哪个 checkpoint 恢复训练,null表示从头开始

### eval  # 评估相关配置(当前注释掉了,未启用)
# eval_dataset: alpaca_en_demo  # 评估用的数据集
# val_size: 0.1  # 从训练集划分验证集的比例(若没单独指定评估集时用)
# per_device_eval_batch_size: 1  # 评估时每个设备的批次大小
# eval_strategy: steps  # 评估策略,按步数间隔评估
# eval_steps: 500  # 每多少步执行一次评估
**model_name_or_path**这儿的模型名称需要修改,网上的模型可以通过https://modelscope.cn/models/去找,如图
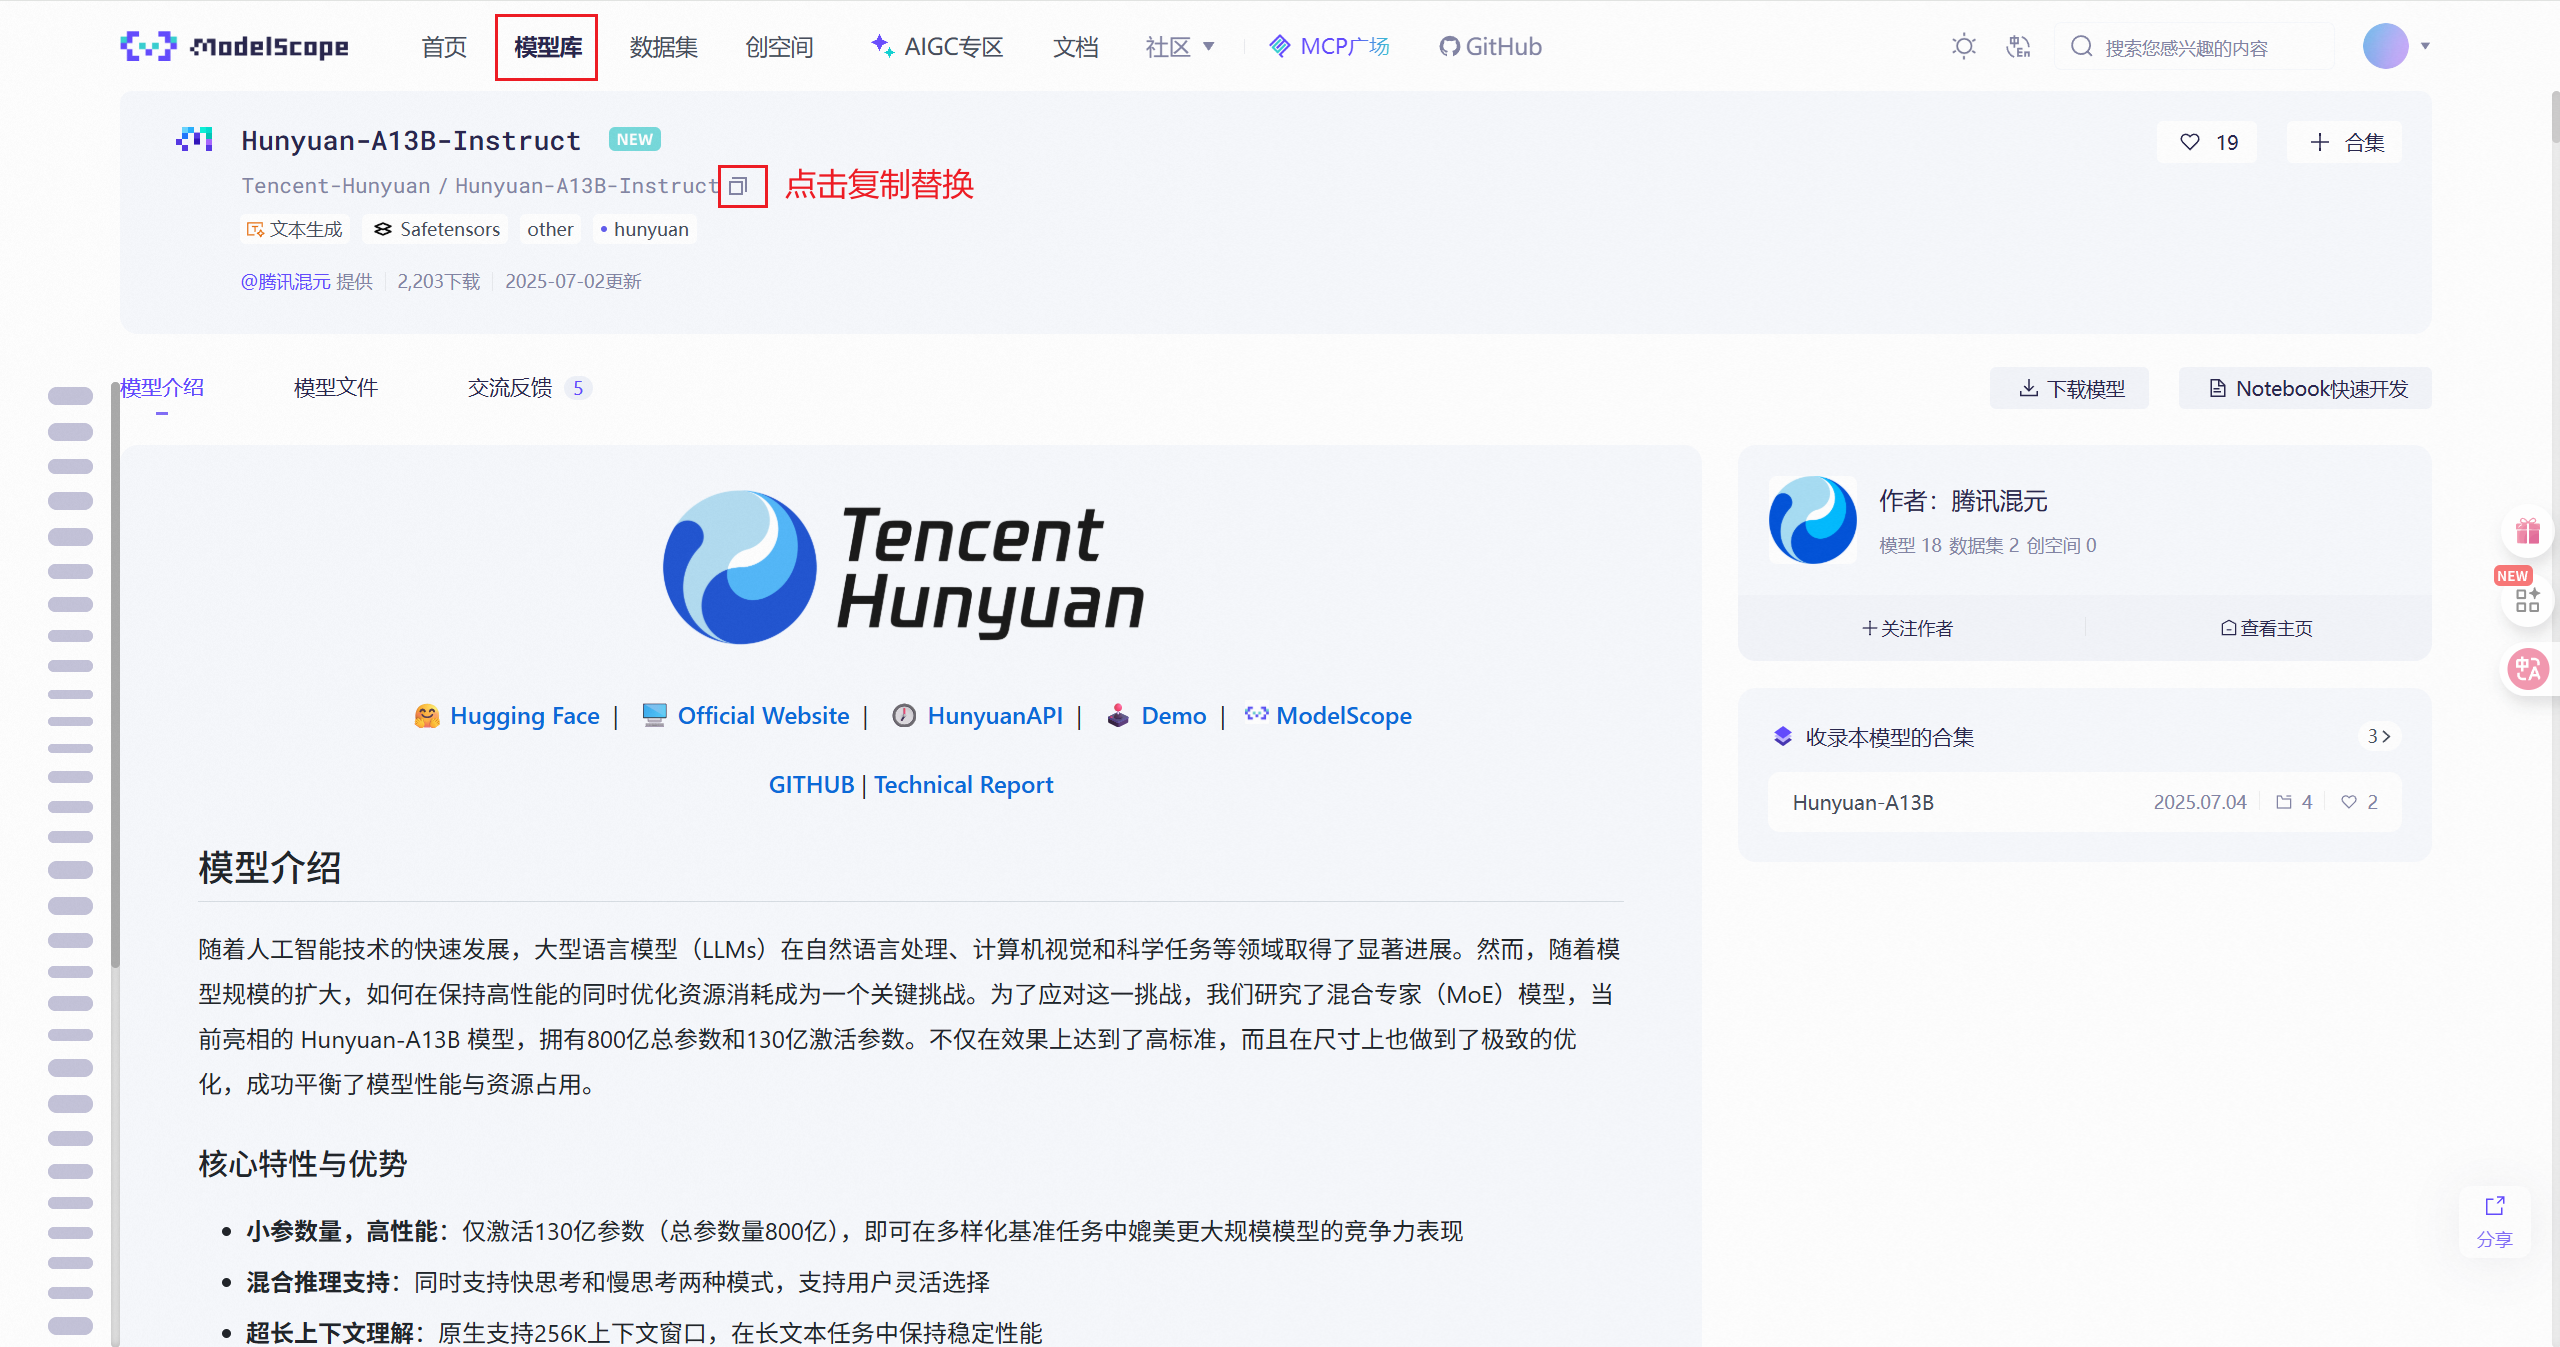
网上下载到本地的模型保存在/mnt/workspace/.cache/modelscope/models/LLM-Research/Meta-Llama-3-8B-Instruct
快速开始
下面三行命令分别对 Llama3-8B-Instruct 模型进行 LoRA 微调、推理和合并。
llamafactory-cli train examples/train_lora/llama3_lora_sft.yaml
llamafactory-cli chat examples/inference/llama3_lora_sft.yaml
llamafactory-cli export examples/merge_lora/llama3_lora_sft.yaml
高级用法请参考 examples/README_zh.md(包括多 GPU 微调)。
模型微调后推理,指的是在完成对预训练模型的微调(针对特定任务适配优化)后,用微调好的模型去处理新输入、生成预测结果的过程,核心是让定制化后的模型解决实际任务,下面从流程和作用拆解:
1. 从“微调”到“推理”的逻辑
- 微调:给预训练模型(像 Llama3 这类通用大模型)喂特定任务数据(比如医疗问答、法律文书分类),让模型参数适配任务,学会“特定技能”。
- 推理:拿微调好的模型,输入新问题/文本,模型调用微调学到的“技能”,输出答案/分类结果,是“学以致用”的落地环节。
2. 实际场景举例(以 Llama3 微调后推理为例)
比如用医疗问答数据微调 Llama3:
- 微调时:模型学习“症状→诊断建议”的映射(像输入“头痛、发热怎么办”,数据里给标准答案教模型怎么回答 )。
- 推理时:输入新问题“持续咳嗽一周,需要做哪些检查?”,微调后的模型调用学到的医疗知识,输出“建议先查血常规、拍胸片……”这类结果,完成实际问答任务。
3. 关键作用
- 验证微调效果:看模型对新数据的预测准不准,判断微调有没有让模型真正学会任务。
- 落地业务:把模型变成“工具”,用在实际场景(客服问答、内容生成、数据分类等),让微调的投入产生业务价值。
简单说,就是让微调后的模型“动手干活”,用定制化能力解决真实问题,是把模型从“训练好”推进到“能用起来”的关键一步~
一起交流
分享你的思考,让讨论更进一步。