
📍 你在这里 AI 基础 · 第 5 篇 / 共 13 篇
← 上一篇 免费大模型 API 收藏 · 下一篇 → Python 项目虚拟环境搭建
数据分析导论
概述
为什么要学数据分析?
| 功能 | Excel | Python (Pandas) |
|---|---|---|
| 数据处理量 | 1万行以内 | 100万行以上 |
| 自动化 | 手动操作 | 代码一键运行 |
| 学习难度 | 简单 | 需基础编程知识 |
传统方法:用Excel手工处理数据
- 问题:数据量超过1万行会卡顿,复杂计算需要写复杂公式
- 举例:统计全校1000名学生成绩排名,手动操作需2小时
Python数据分析:
- 优势:自动处理百万级数据,代码可重复使用
- 举例:用Pandas代码3分钟完成相同任务
完整流程
- 数据收集
- 数据从哪里来?公司数据库 | 公开数据集(如政府数据) | 手动爬取
- 数据清洗(最重要!)
- 典型问题:
- 缺失值(如Excel里的空单元格)
- 错误数据(如年龄填成200岁)
- 格式混乱(日期写成“2023年1月1日”和“01/01/2023”混用)
- 典型问题:
- 数据分析
- 常用方法:
- 统计(平均值、最大值、比例)
- 分组对比(如男vs女用户的消费差异)
- 常用方法:
- 数据可视化
- 一图胜千言:折线图(趋势) | 柱状图(对比) | 散点图(相关性)
数分工具链
核心三件套:
| 工具 | 作用 | 类比说明 |
|---|---|---|
| Numpy | 高性能数值计算(矩阵/向量) | 数据的"发动机" |
| Pandas | 表格数据处理(类似高级Excel) | 数据的"手术刀" |
| Matplotlib | 数据可视化(绘图库) | 数据的"翻译官" |
典型工作流:Numpy处理数字 → Pandas整理表格 → Matplotlib 画图展示。
辅助工具:
- Jupyter Notebook
+ 交互式编程环境,实时显示代码和结果
+ 优势:适合教学/探索性分析(可保存图文混合笔记) - Anaconda
+ 一键安装所有工具的科学计算发行版
+ 包含:Python解释器 + 常用库 + 环境管理工具
Anaconda
什么是Anaconda
Anaconda官网地址:Advance AI with Open Source | Anaconda
简单来说,Anaconda = Python + 包和环境管理器(Conda)+ 常用库 + 集成工具。它适合那些需要快速搭建数据科学或机器学习开发环境的用户。Anaconda和Python相当于是汽车和发动机的关系,安装Anaconda后,就像买了一台车,无需自己去安装发动机和其他零配件,而Python作为发动机提供Anaconda工作所需的内核。
Anaconda包及其依赖项和环境的管理工具为 conda 命令,与传统的 Python pip 工具相比Anaconda的conda可以更方便地在不同环境之间进行切换,环境管理较为简单。
为什么选择 Anaconda?
- 方便安装: 安装 Anaconda 就像安装一个应用程序一样简单,它为您预先安装好了许多常用的工具,无需单独配置。
- 包管理器: Anaconda 包含一个名为 Conda 的包管理器,用于安装、更新和管理软件包。Conda 不仅限于 Python,还支持多种其他语言的包管理。
- 环境管理: 使用 Anaconda,您可以轻松地创建和管理多个独立的 Python 环境,比如可以安装 python2 和 python3 环境,然后实现自由切换。这对于在不同项目中使用不同的库和工具版本非常有用,以避免版本冲突。
- 集成工具和库: Anaconda 捆绑了许多用于数据科学、机器学习和科学计算的重要工具和库,如 NumPy、Pandas、Matplotlib、SciPy、Scikit-learn 等。
- Jupyter 笔记本: Jupyter 是一个交互式的计算环境,支持多种编程语言,但在 Anaconda 中主要用于 Python。它允许用户创建和共享包含实时代码、方程式、可视化和叙述文本的文档。
- Spyder 集成开发环境: Anaconda 中集成了 Spyder,这是一个专为科学计算和数据分析而设计的开发环境,具有代码编辑、调试和数据可视化等功能。
- 跨平台性: Anaconda可在Windows、macOS和 Linux等操作系统上运行,使其成为一个跨平台的解决方案。
- 社区支持: Anaconda 拥有庞大的社区,用户可以在社区论坛上获取帮助、分享经验和解决问题。
核心优势
- 预装200+数据科学包
- 开箱即用:无需手动安装NumPy/Pandas等库
- 完整生态:包含数据分析、机器学习、可视化全套工具
- Anaconda一站式 vs 原生Python+pip
| 对比维度 | Anaconda方案 | 原生Python+pip方案 |
|---|---|---|
| 安装难度 | ⭐️ 一键安装所有工具 | ⭐️⭐️⭐️ 需手动装每个库 |
| 依赖管理 | Conda自动解决依赖冲突 | pip可能遇到版本兼容问题 |
| 磁盘占用 | ⚠️ 较大(3GB+基础包) | ✅ 可按需安装(最小仅几十MB) |
| 适用场景 | 初学者/快速开始数据分析 | 开发者/需要精确控制环境 |
| 典型案例 | 学校教学/个人学习 | 生产服务器部署 |
Jupyter
Jupyter 是一个开源的交互式计算环境,广泛应用于数据科学、机器学习、科学研究等领域,主要组件有Jupyter Notebook和Jupyter Lab。JupyterLab作为Jupyter Notebook 的继承者,提供了更现代化和功能丰富的界面。JupyterLab的多文档界面、内置协作功能和扩展系统使其成为数据科学家和研究人员的首选。
常用快捷键:
| esc | 从输入模式退出到命令模式 |
|---|---|
| a | 在当前cell上面创建一个新的cell |
| b | 在当前cell 下面创建一个新的cell |
| dd | 删除当前cell |
| m | 切换到markdown模式 |
| y | 切换到code模式 |
| ctrl+回车 | 运行cell |
| shift +回车 | 运行当前cell并创建一个新的cell |
Numpy 科学计算
基本介绍
numpy是Python中科学计算的基础包。它是一个Python库,提供多维数组对象、各种派生对象(例如掩码数组和矩阵)以及用于对数组进行快速操作的各种方法,包括数学、逻辑、形状操作、排序、选择、I/O 、离散傅里叶变换、基本线性代数、基本统计运算、随机模拟等等。
numpy的部分功能如下:
- ndarray,一个具有矢量算术运算和复杂广播能力的快速且节省空间的多维数组。
- 用于对整组数据进行快速运算的标准数学函数(无需编写循环)。
- 用于读写磁盘数据的工具以及用于操作内存映射文件的工具。
- 线性代数、随机数生成以及傅里叶变换功能。
- 用于集成由C、C++、Fortran等语言编写的代码的API。
为什么需要Numpy?
# 原生Python列表 vs NumPy数组性能对比
import time
import numpy as np

py_list = list(range(1000000))
np_arr = np.arange(1000000)

# 计算平方和
start = time.time()
sum([x**2 for x in py_list])
print(f"Python列表耗时: {time.time()-start:.4f}s")

start = time.time()
np.sum(np_arr**2)
print(f"NumPy数组耗时: {time.time()-start:.4f}s")
输出示例:
Python列表耗时: 0.1256s
NumPy数组耗时: 0.0023s
ndarray(N-dimensional Array)
核心特性
- 多维性:支持 0 维(标量)、1 维(向量)、2 维(矩阵)及更高维数组。
- 同质性:ndarray 中的所有元素必须是相同的数据类型。如果输入不同类型的数据,会被强制转换成相同类型。
# 不同的数据类型会被强制转换成相同的数据类型
arr = np.array([1, 'hello'])  # 数字和字符串 → 字符串
print(arr)  # ['1' 'hello']

arr = np.array([1, 2.5])  # 整数和浮点数 → 浮点数
print(arr)  # [1.  2.5]
- 高效性:基于连续内存块存储,支持向量化运算。
相关属性
核心属性:
(举例 arr = np.array([[1, 2], [3, 4]]))
| 属性名称 | 通俗解释 | 使用示例 | 输出结果 | 实际用途 |
|---|---|---|---|---|
| shape | 数组的形状:行数和列数(或更高维度的尺寸)。 | arr.shape | (2, 2) | 查看或调整数组结构(如变形)。 |
| ndim | 维度数量:数组是几维的(1维、2维、3维等)。 | arr.ndim | 2 | 判断数组是向量、矩阵还是高维数据。 |
| size | 总元素个数:数组中所有元素的总数。 | arr.size | 4 | 快速计算元素总量。 |
| dtype | 元素类型:数组中元素的类型(整数、浮点数等)。 | arr.dtype | int64(或 int32) | 确保计算时类型一致(如避免整数除法问题)。 |
- shape:就像问数组“长什么样”。
- 示例:
arr = np.array([[1, 2], [3, 4]])的 shape 是 (2, 2),表示2行2列。 - 变形操作:
arr.reshape(4, 1)会变成4行1列的数组。
- 示例:
- ndim:判断数组是“几维空间”。
- 一维数组(向量):ndim=1,如 [1, 2, 3]。
- 二维数组(矩阵):ndim=2,如表格数据。
- 三维数组(立体):ndim=3,如RGB图片数据。
- dtype:确保所有元素是“同一类型”。
- 如果数组中有小数,dtype 会自动变成 float64(避免精度丢失)。
- 强制指定类型:
np.array([1, 2], dtype=np.float32)。
代码演示:
import numpy as np

# 创建一个3x2的二维数组
arr = np.array([[1, 2], [3, 4], [5, 6]])

print("形状 shape:", arr.shape)    # 输出 (3, 2)
print("维度 ndim:", arr.ndim)     # 输出 2
print("总元素 size:", arr.size)   # 输出 6
print("元素类型 dtype:", arr.dtype)  # 输出 int64
进阶属性(了解即可)
| 属性名称 | 通俗解释 | 示例代码 | 输出结果 | 应用场景 |
|---|---|---|---|---|
| T | 转置:行变列,列变行。 | arr.T | [[1, 3], [2, 4]] | 矩阵运算(如矩阵乘法)。 |
| itemsize | 单个元素占用的内存字节数。 | arr.itemsize | 8(int64 类型占8字节) | 优化内存占用时参考。 |
| nbytes | 数组总内存占用量:size * itemsize。 | arr.nbytes | 32(4元素 × 8字节) | 处理大数据时监控内存消耗。 |
| flags | 内存存储方式:是否连续存储(高级优化)。 | arr.flags | C_CONTIGUOUS : True 等 | 高性能计算或底层内存操作。 |
创建方法
方法总览:
| 用途 | 方法 | 语法示例 | 核心作用 | 输出示例 |
|---|---|---|---|---|
| 基础构造:适用于手动构建小规模数组或复制已有数据 | ||||
| 从 Python 数据结构创建 | np.array() |
np.array([[1, 2], [3, 4]]) |
将列表/元组转换为 ndarray | array([[1, 2], [3, 4]]) |
| 复制数组 | np.copy() |
np.copy(arr) |
创建独立副本(深拷贝) | 与原数组相同但不共享内存 |
| 预定义形状填充: 用于快速初始化固定形状的数组(如全0占位、全1初始化) | ||||
| 全 0 数组 | np.zeros() |
np.zeros((2, 3)) |
快速初始化全 0 数组 | [[0., 0., 0.], [0., 0., 0.]] |
| 全 1 数组 | np.ones() |
np.ones((3, 2), dtype=int) |
快速初始化全 1 数组 | [[1, 1], [1, 1], [1, 1]] |
| 未初始化数组 | np.empty() |
np.empty((2, 2)) |
预分配内存(值随机) | 随机值(如 [[1e-323, 0.], [0., 0.]]) |
| 填充固定值 | np.full() |
np.full((2, 3), 5) |
用指定值填充数组 | [[5, 5, 5], [5, 5, 5]] |
| 基于数值范围生成:生成数值序列,常用于模拟时间序列、坐标网格等 | ||||
| 等差序列 | np.arange() |
np.arange(0, 10, 2) |
生成步长固定的序列(不含终点) | [0, 2, 4, 6, 8] |
| 等间隔序列 | np.linspace() |
np.linspace(0, 1, 5) |
生成指定数量的等间隔值(含终点) | [0., 0.25, 0.5, 0.75, 1.] |
| 对数间隔序列 | np.logspace() |
np.logspace(0, 2, 3, base=10) |
生成对数间隔值 | [1.0, 10.0, 100.0] |
| 特殊矩阵生成:数学运算专用(如线性代数中的单位矩阵) | ||||
| 单位矩阵 | np.eye() |
np.eye(3) |
生成单位矩阵(对角线为 1) | [[1., 0., 0.], [0., 1., 0.], [0., 0., 1.]] |
| 对角矩阵 | np.diag() |
np.diag([1, 2, 3]) |
生成以指定值为对角线的矩阵 | [[1, 0, 0], [0, 2, 0], [0, 0, 3]] |
| 随机数组生成:模拟实验数据、初始化神经网络权重等场景 | ||||
| 均匀分布随机数 | np.random.rand() |
np.random.rand(2, 2) |
生成 (0,1) 均匀分布随机数 | [[0.43, 0.89], [0.21, 0.57]] |
| 正态分布随机数 | np.random.randn() |
np.random.randn(2, 2) |
标准正态分布(均值 0,方差 1) | [[-0.5, 1.2], [0.3, -1.8]] |
| 随机整数 | np.random.randint() |
np.random.randint(1, 10, (2, 2)) |
生成指定范围的随机整数 | [[3, 7], [5, 2]] |
| 高级构造方法:处理非结构化数据(如文件、字符串)或通过函数生成复杂数组 | ||||
| 从字符串创建 | np.array() |
np.array(['a', 'bc']) |
将字符串转为字符数组 | array(['a', 'bc'], dtype='<U2') |
| 从文件读取 | np.loadtxt() |
np.loadtxt('data.txt') |
从文本文件加载数据 | 依文件内容(如 [[1., 2.], [3., 4.]]) |
| 函数生成数组 | np.fromfunction() |
np.fromfunction(lambda i, j: i + j, (3, 3)) |
根据函数规则生成数组元素 | [[0., 1., 2.], [1., 2., 3.], [2., 3., 4.]] |
从 Python 数据结构转换
将 Python 列表、元组等转换为 ndarray,是最直接的方式。
np.array(object, dtype=None)
import numpy as np

# 从列表创建一维数组
arr1 = np.array([1, 2, 3])
print(arr1)  # 输出: [1 2 3]

# 从嵌套列表创建二维数组
arr2 = np.array([[1, 2], [3, 4]])
print(arr2)
# 输出:
# [[1 2]
#  [3 4]]

# 指定数据类型
arr3 = np.array([1, 2.5], dtype=np.float32)
print(arr3.dtype)  # 输出: float32
注意事项
- 混合类型时,NumPy 会统一为最高优先级类型(如 int + float → float,数值 + 字符串 → 字符串)。
- 列表的嵌套层级决定 ndim(维度数)。
预定义形状填充
快速初始化固定形状的数组,常用于占位或初始化权重矩阵。
import numpy as np
np.zeros(shape, dtype=float)  # 全0  返回给定形状和类型的新数组,用0填充。
np.ones(shape, dtype=float)   # 全1  返回给定形状和类型的新数组,用1填充。
import numpy as np
# 创建 2x3 全0浮点数组
zeros_arr = np.zeros((2, 3))
print(zeros_arr)
# 输出:
# [[0. 0. 0.]
#  [0. 0. 0.]]

# 创建 3x2 全1整数数组
ones_arr = np.ones((3, 2), dtype=int)
print(ones_arr)
# 输出:
# [[1 1]
#  [1 1]
#  [1 1]]
默认数据类型为 float64,需显式指定 dtype 为 int 或其他类型。
未初始化的数组
np.empty(shape, dtype=float),返回给定形状和类型的未初始化的新数组。
创建未初始化的数组(值随机,取决于内存状态),适用于对性能要求极高的场景。
import numpy as np
empty_arr = np.empty((2, 2))
print(empty_arr)  # 输出可能为随机值(如 [[1e-323, 0. ], [0., 0. ]])
不推荐直接使用:需手动填充数据,否则可能引入不可预测的错误。
需要注意的是,np.empty 并不保证数组元素被初始化为 0,它只是分配内存空间,数组中的元素值是未初始化的,可能是内存中的任意值。
重复填充数组
np.full(shape, fill_value, dtype)
import numpy as np

full_arr = np.full((2, 3), 5)
print(full_arr)
# 输出:
# [[5 5 5]
#  [5 5 5]]
zeros_like():返回与给定数组具有相同形状和类型的0新数组。
ones_like():返回与给定数组具有相同形状和类型的1新数组。
empty_like():返回与给定数组具有相同形状和类型的未初始化的新数组。
import numpy as np
arr1 = np.array([1, 2, 3])
arr3 = np.array([1, 2.5], dtype=np.float32)

arr2 = np.ones_like(arr1)  # 创建和arr1形状相同的全1数组
arr4 = np.empty_like(arr3)  # 创建和arr3形状相同的未初始化数组
arr2 = np.full_like(arr1, 5)
基于数值范围生成
- 等差序列:
np.arange(start, stop, step)。返回在给定范围内用均匀间隔的值填充的一维数组。
import numpy as np

arr = np.arange(0, 10, 2)  # 0 ≤ 值 <10,步长2
print(arr)  # 输出: [0 2 4 6 8]
- 等间隔数组(含终点):
np.linspace(start, stop, num=50)。返回指定范围和元素个数的等差数列。数组元素类型为浮点型。
arr = np.linspace(0, 1, 5)  # 0到1之间生成5个等间隔值
print(arr)  # 输出: [0.   0.25 0.5  0.75 1.  ]
- 对数间隔数组:
np.logspace(start, stop, num=50, base=10)。返回指定指数范围、元素个数、底数的等比数列。
arr = np.logspace(0, 2, 3)  # 10^0, 10^1, 10^2
print(arr)  # 输出: [  1.  10. 100.]
特殊矩阵
基础知识:
矩阵是线性代数的核心概念,可以理解为一个数字的矩形表格,用来表示数据、方程组或线性变换。下面用最直观的方式介绍它的基本概念和应用。
- 矩阵是什么?
矩阵是一个由 行(row) 和 列(column) 排列成的矩形数组,例如:
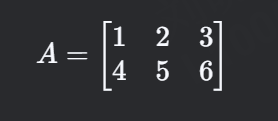
- 形状(shape):这个矩阵有 2 行 3 列,记作 2×3 矩阵。
- 元素(entry):矩阵中的每个数字称为元素,如 A<sub>1,2</sub>=2(第 1 行第 2 列)。
- 矩阵的用途
- 表示线性方程组。例如,方程组:
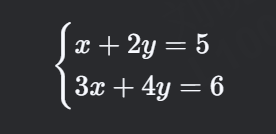
可以写成矩阵形式:
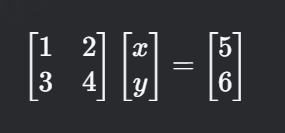
即 Ax=b,其中:
    * _A_ 是系数矩阵,
    * **x** 是未知数列向量,
    * **b** 是常数项列向量。
2. **表示线性变换**,矩阵可以描述空间中的变换,比如旋转、缩放、投影。
例如,一个 2×2 矩阵可以表示二维平面的旋转:
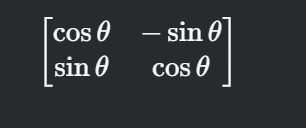
作用在向量 [xy] 上,会使其旋转 θ 角度。
3. **数据表示**(如机器学习)。在机器学习中,数据集通常用矩阵表示:
    * 每一行代表一个样本(如一张图片),
    * 每一列代表一个特征(如像素值)。
- 矩阵的基本运算
- 矩阵加法。对应位置的元素相加,要求两个矩阵形状相同:
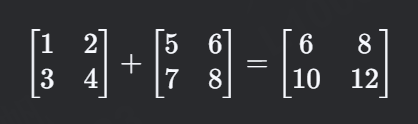
2. 矩阵数乘。矩阵的每个元素乘以一个标量(数):
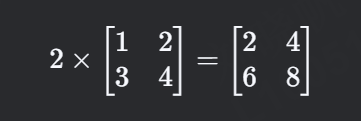
3. 矩阵乘法。行 × 列 的点积运算(矩阵乘法 不是 对应元素相乘):
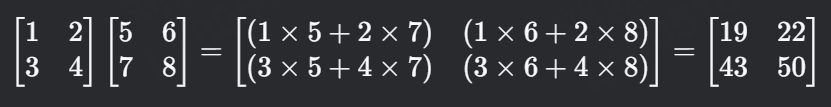
注意:矩阵乘法不满足交换律(AB≠BA_AB_=BA)。
4. 转置(Transpose)。行列互换:
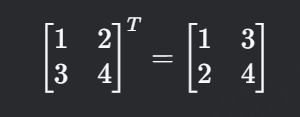
特殊矩阵:
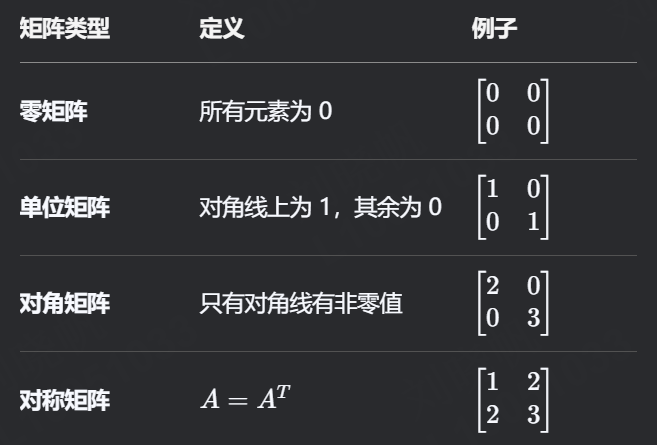
- 单位矩阵 (np.eye/np.identity)
np.eye(N)  # NxN 单位矩阵
np.identity(N)
eye_arr = np.eye(3)
print(eye_arr)
# 输出:
# [[1. 0. 0.]
#  [0. 1. 0.]
#  [0. 0. 1.]]
- 对角矩阵 (np.diag)
np.diag([a, b, c]) # 对角线为 a, b, c,其余为0
diag_arr = np.diag([1, 2, 3])
print(diag_arr)
# 输出:
# [[1 0 0]
#  [0 2 0]
#  [0 0 3]]
随机数组
- 均匀分布随机数 (np.random.rand):返回给定形状的数组,用 [0, 1) 上均匀分布的随机样本填充。
rand_arr = np.random.rand(2, 2)  # [0,1) 均匀分布
# 输出示例: [[0.43, 0.89], [0.21, 0.57]]
- 正态分布随机数 (np.random.randn):返回给定形状的数组,用标准正态分布(均值为0,标准差为1)的随机样本填充。
randn_arr = np.random.randn(2, 2)  # 均值为0,方差为1
# 输出示例: [[-0.5, 1.2], [0.3, -1.8]]
- 随机整数 (np.random.randint):返回给定形状的数组,用从低位(包含)到高位(不包含)上均匀分布的随机整数填充。
int_arr = np.random.randint(1, 10, (2, 2))  # [1,10) 的整数
# 输出示例: [[3, 7], [5, 2]]
- random.uniform():返回给定形状的数组,用从低位(包含)到高位(不包含)上均匀分布的随机浮点数填充。
arr3 = np.random.uniform(3, 6, (2, 3))
# [[5.69275495 3.84857937 3.2899215 ]
#  [5.32035519 3.7460973  3.33859905]]
- 设置随机种子 (np.random.seed):用于设置随机数生成器种子的函数,目的是确保程序的随机操作可以重复生成相同的结果(即保证随机结果的确定性)。这在实验复现、调试和教学场景中非常有用。
import numpy as np

# 设置随机种子
np.random.seed(42)  # 参数可以是任意整数

# 生成随机数
print(np.random.rand(3))  # 输出固定结果
每次运行上述代码都会得到相同的随机数序列(例如 [0.37454012, 0.95071431, 0.73199394])。
关键细节
1. **种子的一致性**:
    * 相同种子生成的随机数序列完全一致。
    * 不同种子(如 np.random.seed(0) 和 np.random.seed(1))会产生不同序列。
2. **作用范围**:
    * 种子对后续所有基于 NumPy 的随机函数生效(如 np.random.rand(), np.random.normal(), np.random.shuffle() 等)。
通过控制种子,能在“随机”和“可复现”之间灵活切换!
高级构造方法
- np.loadtxt
data = np.loadtxt('data.txt') # 读取文本文件
- np.genfromtxt
data = np.genfromtxt('data.csv', delimiter=',') # 支持复杂格式
推荐使用场景
| 创建方法 | 推荐使用场景 |
|---|---|
np.array() |
从 Python 列表/元组转换,数据已知 |
np.zeros() |
初始化数组,后续填充数据 |
np.ones() |
初始化数组,后续进行运算 |
np.empty() |
性能要求高,立即填充数据 |
np.full() |
需要填充特定初始值 |
np.arange() |
生成整数序列,步长明确 |
np.linspace() |
生成等间隔浮点数序列 |
np.logspace() |
生成对数间隔序列 |
np.random.*() |
生成随机数据,模拟测试 |
np.eye() / np.diag() |
线性代数运算,矩阵操作 |
数据类型
ndarray 支持多种数据类型:
| 数据类型 | 类型代码 | 说明 |
|---|---|---|
| bool | 布尔类型 | |
| int8、uint8 int16、uint16 int32、uint32 int64、uint64 |
i1,u1 i2,u2 i4,u4 i8,u8 |
有符号、无符号的8位(1字节)整型 有符号、无符号的16位(2字节)整型 有符号、无符号的32位(4字节)整型 有符号、无符号的64位(8字节)整型 |
| float16 float32 float64 |
f2 f4或f f8或d |
半精度浮点型 单精度浮点型 双精度浮点型 |
| complex64 complex128 |
c8 c16 |
用两个32位浮点数表示的复数 用两个64位浮点数表示的复数 |
创建数组时可以使用dtype参数指定元素类型:
arr1 = np.array([1, 2, 3], dtype=np.float64)# [1. 2. 3.]
arr2 = np.array([0.2, 2.5, 4.8], dtype="i8")# [0 2 4]
也可以使用ndarray.astype()方法转换数组的元素类型:
arr1 = np.array([1, 2, 3], dtype=np.float64)# [1. 2. 3.]
arr2 = arr1.astype(np.int64)# [1 2 3]
高级使用:
# 显式指定数据类型
arr = np.array([1, 2, 3], dtype=np.float32)

# 类型转换
int_arr = arr.astype(np.int32)

# 内存优化示例
large_arr = np.ones(1000000, dtype=np.float64)  # 占用8MB
optimized = large_arr.astype(np.float32)        # 优化为4MB
索引与切片
| 索引/切片类型 | 描述/用法 | 示例代码 | 示例输出 |
|---|---|---|---|
| 基本索引 | 通过整数索引直接访问元素。索引从0开始。 | arr = np.arange(1, 10).reshape(3,3)<br>print(arr[1, 2]) |
6(第2行第3列的元素) |
| 行/列切片 | 使用冒号 : 切片语法选择行或列的子集。 | print(arr[:, 1])<br>print(arr[::2, ::2]) |
[2 5 8](所有行的第2列) [[1, 3], [7, 9]](隔行隔列取样) |
| 连续切片 | 从起始索引到结束索引按步长切片。 | arr = np.arange(10)<br>print(arr[2:9:2])<br>print(arr[2:]) |
[2 4 6 8](索引2到8,步长2) [2 3 4 5 6 7 8 9](索引2到最后) |
| 使用 slice 函数 | 通过 slice(start, stop, step) 定义切片规则。 | print(arr[slice(2, 9, 2)]) |
[2 4 6 8](等效于 arr[2:9:2]) |
| 布尔索引 | 通过布尔条件筛选满足条件的元素。支持逻辑运算符 &、|。 |
data = np.random.randn(100)<br>print(data[(data > 0.5) & (data < 1.0)]) |
输出满足条件 0.5 < data < 1.0 的元素数组。 |
示例:
arr = np.arange(1, 10).reshape(3,3)
print(arr[1, 2])       # 第2行第3列 → 6
print(arr[:, 1])       # 所有行的第2列 → [2 5 8]
print(arr[::2, ::2])   # 隔行隔列取样 → [[1,3],[7,9]]

# 布尔索引实战
data = np.random.randn(100)
print(data[(data > 0.5) & (data < 1.0)]) # 条件筛选
ndarray 对象的内容可以通过索引或切片来访问和修改,与 Python 中 list 的切片操作一样。
可以通过内置的slice函数,或者冒号设置start, stop及step参数进行切片,从原数组中切割出一个新数组。
import numpy as np
arr = np.arange(10)
print(arr)# [0 1 2 3 4 5 6 7 8 9
#获取索引为2的数据
print(arr[2])# 2
# 从索引 2开始到索引9(不包含)停止,间隔为2
print(arr[slice(2,9,2)])# [2 4 6 8]
# 从索引2开始到索引9(不包含)停止,间隔为2
print(arr[2:9:2])# [2 4 6 8]
# 从索引2开始到最后(不包含),默认间隔为1
print(arr[2:])# [2 3 4 5 6 7 8 9]
# 从索引2开始到索引9(不包含)结束,默认间隔为1
print(arr[2:9])# [2 3 4 5 6 7 8]
- 切片语法规则:
start:stop:step,左闭右开区间(包含 start,不包含 stop)。 - 布尔索引限制:布尔数组的维度需与原数组匹配。
- 内存共享特性:切片返回的是原数组的视图(共享内存),修改切片会影响原数组。需用 copy() 创建独立副本。
基本运算
numpy中的数组不用编写循环即可执行批量运算,称之为矢量化运算。
大小相等的数组之间的任何算术运算都会将运算应用到元素级。
arr1 = np.array([[1, 2, 3], [4, 5, 6]])
arr2 = np.array([[7, 8, 9], [10, 11, 12]])
print(arr1 + arr2)
print(arr1 - arr2)
print(arr1 * arr2)
print(arr1 / arr2)
数组与标量的算术运算会将标量值传播到各个元素,不同大小的数组之间的运算叫做广播。
arr1 = np.array([[1, 2, 3], [4, 5, 6]])
print(arr1 + 100)
print(arr1 - 100)
print(arr1 * 100)
print(arr1 / 100)
思考:形状不同的ndarray可以进行算术运算吗?
广播机制是 NumPy 中一个强大的特性,它允许在不同形状的数组之间进行元素级运算。广播机制的规则如下:
- 规则1:如果俩个数组的维度数不相同,那么小维度数组的形状将会在最左边补1。
import numpy as np
# 一维数组
arr1 = np.array([1, 2, 3])  # 形状为 (3,)
# 二维数组
arr2 = np.array([[4], [5], [6]])  # 形状为 (3, 1)
# 对 arr1 应用规则 1,在其形状最左边补 1,变为 (1, 3)  [[1,2,3]]
# 此时 arr1 形状 (1, 3) 和 arr2 形状 (3, 1) 满足广播条件
result = arr1 + arr2
print("规则 1 示例结果:\n", result)
- 规则2:如果俩个数组的形状在任何一个维度上都不匹配,那么数组的形状会沿着维度大小(元素个数)为1的维度开始扩展 ,(维度必须是1开始)直到所有维度都一样, 以匹配另一个数组的形状。
import numpy as np
# 二维数组
arr3 = np.array([[1, 2, 3]])  # 形状为 (1, 3)
# 二维数组
arr4 = np.array([[4], [5], [6]])  # 形状为 (3, 1)
# arr3 沿着第0个维度扩展,将原有的一行数据复制成3行,为 (3, 3)=>[[1,2,3], [1,2,3], [1,2,3]]
# arr4 沿着第1个维度扩展, (3, 3)=>[[4,4,4], [5,5,5], [6,6,6]]
result = arr3 + arr4
print("规则 2 示例结果:\n", result)

# 规则3:如果俩个数组的形状在任何一个维度上都不匹配,并且没有任何一个维度大小等于1,那么会引发异常。import numpy as np
# 一维数组
arr5 = np.array([1, 2, 3])  # 形状为 (3,)
# 一维数组
arr6 = np.array([4, 5])  # 形状为 (2,)
try:
    result = arr5 + arr6
    print(result)
except ValueError as e:
    print(f"规则 3 示例错误信息:{e}")
矢量化运算(Vectorization)
核心思想:用数组级别的操作替代显式循环,利用底层优化(如 SIMD 指令)加速计算。
特点:
- 避免 Python 的 for 循环,直接对整个数组进行数学运算(如 a + b)。
- 要求参与运算的数组形状完全相同(否则会报错或触发广播机制)。
示例:
import numpy as np

a = np.array([1, 2, 3])
b = np.array([4, 5, 6])
c = a + b  # 矢量化加法 → [5, 7, 9]
广播机制(Broadcasting)
NumPy 中,形状不同的 ndarray 是否能进行算术运算,取决于是否满足广播机制。广播的本质不是“随意扩展数组”,而是在不真实复制数据的前提下,让不同形状的数组在运算时“看起来”具有相同形状。
广播规则:
- 先将两个数组的 shape 从右向左对齐,若维度数不足,则在左侧补 1
- 然后逐维比较,对应维度要么大小相等,要么其中一个为 1,否则无法广播并直接报错。
如果所有维度都满足条件,则可以进行运算。
广播过程中,只有维度大小为 1 的轴可以被“拉伸”,这是一种逻辑上的扩展,而非真实的内存复制。NumPy 通过复用同一份数据来参与计算,因此广播既高效又节省内存。广播完成后,结果数组在每一维上的大小,取参与运算数组中该维度的较大值。
示例:
(5, 1)和(1, 7)—— 能广播
步骤拆解:
1. 两个 shape 已经同维度(都是 2 维),不用补维
2. 两个向量逐维比较:
    * 第 1 维:`5` 和 `1` → 有 `1`
    * 第 2 维:`1` 和 `7` → 有 `1`
3. 每一维都满足规则
广播过程:
- `(5, 1)`:每一行只有 1 个数 → 横向复制成 7 列
- `(1, 7)`:只有 1 行 → 纵向复制成 5 行
最终结果 shape:**(5, 7)**
(2, 2)和(3,)—— 不能广播
步骤拆解:
1. `(3,)` 右对齐补 1:
(2, 2)
(1, 3)
2. 从右往左比:第 2 维:`2` 和 `3` 不相等,且都不是 1
结论:没有 1 可以“兜底扩展”,NumPy 不知道该怎么对齐
从直觉上看,广播的行为很像在“找形状的公倍数”,例如 (5, 1) 与 (1, 7) 可以广播成 (5, 7),这一点与数学中的最小公倍数非常相似。但需要注意的是,NumPy 的广播规则比数学公倍数更严格:它只允许 1 作为“万能因子”进行扩展,而不允许 2 → 4、3 → 6 这类非 1 的放大。这一限制来源于 NumPy 的内存模型设计,确保广播始终是零拷贝、可控且高性能的。
因此,可以将 NumPy 广播理解为:在每一个维度上,只允许通过 **1** 作为中介,找到两个数组可以对齐的最小公共形状(因为 1 表示“这一行 / 这一列只有一个值,可以重复用”;就比如 一行数据 或者 一列数据,可以复制并铺成一个表格)。掌握这一点,就能在实际开发、数值计算以及深度学习中,准确判断数组运算是否可行,并避免广播相关的错误。
两者关系
矢量化运算 vs. 广播机制的关系
| 特性 | 矢量化运算 | 广播机制 |
|---|---|---|
| 目标 | 避免显式循环,提升计算效率 | 解决不同形状数组的运算问题 |
| 依赖关系 | 广播机制是矢量化运算的补充 | 广播机制使矢量化运算更灵活 |
| 形状要求 | 通常要求数组形状相同 | 允许形状不同,但需满足广播规则 |
| 底层实现 | 基于优化过的 C/Fortran 代码 | 自动扩展数组,不实际复制数据 |
本质:广播的作用就是让不同形状的数组能够进行矢量化运算。
典型场景分析
- 纯矢量化运算(形状相同)
a = np.array([1, 2, 3])
b = np.array([4, 5, 6])
c = a + b  # 直接逐元素相加 → [5, 7, 9]
- 矢量化 + 广播(形状不同但可广播)
a = np.array([[1], [2], [3]])  # shape (3, 1)
b = np.array([10, 20, 30])     # shape (3,)
c = a + b
# 广播步骤:
# 1. a 扩展为 [[1, 1, 1], [2, 2, 2], [3, 3, 3]](虚拟扩展,不实际复制)
# 2. b 扩展为 [[10, 20, 30], [10, 20, 30], [10, 20, 30]]
# 结果:
# [[11, 21, 31],
#  [12, 22, 32],
#  [13, 23, 33]]
- 无法广播的情况
a = np.array([1, 2, 3])
b = np.array([10, 20])
a + b  # 报错:shapes (3,) and (2,) cannot be broadcast
矩阵乘法
通过*运算符和np.multiply()对两个数组相乘进行的是对位乘法而非矩阵乘法运算。
import numpy as np
arr1 = np.array([[1, 2, 3], [4, 5, 6]])
arr2 = np.array([[6, 5, 4], [3, 2, 1]])
print(arr1 * arr2)
print(np.multiply(arr1, arr2))
# [[ 6 10 12]
#  [12 10  6]]

# [[ 6 10 12]
#  [12 10  6]]
使用np.dot()、ndarray.dot()、@可以进行矩阵乘法运算。
import numpy as np
arr1 = np.array([[1, 2, 3], [4, 5, 6]])
arr2 = np.array([[6, 5], [4, 3], [2, 1]])#对于矩阵乘法来说,要求第一个矩阵的列数等于第二个矩阵的行数
print(arr1)
print(arr2)
print(arr1.shape, arr2.shape)
print(np.dot(arr1, arr2))
print(arr1.dot(arr2))
print(arr1 @ arr2)# 一个二维数组跟一个大小合适的一维数组的矩阵点积运算之后将会得到一个一维数组
arr3 = np.array([6, 5, 4])
print(arr3.shape)
print(arr1 @ arr3)

# 运行结果:
# [[1 2 3]
#  [4 5 6]]

# [[6 5]
#  [4 3]
#  [2 1]]

# (2, 3) (3, 2)

# [[20 14]
#  [56 41]]

# [[20 14]
#  [56 41]]

# [[20 14]
#  [56 41]]

# (3,)
# [28 73]
A = np.array([[1,2],[3,4]])
B = np.array([[5,6],[7,8]])

# 逐元素运算
print(A * B)   # [[5,12],[21,32]]

# 矩阵乘法
print(A @ B)   # [[19,22],[43,50]]

# 广播机制演示
C = np.array([10,20])
print(A + C)   # [[11,22],[13,24]]
常用函数
常用函数表:
| 分类 | 函数 | 功能说明 |
|---|---|---|
| 基本数学 | np.sqrt(x) | 计算平方根 |
| np.exp(x) | 计算指数(e^x) | |
| np.log(x) | 计算自然对数(ln(x)) | |
| np.sin(x) | 计算正弦值 | |
| np.abs(x) | 计算绝对值 | |
| np.power(a, b) | 计算 a 的 b 次幂 | |
| np.round(x, n) | 四舍五入(保留 n 位小数) | |
| 统计 | np.sum(x) | 求和 |
| np.mean(x) | 计算均值 | |
| np.median(x) | 计算中位数 | |
| np.std(x) | 计算标准差 | |
| np.var(x) | 计算方差 | |
| np.min(x) / np.max(x) | 查找最小值/最大值 | |
| np.percentile(x, q) | 计算分位数(q: 0~100) | |
| 比较 | np.greater(a, b) | 元素级比较 a > b |
| np.less(a, b) | 元素级比较 a < b | |
| np.equal(a, b) | 元素级比较 a == b | |
| np.logical_and(a, b) | 逻辑与(逐元素) | |
| np.where(condition, x, y) | 根据条件选择元素 | |
| 排序 | np.sort(x) | 返回排序后的副本 |
| x.sort() | 原地排序(修改原数组) | |
| np.argsort(x) | 返回排序后的索引 | |
| np.lexsort(keys) | 多键排序(按最后一列优先) | |
| 去重 | np.unique(x) | 返回唯一值并排序 |
| np.in1d(a, b) | 检查 a 的元素是否在 b 中存在 | |
| 其他实用 | np.concatenate((a, b)) | 数组拼接 |
| np.split(x, indices) | 分割数组 | |
| np.reshape(x, shape) | 调整数组形状 | |
| np.copy(x) | 创建数组的深拷贝 | |
| np.isnan(x) | 检测 NaN 值 |
统计基础概念
| 统计量名称 | 数学定义与解释 | 常见用途 | 图示理解建议(文本) |
|---|---|---|---|
| 总和(和) | 所有数值相加的结果 | 总支出、总收入、总分等 | 直方图每列的“高度总和” |
| 计数(非空) | 所有非缺失值的数量 | 数据有效性统计 | 每列或每组的“存在数量” |
| 唯一计数 | 去重后的值的个数 | 用户量、种类、独特答案数等 | 彩色圆点图:每种颜色的数量 |
| 频率统计 | 每个唯一值出现的次数 | 投票结果、偏好选项统计 | 每种值为一柱的频数柱状图 |
| 平均数 | 所有数值的总和 / 个数 | 成绩均值、产品均价 | 数轴上“重心”位置 |
| 中位数 | 将所有值排序后位于中间位置的那个值 | 房价中位数、收入中位数 | 数轴上“居中”点 |
| 众数 | 出现频率最高的值;可能有多个 | 最常见类别、最流行选项 | 柱状图中“最高柱”的位置 |
| 众数个数 | 用于判断是否有多个众数 | 检查分布集中性 | 多个柱一样高 → 多众数 |
| 最大值 | 数据中的最大元素 | 最高温度、最大销量 | 数轴最右端的点 |
| 最小值 | 数据中的最小元素 | 最低成绩、最低价格 | 数轴最左端的点 |
| 分位数 | 把数据分成若干个相同大小的部分,第 q 个分位数是从小到大第 q 比例处的值 | 算工资等级、考试分数线 | 25%、50%、75%点→形成“箱型图” |
方差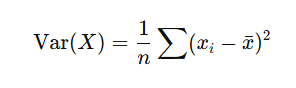 |
所有数据与平均值之差的平方和的平均数(度量“离均差”的平方,即 放大“偏离平均值”的程度 ) | 波动性分析、风险评估 | 离平均数越远的点 → 贡献越大 |
标准差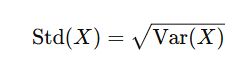 |
方差的平方根;表示数据的波动程度,即 数据大约在平均值上下浮动多少单位 | 正态分布、偏差分析、误差建模 | 平均数±1个标准差 → 约68%数据范围 |
协方差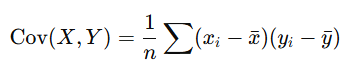 |
两个变量各自与均值之差乘积的平均值,衡量两者的变化趋势是否一致 | 股价、气温等变量共同趋势 | 趋势一致 → 正值,反向 → 负值 |
| 相关系数 | 标准化的协方差,范围为 [-1, 1],衡量两个变量之间的线性相关程度 | 预测模型、特征选择、相关分析 | 趋势完全相同 → 1,完全相反 → -1 |
基本数学函数
| 函数 | 功能说明 | 示例代码 | 示例输出 |
|---|---|---|---|
| np.sqrt(x) | 计算平方根 | np.sqrt([1, 4, 9]) | [1. 2. 3.] |
| np.exp(x) | 计算指数(e^x) | np.exp([0, 1]) | [1. 2.71828183] |
| np.log(x) | 计算自然对数(ln(x)) | np.log([1, np.e]) | [0. 1.] |
| np.sin(x) | 计算正弦值 | np.sin(np.pi/2) | 1.0 |
| np.abs(x) | 计算绝对值 | np.abs([-1, 2.5]) | [1. 2.5] |
| np.power(a, b) | 计算 a 的 b 次幂 | np.power(2, [3, 4]) | [8 16] |
| np.round(x, n) | 四舍五入(保留 n 位小数) | np.round(3.1415, 2) | 3.14 |
| np.ceil(x) | 向上取整(不小于原数的最小整数) | np.ceil([1.2, 3.7, -2.3]) | [ 2. 4. -2.] |
| np.floor(x) | 向下取整(不大于原数的最大整数) | np.floor([1.2, 3.7, -2.3]) | [ 1. 3. -3.] |
| np.rint(x) | 四舍五入到最近的整数;当需要舍入的数字恰好是 5 时,会看 5 前面的数字,如果是偶数则直接舍去 5,如果是奇数则进位。 | np.rint([1.5, 2.3, 3.7]) | [1. 2. 4.] |
| np.multiply(a, b) | 元素级乘法(等价于 a * b) | np.multiply([2, 3], [4, 5]) | [ 8 15] |
| np.divide(a, b) | 元素级除法(等价于 a / b) | np.divide([6, 8], [2, 4]) | [3. 2.] |
| np.isnan(x) | 检测 NaN 值 | np.isnan([1, np.nan, 3]) | [False True False] |
代码演示:
arr1 = np.random.randn(2, 3)
print(arr1)
print(np.abs(arr1))
print(np.ceil(arr1))
print(np.floor(arr1))
print(np.rint(arr1))
print(np.isnan(arr1))
print(np.multiply(arr1, 2))
print(np.divide(arr1, arr1))
统计函数
| 函数 | 功能说明 | 示例代码 | 示例输出 |
|---|---|---|---|
| np.sum(x) | 求和 | np.sum([[1, 2], [3, 4]]) | 10 |
| np.mean(x) | 计算均值 | np.mean([1, 2, 3, 4]) | 2.5 |
| np.median(x) | 计算中位数 | np.median([5, 2, 3, 1]) | 2.5 |
| np.std(x) | 计算标准差 | np.std([1, 2, 3]) | 0.81649658 |
| np.var(x) | 计算方差 | np.var([1, 2, 3]) | 0.66666667 |
| np.min(x) | 查找最小值 | np.min([[4, 2], [3, 1]]) | 1 |
| np.max(x) | 查找最大值 | np.max([[4, 2], [3, 1]]) | 4 |
| np.percentile(x, q) | 计算分位数(q: 0~100) | np.percentile([1,2,3,4], 50) | 2.5 |
| np.argmax(x) | 返回最大值的索引 | np.argmax([1, 3, 2]) | 1 |
| np.argmin(x) | 返回最小值的索引 | np.argmin([1, 3, 2]) | 0 |
| np.cumsum(x) | 计算累积和(逐元素累加结果) | np.cumsum([1, 2, 3]) | [1, 3, 6] |
| np.cumprod(x) | 计算累积积(逐元素累乘结果) | np.cumprod([1, 2, 3]) | [1, 2, 6] |
多维数组在计算时默认计算全部维度,可以使用axis参数指定按某一维度为轴心统计,axis=0按列统计、axis=1按行统计。
代码演示:
arr1 = np.random.randint(1, 5, (2, 3))
print(arr1)
print(np.mean(arr1))
print(np.sum(arr1))
print(np.max(arr1))
print(np.min(arr1))
print(np.std(arr1))
print(np.var(arr1))
print(np.argmax(arr1))
print(np.argmin(arr1))
print(np.cumsum(arr1))
print(np.cumprod(arr1))
print(np.cumprod(arr1, axis=1))
统计量表
| 统计量名称 | NumPy方法 | 数学定义与解释 | 常见用途 | 图示理解建议(文本) |
|---|---|---|---|---|
| 总和(和) | np.sum() | 所有数值相加的结果 | 总支出、总收入、总分等 | 直方图每列的"高度总和" |
| 计数 | np.size() | 数组中元素的总个数(包括缺失值需额外处理) | 数据规模统计 | 数组的"总格子数" |
| 非零计数 | np.count_nonzero() | 数组中非零元素的数量 | 稀疏矩阵分析、激活单元统计 | 点亮非零元素的网格图 |
| 平均数 | np.mean() | 所有数值的总和 / 个数 | 成绩均值、产品均价 | 数轴上"重心"位置 |
| 加权平均 | np.average(weights=) | Σ(值×权重)/Σ权重 | 加权评分、指数计算 | 不同权重的砝码平衡点 |
| 中位数 | np.median() | 将所有值排序后位于中间位置的值 | 房价中位数、收入中位数 | 数轴上"居中"点 |
| 众数 | scipy.stats.mode() | 出现频率最高的值(需SciPy支持) | 最常见类别、最流行选项 | 柱状图中"最高柱"的位置 |
| 最大值 | np.max() | 数据中的最大元素 | 最高温度、最大销量 | 数轴最右端的点 |
| 最小值 | np.min() | 数据中的最小元素 | 最低成绩、最低价格 | 数轴最左端的点 |
| 极差 | np.ptp() | 最大值与最小值的差(Peak-to-Peak) | 数据波动范围 | 数轴两端点之间的距离 |
| 方差 | np.var() | Σ(值-均值)²/n (ddof=0为总体方差) | 波动性分析、风险评估 | 离均值越远的点→贡献越大 |
| 标准差 | np.std() | 方差的平方根(ddof=0为总体标准差) | 正态分布、偏差分析 | 均值±1个标准差→约68%数据范围 |
| 分位数 | np.quantile() | 将数据分成q比例处的值(如0.25为下四分位数) | 工资等级、考试分数线 | 25%、50%、75%点→形成"箱型图" |
| 百分位数 | np.percentile() | 分位数的百分数表示(quantile(0.25)=percentile(25)) | 统计分布边界 | 标记特定百分比位置的参考线 |
| 协方差矩阵 | np.cov() | 变量间协方差的矩阵表示(每对变量的协方差) | 多元统计分析、PCA | 热力图显示变量间相关性 |
| 相关系数 | np.corrcoef() | 标准化的协方差矩阵,范围[-1,1] | 特征选择、相关分析 | 颜色深浅表示相关性强弱 |
| 直方图统计 | np.histogram() | 将数据划分到等宽区间并计数 | 分布分析、数据分箱 | 柱状图显示各区间的频数 |
| 累积和 | np.cumsum() | 从第一个元素开始逐步累加的结果数组 | 累计收益、增长曲线 | 阶梯式上升的折线图 |
| 累积积 | np.cumprod() | 从第一个元素开始逐步累乘的结果数组 | 复利计算、连乘效应 | 指数增长的曲线 |
| 唯一值 | np.unique() | 返回排序后的唯一值数组(可附加计数) | 类别统计、去重操作 | 彩色圆点图:每种颜色的数量 |
| 排序统计 | np.sort()+索引 | 排序后通过分位数位置获取统计量 | 非参数统计、排名分析 | 有序数轴上的位置标记 |
| 迹(矩阵) | np.trace() | 矩阵主对角线元素的和 | 线性代数运算、矩阵特征 | 矩阵对角线上元素的求和 |
| 范数 | np.linalg.norm() | 向量的模(如L2范数为欧几里得距离) | 相似度计算、正则化 | 向量箭头的长度 |
关键说明:
- 轴方向控制:多数函数支持axis参数(如axis=0列统计,axis=1行统计)
- 缺失值处理:需先用np.nan相关函数(如np.nansum())处理含NaN的数据
- 精度控制:可通过dtype参数指定计算精度(如np.mean(dtype=np.float64))
- 高维扩展:所有统计量均支持高维数组,通过axis元组指定多轴(如axis=(1,2))
比较函数
| 函数 | 功能说明 | 示例代码 | 示例输出 |
|---|---|---|---|
| np.greater(a, b) | 元素级比较 a > b | np.greater([3, 1], [2, 2]) | [True, False] |
| np.less(a, b) | 元素级比较 a < b | np.less([3, 1], [2, 2]) | [False, True] |
| np.equal(a, b) | 元素级比较 a == b | np.equal([1, 2], [1, 3]) | [True, False] |
| np.logical_and(a, b) | 逻辑与(逐元素) | np.logical_and([True, False], [True, True]) | [True, False] |
| np.logical_or(a, b) | 逻辑或(逐元素) | np.logical_or([True, False], [False, False]) | [True, False] |
| np.logical_not(a) | 逻辑非(逐元素) | np.logical_not([True, False]) | [False, True] |
| np.any(a) | 检查数组中是否 至少有一个元素 为 True | np.any([0, 1, 0]) | True |
| np.all(a) | 检查数组中是否 所有元素 为 True | np.all([1, 2, 0]) | False |
| np.where(condition, x, y) | 根据条件选择元素 | np.where([True, False, True], 1, 0) | [1, 0, 1] |
注意事项
- 默认行为:
+ np.any() 和 np.all() 默认对整个数组操作,但可通过 axis 参数按轴计算(如 axis=0 按列检查)。 - 布尔数组处理:
+ 非布尔数组会被隐式转换为布尔值(0 为 False,非零为 True)。 - 空数组处理:
+ np.any([]) 返回 False(无元素满足条件)。
+ np.all([]) 返回 True(所有元素均满足条件,属于逻辑真空情况)。
排序函数
| 函数 | 功能说明 | 示例代码 | 示例输出 |
|---|---|---|---|
| np.sort(x) | 返回排序后的副本 | np.sort([3, 1, 2]) | [1 2 3] |
| x.sort() | 原地排序(修改原数组) | arr = np.array([3,1,2]); arr.sort() | arr 变为 [1, 2, 3] |
| np.argsort(x) | 返回排序后的索引 | np.argsort([3, 1, 2]) | [1, 2, 0] |
| np.lexsort(keys) | 多键排序(按最后一列优先) | np.lexsort(([2,1,3], [3,1,2])) | [1, 0, 2] |
ndarray.sort():就地排序(直接修改原数组)。
axis:指定排序的轴。默认值为 -1,表示沿着最后一个轴进行排序。在二维数组中,axis = 0 表示按列排序,axis = 1 表示按行排序。
在 NumPy 中,轴是对数组维度的一种抽象描述。对于多维数组,每个维度都对应一个轴,轴的编号从 0 开始。对于二维数组,它有两个轴:
- 轴 0:代表垂直方向,也就是行的方向。可以把二维数组想象成一个表格,轴 0 就像是表格中从上到下的行索引方向对列数据排序,所以axis=0表示按列排序。
- 轴 1:代表水平方向,也就是列的方向。就像是表格中从左到右的列索引方向对行数据进行排序,所以axis=1表示按行排序。
代码演示:
import numpy as np
arr1 = np.random.randint(0, 10, (3, 3))
print(arr1)
arr1.sort()
print(arr1)
arr1.sort(axis=0)
print(arr1)
arr1 = np.random.randint(0, 10, (3, 3))
print(arr1)
print(np.sort(arr1))
去重函数
| 函数 | 功能说明 | 示例代码 | 示例输出 |
|---|---|---|---|
| np.unique(x) | 返回唯一值并排序 | np.unique([2, 1, 2, 3, 1]) | [1 2 3] |
| np.in1d(a, b) | 检查 a 的元素是否在 b 中存在 | np.in1d([1, 2, 3], [2, 4]) | [False, True, False] |
np.unique():计算唯一值并返回有序结果。
代码演示:
import numpy as np
arr1 = np.random.randint(0, 5, (3, 3))
print(arr1)
print(np.unique(arr1))
# 运行结果:
# [[0 3 2]
#  [2 2 1]
#  [1 2 3]]
# [0 1 2 3]
其他函数
| 函数 | 功能说明 | 示例代码 | 示例输出 |
|---|---|---|---|
| np.concatenate((a, b)) | 数组拼接 | np.concatenate(([1,2], [3,4])) | [1, 2, 3, 4] |
| np.split(x, indices) | 分割数组 | np.split([1,2,3,4], [2]) | [array([1,2]), array([3,4])] |
| np.reshape(x, shape) | 调整数组形状 | np.reshape([1,2,3,4], (2,2)) | [[1, 2], [3, 4]] |
| np.copy(x) | 创建数组的深拷贝 | b = np.copy(a) | b 与原数组 a 独立 |
| np.isnan(x) | 检测 NaN 值 | np.isnan([1, np.nan, 3]) | [False, True, False] |
Pandas 数据分析
基本介绍
3.1.1 ** Pandas 是什么?**
Pandas 是 Python 数据分析工具链中最核心的库,充当数据读取、清洗、分析、统计、输出的高效工具。
Pandas 是一个开源的数据分析和数据处理库,它是基于 Python 编程语言的。
Pandas 提供了易于使用的数据结构和数据分析工具,特别适用于处理结构化数据,如表格型数据(类似于Excel表格)。
Pandas 是数据科学和分析领域中常用的工具之一,它使得用户能够轻松地从各种数据源中导入数据,并对数据进行高效的操作和分析。
Pandas是基于NumPy构建的专门为处理表格和混杂数据设计的Python库,其核心设计理念包括:
- 标签化数据结构:提供带标签的轴(行索引和列名)
- 灵活处理缺失数据:内置NaN处理机制
- 智能数据对齐:自动按标签对齐数据
- 强大IO工具:支持从CSV、Excel、SQL等20+数据源读写
- 时间序列处理:原生支持日期时间处理和频率转换
名称由来
pandas这个名字源于panel data(面板数据,这是多维结构化数据集在计量经济学中的术语)以及Python data analysis(Python 数据分析)。
pandas兼具numpy高性能的数组计算功能以及电子表格和关系型数据库(如SQL)灵活的数据处理功能。它提供了复杂精细的索引功能,能更加便捷地完成重塑、切片和切块、聚合以及选取数据子集等操作。
pandas 功能
有标签轴的数据结构。在数据结构中,每个轴都被赋予了特定的标签,这些标签用于标识和引用轴上的数据元素,使得数据的组织、访问和操作更加直观和方便
应用场景
| 工具 | 功能特色 | 适用场景 |
|---|---|---|
| Excel | 图形界面,简单上手 | 人工分析、小规模数据 |
| SQL | 高效读写,最终数据源 | 数据库查询和联表 |
| Python + Pandas | 算法和分析部署核心 | 数据清洗,统计分析,可视化等 |
- 与Excel对比:
+ 优势:- 处理百万级数据不卡顿(Excel约100万行限制)
- 可复用的分析流程(脚本 vs 手工操作)
- 支持复杂数据转换(如:分组聚合、时间重采样)
- 局限:
- 可视化交互性较弱
- 学习曲线较陡峭
- 与数据库对比:
+ 优势:- 无需SQL知识即可分析
- 适合探索性分析(即时反馈)
- 丰富的数据清洗函数
- 局限:
- 数据量受内存限制
- 不适合高并发访问
- 与纯Python代码对比:
+ 优势:- 向量化运算比for循环快10-100倍
- 内置统计分析方法(如:相关系数计算)
- 丰富的数据透视功能
- 局限:
- 需要额外学习Pandas API
核心组成如下图:
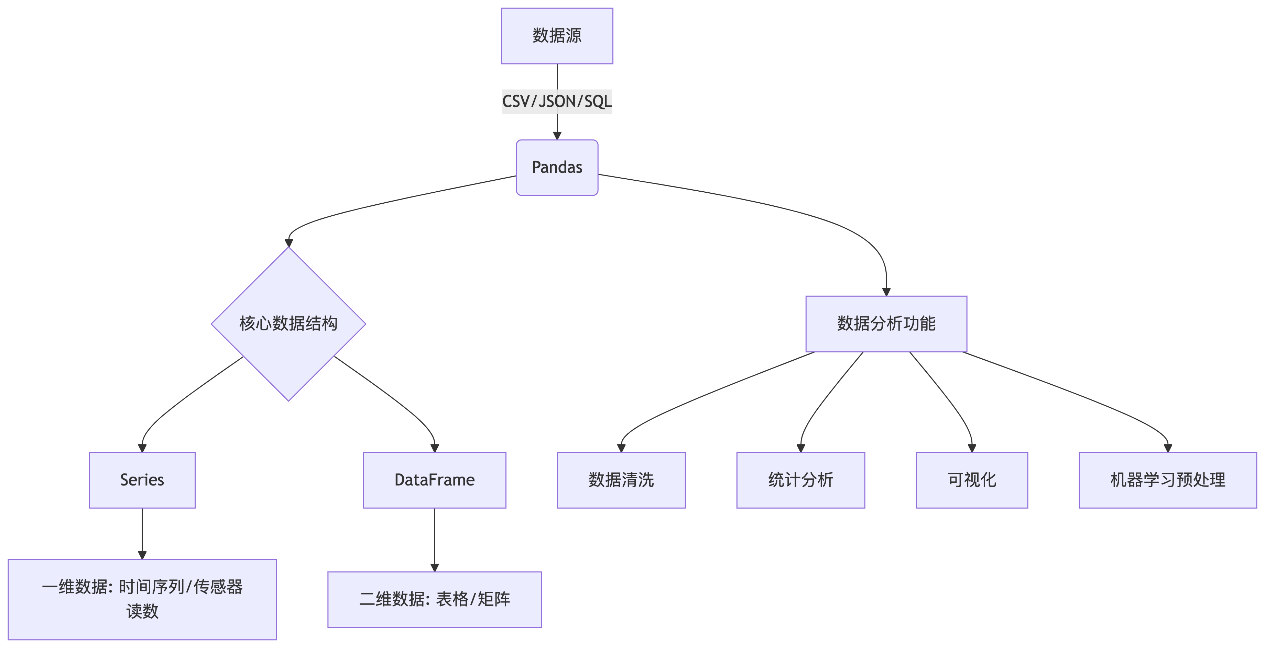
行业洞见:根据2023年Kaggle调查,Pandas是数据科学家使用率最高的工具(占比93%),远超第二名Excel(占比32%)。
核心数据结构:Series 和 DataFrame
Pandas 基于 Numpy,并提供了 2 大核心数据结构:
- Series:一维带有标签的数组
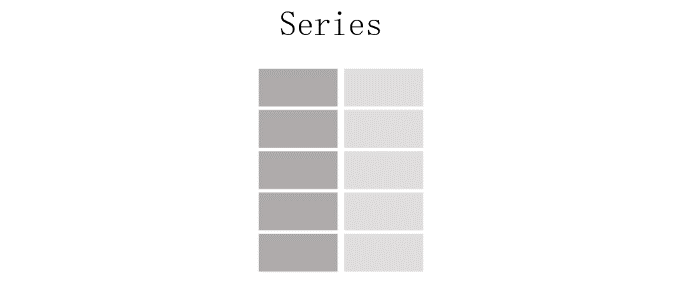
- DataFrame:二维表格结构,可看作多个 Series 的组合
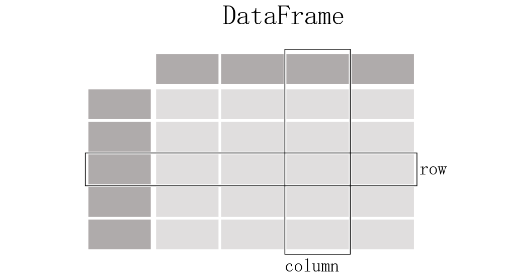
用得最多的pandas对象是 Series,一个一维的标签化数组对象,另一个是 DataFrame,它是一个面向列的二维表结构。
| 特性 | Series | DataFrame |
|---|---|---|
| 维度 | 一维 | 二维 |
| 索引 | 单索引 | 行索引+列名 |
| 数据存储 | 同质化数据类型 | 各列可不同数据类型 |
| 类比 | Excel单列 | 整张Excel工作表 |
| 创建方式 | pd.Series([1,2,3]) | pd.DataFrame({'col':[1,2,3]}) |
Pandas 与 Numpy 的关系与区别:就像学习数学要先掌握算术才能学代数一样,NumPy就是数据分析的"算术基础"。虽然可以直接用计算器(Pandas),但理解底层原理才能走得更远。
Series
创建与访问
什么是 Series
类似于 NumPy 一维数组,但增加了 "标签",可以理解为「一维标签化数组」。
Series 是 Pandas 中的一个核心数据结构,类似于一个一维的数组,具有数据和索引。
Series 可以存储任何数据类型(整数、浮点数、字符串等),并通过标签(索引)来访问元素。Series 的数据结构是非常有用的,因为它可以处理各种数据类型,同时保持了高效的数据操作能力,比如可以通过标签来快速访问和操作数据。
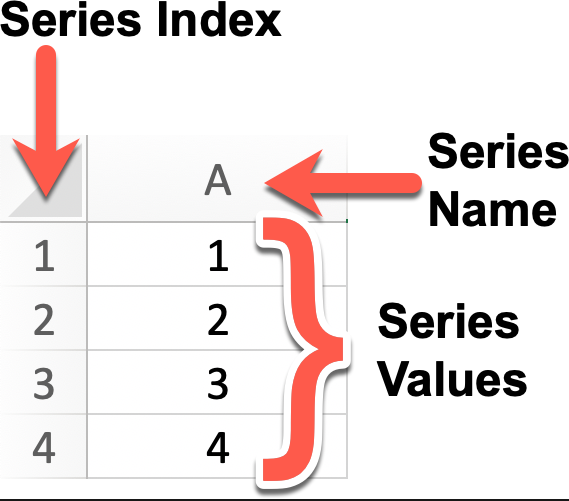
Series 特点:
- 一维数组:Series 中的每个元素都有一个对应的索引值。
- 索引: 每个数据元素都可以通过标签(索引)来访问,默认情况下索引是从 0 开始的整数,但你也可以自定义索引。
- 数据类型: Series 可以容纳不同数据类型的元素,包括整数、浮点数、字符串、Python 对象等。
- 大小不变性:Series 的大小在创建后是不变的,但可以通过某些操作(如 append 或 delete)来改变。
- 操作:Series 支持各种操作,如数学运算、统计分析、字符串处理等。
- 缺失数据:Series 可以包含缺失数据,Pandas 使用NaN(Not a Number)来表示缺失或无值。
- 自动对齐:当对多个 Series 进行运算时,Pandas 会自动根据索引对齐数据,这使得数据处理更加高效。
我们可以使用 Pandas 库来创建一个 Series 对象,并且可以为其指定索引(Index)、名称(Name)以及值(Values):
import pandas as pd
s = pd.Series([10, 20, 30], index=["a", "b", "c"])
print(s)
# a    10
# b    20
# c    30
# dtype: int64
创建 Series
直接通过列表创建Series
import pandas as pd
s = pd.Series([4, 7, -5, 3])print(s)
# 0    4
# 1    7
# 2   -5
# 3    3
# dtype: int64
Series的字符串表现形式为:索引在左边,值在右边。由于我们没有为数据指定索引,于是会自动创建一个 0 到 N-1(N为数据的长度)的整数型索引。
创建方式:
- 通过列表创建 Series 时指定索引
import pandas as pd

s = pd.Series([4, 7, -5, 3], index=["a", "b", "c", "d"])
print(s)
# a    4
# b    7
# c   -5
# d    3
# dtype: int64
- 通过列表创建 Series 时指定索引和名称
import pandas as pd

s = pd.Series([4, 7, -5, 3], index=["a", "b", "c", "d"],name="hello_python")
print(s)
# a    4
# b    7
# c   -5
# d    3
# Name: hello_python, dtype: int6
名称的作用,与变量名的区别
在 Pandas 的 Series 中,name 参数用于给整个 Series 对象赋予一个名称。这个名称有以下几个用途:
-
标识作用:name 可以作为 Series 的标识,类似于给数据列取一个名字。当你打印 Series 时,name 会显示在输出的最下方。
-
DataFrame 列名:如果你将一个 Series 转换成 DataFrame 或与其他 DataFrame 合并,name 会自动成为列名。
- 例如:
import pandas as pd
s = pd.Series([4, 7, -5, 3], index=["a", "b", "c", "d"],name="hello_python")

df = s.to_frame()  # 转换为 DataFrame,列名就是 "hello_python"
print(df)
#     hello_python
# a             4
# b             7
# c            -5
# d             3
-
对齐操作:在 Pandas 运算(如 concat、merge 等)时,name 可以帮助对齐数据。
-
导出数据:将 Series 导出为 CSV 或其他格式时,name 会成为列名。
name 的主要作用是 给 Series 一个标识,方便后续数据处理、合并或导出。如果只是单独使用 Series,name 可能看起来作用不大,但在更复杂的数据操作中(如 DataFrame 整合),它会很有用。
- 直接通过字典创建Series
import pandas as pd

dic = {"a": 4, "b": 7, "c": -5, "d": 3}
s = pd.Series(dic)
print(s)
# a    4
# b    7
# c   -5
# d    3
# dtype: int64
s1 = pd.Series(dic,index=["a","c"],name="aacc")
print(s1)
# a    4
# c   -5
# Name: aacc, dtype: int64
访问数据
以下是 Pandas 中访问 Series 数据的主要方法汇总表格:
| 方法分类 | 语法示例 | 描述 | 返回值 | 是否支持切片/布尔索引 |
|---|---|---|---|---|
| 位置索引 | s.iloc[0] | 通过整数位置访问(从0开始) | 标量值 | 是 |
| s.iloc[1:3] | 位置切片(左闭右开) | Series | ||
| 标签索引 | s.loc['a'] | 通过索引标签访问 | 标量值 | 是 |
| s.loc[['a','b']] | 通过标签列表访问 | Series | ||
| 直接索引 | s[0] | 类似iloc(当索引非整数时可能混淆) | 标量值/Series | 是 |
| s['a'] | 类似loc(优先标签索引) | |||
| 布尔索引 | s[s > 3] | 通过布尔条件筛选 | Series | 是 |
| s[~(s > 3)] | 取反条件 | |||
| 函数访问 | s.at['a'] | 快速访问单个标签(类似loc但效率更高) | 标量值 | 否 |
| s.iat[0] | 快速访问单个位置(类似iloc但效率更高) | |||
| 头部/尾部 | s.head(3) | 访问前N行(默认5) | Series | 否 |
| s.tail(2) | 访问后N行(默认5) | |||
| 取唯一值 | s.unique() | 返回唯一值数组 | ndarray | 否 |
| 值计数 | s.value_counts() | 统计各值出现次数 | Series |
- 优先使用loc/iloc:直接索引[]的行为可能因索引类型不同而变化,明确场景时建议显式使用loc(标签)或iloc(位置)。
- 切片差异:
- loc切片为闭区间(包含两端)
- iloc切片为左闭右开(与Python列表一致)
- 布尔索引:常用于条件过滤,如
s[s > 3 & s < 10]。
代码演示:
import pandas as pd

s = pd.Series([10, 20, 30, 40], index=['a', 'b', 'c', 'd'])
# 位置索引
print(s.iloc[0])  # 10
# 标签访问
print(s["a"])
# 标签索引
print(s.loc['b'])  # 20
# 布尔索引
print(s[s > 25])  # c:30, d:40
# 花式索引
print(s[['a', 'c']])  # a:10, c:30

#使用布尔索引从Series中筛选满足某些条件的值
print("mean:" + str(s.mean())) # 25.0
bools = s > s.mean()
# 将大于平均值的元素标记为 True
print(bools)
# a    False
# b    False
# c     True
# d     True
# dtype: bool
print(s[bools])# b    3.5
# c    6.8
# dtype: float64# 使用where过滤
print(s.where(s > 20, -1))  # 小于等于20的值替换为-1
常用属性
| 属性 | 说明 |
|---|---|
| index | Series的索引对象 |
| values | Series的值 |
| dtype或dtypes | Series的元素类型 |
| shape | Series的形状 |
| ndim | Series的维度 |
| size | Series的元素个数 |
| name | Series的名称 |
| loc[] | 显式索引,按标签索引或切片 |
| iloc[] | 隐式索引,按位置索引或切片 |
| at[] | 使用标签访问单个元素 |
| iat[] | 使用位置访问单个元素 |
代码演示:
import pandas as pd
arrs = pd.Series([11,22,33,44,55],name="atguigu",index=["a","b","c","d","e"])
# print(arrs)
# index Series的索引对象
print(arrs.index)
for i in arrs.index:
    print(i)
    print(arrs.values) # values Series的值
print(arrs.ndim)  # ndim  Series的维度
print(arrs.shape)  # shape Series的形状
print(arrs.size) # size  Series的元素个数
# dtype或dtypes  Series的元素类型
print(arrs.dtype)
print(arrs.dtypes)
# name  Series的名称
print(arrs.name)
# loc[] 显式索引,按标签索引或切片
print(arrs.loc["c"])
print(arrs.loc["c":"d"])
# iloc[]    隐式索引,按位置索引或切片
print(arrs.iloc[0])
print(arrs.iloc[0:3])
# at[]  使用标签访问单个元素
print(arrs.at["a"])
# iat[] 使用位置访问单个元素
print(arrs.iat[3])
Series的运算
import pandas as pd

s1 = pd.Series([1, 2, 3, 4])
s2 = pd.Series([10, 20, 30, 40])
# 基本运算
print(s1 + s2)  # 对应位置相加
print(s1 * 2)   # 标量乘法
常用方法与统计
| 用途分类 | 方法 | 说明 | 示例代码 |
|---|---|---|---|
| 数据预览 | head() | 查看前 n 行数据,默认 5 行 | s.head(3) |
| 数据预览 | tail() | 查看后 n 行数据,默认 5 行 | s.tail(2) |
| 条件判断 | isin() | 判断元素是否包含在参数集合中 | s.isin([1, 2]) |
| 缺失值处理 | isna() | 判断是否为缺失值(如 NaN 或 None) | s.isna() |
| 聚合统计 | sum() | 求和,自动忽略缺失值 | s.sum() |
| 聚合统计 | mean() | 平均值 | s.mean() |
| 聚合统计 | min() | 最小值 | s.min() |
| 聚合统计 | max() | 最大值 | s.max() |
| 聚合统计 | var() | 方差 | s.var() |
| 聚合统计 | std() | 标准差 | s.std() |
| 聚合统计 | median() | 中位数 | s.median() |
| 聚合统计 | mode() | 众数(可返回多个) | s.mode() |
| 聚合统计 | quantile(q) | 分位数,q 取 0~1 之间 | s.quantile(0.25) |
| 聚合统计 | describe() | 常见统计信息(count、mean、std、min、25%、50%、75%、max) | s.describe() |
| 频率统计 | value_counts() | 每个唯一值的出现次数 | s.value_counts() |
| 频率统计 | count() | 非缺失值数量 | s.count() |
| 频率统计 | nunique() | 唯一值个数(去重) | s.nunique() |
| 唯一处理 | unique() | 获取去重后的值数组 | s.unique() |
| 唯一处理 | drop_duplicates() | 去除重复项 | s.drop_duplicates() |
| 抽样分析 | sample() | 随机抽样 | s.sample(2) |
| 排序操作 | sort_index() | 按索引排序 | s.sort_index() |
| 排序操作 | sort_values() | 按值排序 | s.sort_values() |
| 替换值 | replace() | 替换值 | s.replace({1: 100}) |
| 转换结构 | to_frame() | 将 Series 转为 DataFrame | s.to_frame() |
| 比较判断 | equals() | 判断两个 Series 是否完全相等 | s1.equals(s2) |
| 信息提取 | keys() | 返回 Series 的索引对象 | s.keys() |
| 统计关系 | corr() | 计算相关系数(默认皮尔逊) | s1.corr(s2) |
| 统计关系 | cov() | 协方差 | s1.cov(s2) |
| 可视化 | hist() | 绘制直方图(需安装 matplotlib) | s.hist() |
| 遍历操作 | items() | 返回索引和值的迭代器 | for i, v in s.items(): print(i, v) |
代码演示:
import pandas as pd
import numpy as np
arrs = pd.Series([11,22,np.nan,None,44,22],index=['a','b','c','d','e','f'])
# head()    查看前n行数据,默认5行
print(arrs.head())
# tail()    查看后n行数据,默认5行
print(arrs.tail(3))
# describe()    常见统计信息
print(arrs.describe())
# count()   非缺失值元素的个数
print(arrs.count())
# keys()    返回Series的索引对象
print(arrs.index)
print(arrs.keys())
# isin()    判断数组中的每一个元素是否包含在参数集合中
print(arrs.isin([11]))
# isna()    元素是否为缺失值
print(arrs.isna())

#统计# sum() 求和,会忽略 Series 中的缺失值
print(arrs.sum())
# mean()    平均值
print(arrs.mean())
# min() 最小值
print(arrs.min())
# max() 最大值
print(arrs.max())
# var() 方差 每个元素与平均值的差 的平方 的和
print(arrs.var())
# std() 标准差 方差的平方根
print(arrs.std())
# print(arrs.var())
# median()  中位数
# 若数据集的元素个数为奇数,中位数就是排序后位于中间位置的数值。
# 若数据集的元素个数为偶数,中位数则是排序后中间两个数的平均值。
# 去除缺失值之后,arrs 就变成了 [11, 22, 44, 22]。
# 对 [11, 22, 44, 22] 进行排序,得到 [11, 22, 22, 44]
print(arrs.median())
# mode()    众数
print(arrs.mode())
# quantile()    指定位置的分位数,如quantile(0.5)
# 分位数:分位数是把一组数据按照从小到大的顺序排列后,分割成若干等份的数值点。
# 0.25 分位数就是将数据从小到大排序后,位于 25% 位置处的数值。
# 插值方法:当计算分位数时,若位置不是整数,就需要借助插值方法来确定分位数值。# "midpoint" 插值方法是指当分位数位置处于两个数据点之间时,取这两个数据点的
# 平均值作为分位数值。
# 对于有 n个数据点的有序数据集,q分位数的位置 i可以通过公式 i=(n−1)q来计
# 算。这里 n=4,q=0.25,则 i=(4−1)×0.25=0.75。这意味着 0.25 分位数处于第一个# 数据点(值为 11)和第二个数据点(值为 22)之间。使用 "midpoint" 插值方法,
# 分位数值就是这两个数据点的平均值,即 (11+22)÷2=16.5
print(arrs.quantile(0.25, interpolation="midpoint"))

print(len(arrs))
# drop_duplicates() 去重  这里可以看出,底层None也作为NaN处理
print(arrs.drop_duplicates())
# unique()  去重后的数组
print(arrs.unique())
# nunique() 去重后非缺失值元素元素个数
print(arrs.nunique())
# sample()  随机采样
print(arrs.sample())
# value_counts()    每个元素的个数
print(arrs.value_counts())
# sort_index()  按索引排序
print(arrs.sort_index())
# sort_values() 按值排序
print(arrs.sort_values())
# replace() 用指定值代替原有值
print(arrs.replace(22,"haha"))
# to_frame()    将Series转换为DataFrame
print(arrs.to_frame())
# equals()  判断两个Series是否相同
arr1 = pd.Series([1,2,3])
arr2 = pd.Series([1,2,3])
print(arr1.equals(arr2))
# corr()    计算与另一个Series的相关系数
# arr1.corr(arr2):由于 arr1 和 arr2 的值完全相同,它们之间是完全正相关的,
#因此相关系数为 1。
# arr1.corr(arr3):arr1 的值是递增的,而 arr3 的值是递减的,它们之间是完全
# 负相关的,所以相关系数为 -1。
# arr1.corr(arr4):arr1 和 arr4 的值都是递增的,且变化趋势一致,它们之间是
# 完全正相关的,相关系数为 1。
# arr5.corr(arr6):arr5 和 arr6 的值之间没有明显的线性关系,它们的相关系数
# 为 0。
arr3 = pd.Series([3,2,1])
arr4 = pd.Series([6,7,8])
arr5 = pd.Series([1, -1, 1, -1])
arr6 = pd.Series([1, 1, -1, -1])
print(arr1.corr(arr2))
print(arr1.corr(arr3))
print(arr1.corr(arr4))
print(arr5.corr(arr6))
# cov() 计算与另一个Series的协方差
# 协方差用于衡量两个变量的总体误差,其值的正负表示两个变量的变化方向关系:
# 正值表示同向变化,负值表示反向变化。
print(arr1.cov(arr3))
案例练习
- 学生成绩统计:创建一个包含10名学生数学成绩的Series,成绩范围在50-100之间。计算平均分、最高分、最低分,并找出高于平均分的学生人数。
import pandas as pd
import numpy as np

# 生成随机成绩
np.random.seed(42)
scores = pd.Series(np.random.randint(50, 101, 10),
                  index=['学生'+str(i) for i in range(1, 11)])

# 计算统计量
mean_score = scores.mean()
max_score = scores.max()
min_score = scores.min()
above_avg = scores[scores > mean_score].count()

print(f"平均分: {mean_score:.1f}")
print(f"最高分: {max_score}")
print(f"最低分: {min_score}")
print(f"高于平均分的学生人数: {above_avg}")
- 温度数据分析:给定某城市一周每天的最高温度Series,完成任务:找出温度超过30度的天数,计算平均温度,将温度从高到低排序,找出温度变化最大的两天。
import pandas as pd
import numpy as np
temperatures = pd.Series([28, 31, 29, 32, 30, 27, 33],
                         index=['周一', '周二', '周三', '周四', '周五', '周六', '周日'])

# 1. 找出温度超过30度的天数
hot_days = temperatures[temperatures > 30].count()

# 2. 计算平均温度
avg_temp = temperatures.mean()

# 3. 将温度从高到低排序
sorted_temp = temperatures.sort_values(ascending=False)

# 4. 找出温度变化最大的两天
temp_diff = temperatures.diff().abs()
max_diff_days = temp_diff.nlargest(2).index.tolist()

print(f"超过30度的天数: {hot_days}")
print(f"平均温度: {avg_temp:.1f}")
print("温度排序:\n", sorted_temp)
print(f"温度变化最大的两天: {max_diff_days}")
- 股票价格分析:给定某股票连续10个交易日的收盘价Series:计算每日收益率(当日收盘价/前日收盘价 - 1),找出收益率最高和最低的日期,计算波动率(收益率的标准差)。
import pandas as pd
import numpy as np
prices = pd.Series([102.3, 103.5, 105.1, 104.8, 106.2, 107.0, 106.5, 108.1, 109.3, 110.2],
                  index=pd.date_range('2023-01-01', periods=10))

# 1. 计算每日收益率
returns = prices.pct_change()

# 2. 找出收益率最高和最低的日期
max_return_date = returns.idxmax()
min_return_date = returns.idxmin()

# 3. 计算波动率
volatility = returns.std()

print("每日收益率:\n", returns)
print(f"收益率最高的日期: {max_return_date}")
print(f"收益率最低的日期: {min_return_date}")
print(f"波动率: {volatility:.4f}")
- 销售数据分析:某产品过去12个月的销售量Series:计算季度平均销量(每3个月为一个季度),找出销量最高的月份,计算月环比增长率,找出连续增长超过2个月的月份
import pandas as pd
import numpy as np
sales = pd.Series([120, 135, 145, 160, 155, 170, 180, 175, 190, 200, 210, 220],
                 index=pd.date_range('2022-01-01', periods=12, freq='M'))

# 1. 计算季度平均销量
quarterly_avg = sales.resample('Q').mean()

# 2. 找出销量最高的月份
max_sales_month = sales.idxmax()

# 3. 计算月环比增长率
mom_growth = sales.pct_change()

# 4. 找出连续增长超过2个月的月份
growth_mask = mom_growth > 0
consecutive_growth = growth_mask.rolling(3).sum() >= 2
growth_months = sales[consecutive_growth].index

print("季度平均销量:\n", quarterly_avg)
print(f"销量最高的月份: {max_sales_month}")
print("月环比增长率:\n", mom_growth)
print("连续增长超过2个月的月份:", growth_months.tolist())
- 常用频率别名(rule 参数)
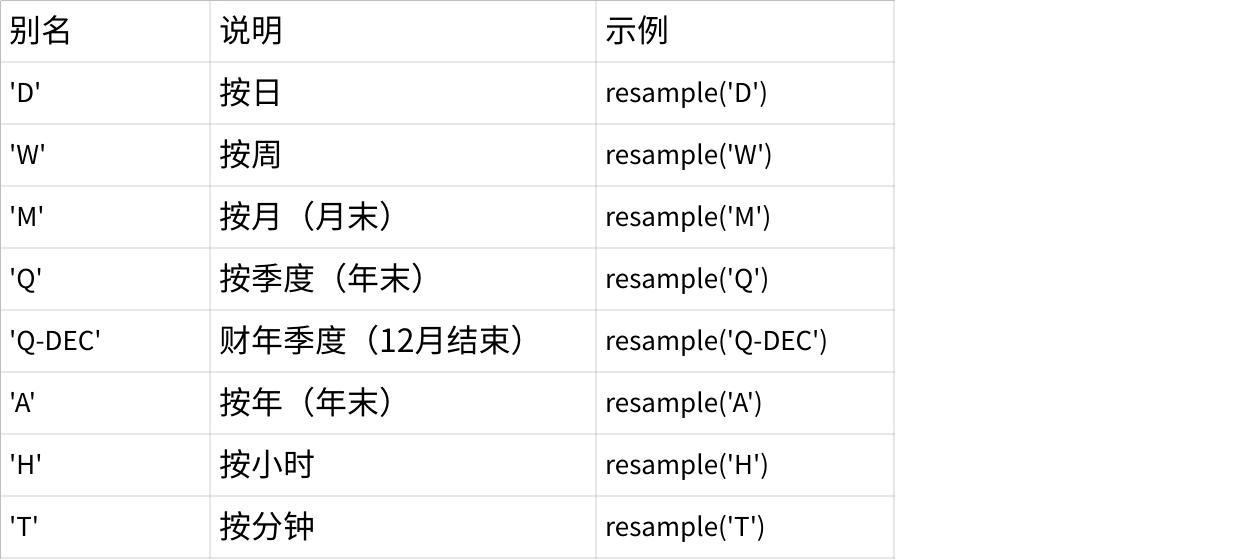
- 数据合并与计算:有两个Series分别记录了某产品在两个城市的日销量:计算两个城市的总日销量,找出哪个城市的销量更高,计算两个城市销量的相关系数。
import pandas as pd
import numpy as np
city_a = pd.Series([120, 135, 140, 130, 145],
                  index=pd.date_range('2023-01-01', periods=5))
city_b = pd.Series([110, 125, 150, 140, 130],
                  index=pd.date_range('2023-01-01', periods=5))

# 1. 计算两个城市的总日销量
total_sales = city_a + city_b

# 2. 找出哪个城市的销量更高
city_a_total = city_a.sum()
city_b_total = city_b.sum()
higher_sales_city = 'A' if city_a_total > city_b_total else 'B'

# 3. 计算两个城市销量的相关系数
correlation = city_a.corr(city_b)

print("总日销量:\n", total_sales)
print(f"总销量更高的城市: {higher_sales_city}")
print(f"两个城市销量的相关系数: {correlation:.2f}")
DataFrame
创建与访问
什么是 DataFrame?
DataFrame 是 Pandas 中的核心数据结构之一,多行多列表格数据,类似于 Excel 表格 或 SQL 查询结果。
它是一个 二维表格结构,具有行索引(index)和列标签(columns)。
df = pd.DataFrame({
    "name": ["Alice", "Bob"],
    "score": [90, 80]
})
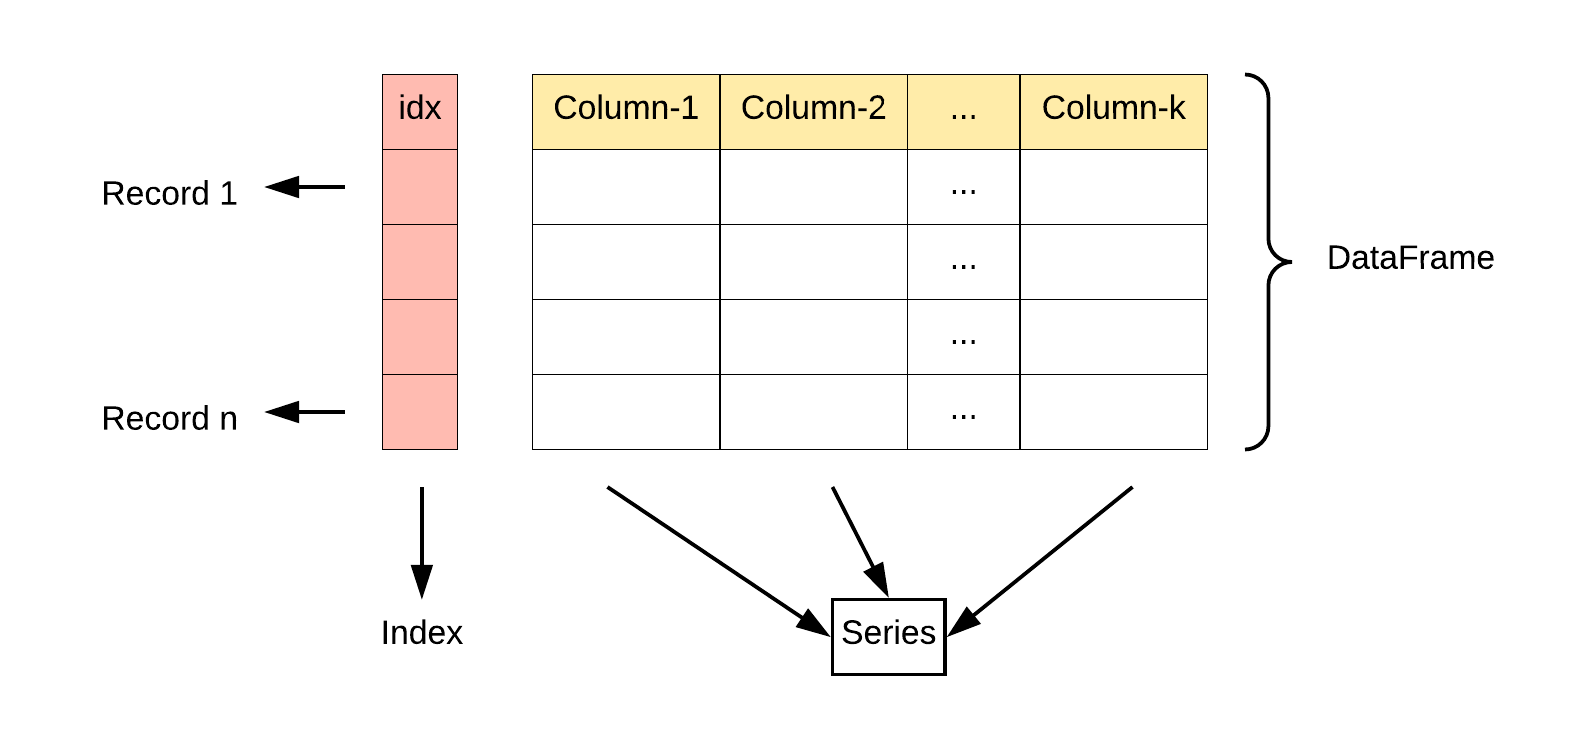
DataFrame中的数据是以一个或多个二维块存放的(而不是列表、字典或别的一维数据结构)。它可以被看做由Series组成的字典(共同用一个索引)。提供了各种功能来进行数据访问、筛选、分割、合并、重塑、聚合以及转换等操作,广泛用于数据分析、清洗、转换、可视化等任务。
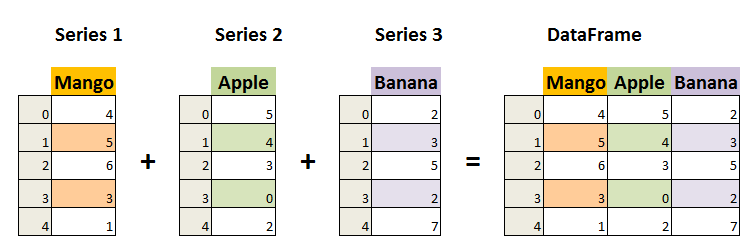
创建方式:
- 通过series来创建
#
import pandas as pd
import numpy as np
np.random.seed(42)
s1 = pd.Series(np.random.randint(0,10,6))
np.random.seed(41)
s2 = pd.Series(np.random.randint(0,20,6))
df = pd.DataFrame({"s1":s1,"s2":s2})
- 直接通过字典创建DataFrame:
import pandas as pd
df = pd.DataFrame({"name": ["Alice", "Bob"],"score": [90, 80]})
print(df)
df = pd.DataFrame({"id": [101, 102, 103], "name": ["张三", "李四", "王五"], "age": [20, 30, 40]})
print(df)
#     id name  age
# 0  101   张三   20
# 1  102   李四   30
# 2  103   王五   40
- 通过字典创建时指定列的顺序和行索引
df = pd.DataFrame(
    data={"age": [20, 30, 40],
    "name": ["张三", "李四", "王五"]},
    columns=["name", "age"], index=[101, 102, 103]
)
print(df)
#     name  age
# 101   张三   20
# 102   李四   30
# 103   王五   40
访问方式
| 方法分类 | 语法示例 | 描述 | 返回值类型 | 是否支持切片/条件索引 |
|---|---|---|---|---|
| 列选择 | df['col'] | 选择单列(返回Series) | Series | ❌ |
| df[['col1', 'col2']] | 选择多列(返回DataFrame) | DataFrame | ||
| 行选择 | df.loc[row_label] | 通过行标签选择单行(返回Series) | Series | ✅(标签切片) |
| df.loc[start:end] | 通过标签切片选择多行(闭区间) | DataFrame | ||
| df.iloc[row_index] | 通过行位置选择单行(从0开始) | Series | ✅(位置切片) | |
| df.iloc[start:end] | 通过位置切片选择多行(左闭右开) | DataFrame | ||
| 行列组合选择 | df.loc[row_labels, col_labels] | 通过标签选择行和列(如df.loc['a':'b', ['col1','col2']]) | Series/DataFrame | ✅ |
| df.iloc[row_idx, col_idx] | 通过位置选择行和列(如df.iloc[0:2, [1,3]]) | Series/DataFrame | ||
| 条件筛选 | df[df['col'] > 3] | 通过布尔条件筛选行 | DataFrame | ✅ |
| df.query("col1 > 3 & col2 < 10") | 使用表达式筛选(需字符串表达式) | DataFrame | ||
| 快速访问 | df.at[row_label, 'col'] | 快速访问单个值(标签索引,高效) | 标量值 | ❌ |
| df.iat[row_idx, col_idx] | 快速访问单个值(位置索引,高效) | 标量值 | ||
| 头部/尾部 | df.head(n) | 返回前n行(默认5) | DataFrame | ❌ |
| df.tail(n) | 返回后n行(默认5) | DataFrame | ||
| 样本抽样 | df.sample(n=3) | 随机抽取n行 | DataFrame | |
| 索引重置 | df.reset_index() | 重置索引(原索引变为列) | DataFrame | |
| 设置索引 | df.set_index('col') | 指定某列作为新索引 | DataFrame |
- loc vs iloc
- loc:基于标签(index/column names),切片为闭区间(如
df.loc['a':'c']包含'c')。 - iloc:基于整数位置(从0开始),切片为左闭右开(如
df.iloc[0:2]不包含索引2)。
- loc:基于标签(index/column names),切片为闭区间(如
- 布尔条件筛选
- 支持组合条件(需用
&、|,并用括号分隔条件):
- 支持组合条件(需用
df[(df['col1'] > 3) & (df['col2'] == 'A')]
- at/iat vs loc/iloc
- at/iat:仅用于访问单个值,速度更快。
- loc/iloc:支持多行/列选择,功能更灵活。
代码演示:
- 获取一列数据
# 访问数据
print(df['name'])  #访问某列数据
print(df.score)
 # df["col"] / df.col
df["name"]       # 返回 Series
df.name
df[["name"]]     # 返回 DataFrame
- 获取多列数据
df[["date", "temp_max", "temp_min"]] # 获取多列数据print(df[['name','score']]) # 访问多列数据
- 获取行数据
+ loc:通过行标签获取数据
df.loc[1]  # 获取行标签为1的数据
df.loc[[1, 10, 100]]  # 获取行标签分别为1、10、100的数据
- iloc:通过行位置获取数据
df.iloc[0]  # 获取行位置为0的数据
df.iloc[-1]  # 获取行位置为最后一位的数据
- 获取指定单元格
df.loc[101, "name"]    # 标签访问
df.iloc[0, 1]          # 位置访问df.loc[1, "precipitation"]  # 获取行标签为1,列标签为precipitation的数据
df.loc[:, "precipitation"]  # 获取所有行,列标签为precipitation的数据
df.iloc[:, [3, 5, -1]]  # 获取所有行,列位置为3,5,最后一位的数据
df.iloc[:10, 2:6]  # 获取前10行,列位置为2、3、4、5的数据
df.loc[:10, ["date", "precipitation", "temp_max", "temp_min"]]  # 通过行列标签获取数据
- 查看部分数据
+ 通过head()、tail()获取前n行或后n行
print(df.head())print(df.tail(10))
- 使用布尔索引筛选数据
# 条件筛选
df['score']>70
print(df[df.score>70])
print(df[(df['score']>70) & (df['age']<20)])# 随机抽样
df.sample(2)
常用属性
| 属性 | 说明 |
|---|---|
| index | DataFrame的行索引 |
| columns | DataFrame的列标签 |
| values | DataFrame的值 |
| ndim | DataFrame的维度 |
| shape | DataFrame的形状 |
| size | DataFrame的元素个数 |
| dtypes | DataFrame的元素类型 |
| T | 行列转置 |
| loc[] | 显式索引,按行列标签索引或切片 |
| iloc[] | 隐式索引,按行列位置索引或切片 |
| at[] | 使用行列标签访问单个元素 |
| iat[] | 使用行列位置访问单个元素 |
代码演示:
import pandas as pd
df = pd.DataFrame(data={"id": [101, 102, 103], "name": ["张三", "李四", "王五"], "age": [20, 30, 40]},index=["aa", "bb", "cc"])# index DataFrame的行索引
print(df.index)
# columns   DataFrame的列标签
print(df.columns
     )# values    DataFrame的值
print(df.values)
# ndim  DataFrame的维度
print(df.ndim)
# shape DataFrame的形状
print(df.shape)
# size  DataFrame的元素个数
print(df.size)
# dtypes    DataFrame的元素类型
print(df.dtypes)
# T 行列转置
print(df.T)
# loc[] 显式索引,按行列标签索引或切片 逗号前是行切片规则,后是列切片规则
print(df.loc["aa":"cc"])
print(df.loc[:,["id","name"]])
# iloc[]    隐式索引,按行列位置索引或切片
print(df.iloc[0:1])
print(df.iloc[0:3,2])
print("----------")
# at[]  使用行列标签访问单个元素
print(df.at["aa","name"])
# iat[] 使用行列位置访问单个元素
print(df.iat[0,1])
常用方法与统计
| 方法 | 说明 |
|---|---|
| head() | 查看前n行数据,默认5行 |
| tail() | 查看后n行数据,默认5行 |
| isin() | 元素是否包含在参数集合中 |
| isna() | 元素是否为缺失值 |
| sum() | 求和 |
| mean() | 平均值 |
| min() | 最小值 |
| max() | 最大值 |
| var() | 方差 |
| std() | 标准差 |
| median() | 中位数 |
| mode() | 众数 |
| quantile() | 指定位置的分位数,如quantile(0.5) |
| describe() | 常见统计信息 |
| info() | 基本信息 |
| value_counts() | 每个元素的个数 |
| count() | 非空元素的个数 |
| drop_duplicates() | 去重 |
| sample() | 随机采样 |
| replace() | 用指定值代替原有值 |
| equals() | 判断两个DataFrame是否相同 |
| cummax() | 累计最大值 |
| cummin() | 累计最小值 |
| cumsum() | 累计和 |
| cumprod() | 累计积 |
| diff() | 一阶差分,对序列中的元素进行差分运算,也就是用当前元素减去前一个元素得到差值,默认情况下,它会计算一阶差分,即相邻元素之间的差值。参数: periods:整数,默认为 1。表示要向前或向后移动的周期数,用于计算差值。正数表示向前移动,负数表示向后移动。 axis:指定计算的轴方向。0 或 'index' 表示按列计算,1 或 'columns' 表示按行计算,默认值为 0。 |
| sort_index() | 按行索引排序 |
| sort_values() | 按某列的值排序,可传入列表来按多列排序,并通过ascending参数设置升序或降序 |
| nlargest() | 返回某列最大的n条数据 |
| nsmallest() | 返回某列最小的n条数据 |
代码演示:
import pandas as pd
from typing import Any, Optional

def create_dataframe() -> pd.DataFrame:
    """
    创建一个包含 id、name 和 age 列的 DataFrame。

    Returns:
        pd.DataFrame: 包含示例数据的 DataFrame。
    """
    data = {
        "id": [101, 102, 103, 104, 105, 106, 101],
        "name": ["张三", "李四", "王五", "赵六", "冯七", "周八", "张三"],
        "age": [10, 20, 30, 40, None, 60, 10]
    }
    index = ["aa", "bb", "cc", "dd", "ee", "ff", "aa"]
    return pd.DataFrame(data, index=index)

def print_statistics(df: pd.DataFrame) -> None:
    """
    打印 DataFrame 的基本统计信息。

    Args:
        df (pd.DataFrame): 输入的 DataFrame。
    """
    print("=== 前几行数据 ===")
    print(df.head())

    print("\n=== 后几行数据 ===")
    print(df.tail())

    print("\n=== 检查元素是否存在于指定集合中 ===")
    print(df.isin([103, 106]))

    print("\n=== 检查缺失值 ===")
    print(df.isna())

    print("\n=== 年龄列的总和 ===")
    print(df["age"].sum())

    print("\n=== 年龄列的平均值 ===")
    print(df["age"].mean())

    print("\n=== 年龄列的最小值 ===")
    print(df["age"].min())

    print("\n=== 年龄列的最大值 ===")
    print(df["age"].max())

    print("\n=== 年龄列的方差 ===")
    print(df["age"].var())

    print("\n=== 年龄列的标准差 ===")
    print(df["age"].std())

    print("\n=== 年龄列的中位数 ===")
    print(df["age"].median())

    print("\n=== 年龄列的众数 ===")
    print(df["age"].mode())

    print("\n=== 年龄列的中位数(分位数 0.5) ===")
    print(df["age"].quantile(0.5))

    print("\n=== 数据的基本统计信息 ===")
    print(df.describe())

    print("\n=== 数据基本信息 ===")
    print(df.info())

    print("\n=== 每个元素的出现次数 ===")
    print(df.value_counts())

    print("\n=== 非空元素的个数 ===")
    print(df.count())

    print("\n=== 是否有重复行(按 age 列)===\n")
    print(df.duplicated(subset="age"))

    print("\n=== 随机采样一行 ===")
    print(df.sample())

    print("\n=== 替换特定值 ===")
    print(df.replace(20, "haha"))

    print("\n=== 累计最大值(按行)===\n")
    df3 = pd.DataFrame({'A': [2, 5, 3, 7, 4], 'B': [1, 6, 2, 8, 3]})
    print(df3.cummax(axis="columns"))

    print("\n=== 累计最小值 ===")
    print(df3.cummin())

    print("\n=== 累计和 ===")
    print(df3.cumsum())

    print("\n=== 累计积 ===")
    print(df3.cumprod())

    print("\n=== 一阶差分 ===")
    print(df3.diff())

    print("\n=== 按行索引排序 ===")
    print(df.sort_index())

    print("\n=== 按年龄列排序 ===")
    print(df.sort_values(by="age"))

    print("\n=== 年龄最大的两行 ===")
    print(df.nlargest(n=2, columns="age"))

    print("\n=== 年龄最小的一行 ===")
    print(df.nsmallest(n=1, columns="age"))

if __name__ == "__main__":
    dataframe = create_dataframe()
    print_statistics(dataframe)
在Pandas的 DataFrame 方法里,axis 是一个非常重要的参数,它用于指定操作的方向。
axis 参数可以取两个主要的值,即 0 或 'index',以及 1 或 'columns' ,其含义如下:
axis=0或axis='index':表示操作沿着行的方向进行,也就是对每一列的数据进行处理。例如,当计算每列的均值时,就是对每列中的所有行数据进行计算。axis=1或axis='columns':表示操作沿着列的方向进行,也就是对每行的数据进行处理。例如,当计算每行的总和时,就是对每行中的所有列数据进行计算。
标量运算
标量与每个元素进行计算。
代码演示:
import pandas as pd

df = pd.DataFrame(data={"age": [20, 30, 40, 10], "name": ["张三", "李四", "王五", "赵六"]},
    columns=["name", "age"],
    index=[101, 104, 103, 102],
)
print(df * 2)
#      name     age
# 101  张三张三   40
# 104  李四李四   60
# 103  王五王五   80
# 102  赵六赵六   20
df1 = pd.DataFrame(
    data={"age": [10, 20, 30, 40], "name": ["张三", "李四", "王五", "赵六"]},
    columns=["name", "age"],
    index=[101, 102, 103, 104],
)
df2 = pd.DataFrame(
    data={"age": [10, 20, 30, 40], "name": ["张三", "李四", "王五", "田七"]},
    columns=["name", "age"],
    index=[102, 103, 104, 105],
)
print(df1 + df2)#      name   age
# 101   NaN   NaN
# 102  李四张三  30.0
# 103  王五李四  50.0
# 104  赵六王五  70.0
# 105   NaN   NaN
案例练习
案例1:学生成绩分析
场景:某班级的学生成绩数据如下,请完成以下任务:
- 计算每位学生的总分和平均分。
- 找出数学成绩高于90分或英语成绩高于85分的学生。
- 按总分从高到低排序,并输出前3名学生。
import pandas as pd

data = {
    '姓名': ['张三', '李四', '王五', '赵六', '钱七'],
    '数学': [85, 92, 78, 88, 95],
    '英语': [90, 88, 85, 92, 80],
    '物理': [75, 80, 88, 85, 90]
}
df = pd.DataFrame(data)

# 1. 计算总分和平均分
df['总分'] = df[['数学', '英语', '物理']].sum(axis=1)
df['平均分'] = df['总分'] / 3

# 2. 找出数学>90或英语>85的学生
high_scores = df[(df['数学'] > 90) | (df['英语'] > 85)]

# 3. 按总分排序并输出前3名
top3 = df.sort_values('总分', ascending=False).head(3)

print("总分和平均分:\n", df)
print("\n数学>90或英语>85的学生:\n", high_scores)
print("\n总分前3名学生:\n", top3)
案例2:销售数据分析
场景:某公司销售数据如下,请完成以下任务:
- 计算每种产品的总销售额(销售额 = 单价 × 销量)。
- 找出销售额最高的产品。
- 按销售额从高到低排序,并输出所有产品信息。
import pandas as pd

data = {
    '产品名称': ['A', 'B', 'C', 'D'],
    '单价': [100, 150, 200, 120],
    '销量': [50, 30, 20, 40]
}
df = pd.DataFrame(data)

# 1. 计算总销售额
df['销售额'] = df['单价'] * df['销量']

# 2. 找出销售额最高的产品
max_sales = df[df['销售额'] == df['销售额'].max()]

# 3. 按销售额排序
sorted_df = df.sort_values('销售额', ascending=False)

print("销售额计算:\n", df)
print("\n销售额最高的产品:\n", max_sales)
print("\n按销售额排序:\n", sorted_df)
案例3:员工考勤统计
场景:某部门员工考勤数据如下,请完成以下任务:
- 计算每位员工的出勤率(出勤率 = 出勤天数 / 工作日总数)。
- 标记出勤率低于80%的员工。
- 按出勤率从高到低排序。
import pandas as pd

data = {
    '姓名': ['张三', '李四', '王五', '赵六'],
    '出勤天数': [20, 15, 18, 22],
    '工作日总数': [25, 20, 25, 25]
}
df = pd.DataFrame(data)

# 1. 计算出勤率
df['出勤率'] = (df['出勤天数'] / df['工作日总数']).round(2)

# 2. 标记出勤率<80%的员工
df['需关注'] = df['出勤率'] < 0.8

# 3. 按出勤率排序
sorted_df = df.sort_values('出勤率', ascending=False)

print("出勤率统计:\n", df)
print("\n出勤率排序:\n", sorted_df)
案例4:电影评分分析
场景:某电影评分数据如下,请完成以下任务:
- 计算每部电影的平均评分。
- 找出评分高于8.5的电影。
- 按平均评分从高到低排序。
import pandas as pd

data = {
    '电影名称': ['电影A', '电影B', '电影C', '电影D'],
    '评分1': [9.0, 8.5, 8.0, 7.5],
    '评分2': [8.5, 9.0, 8.5, 8.0],
    '评分3': [9.5, 8.0, 7.5, 7.0]
}
df = pd.DataFrame(data)

# 1. 计算平均评分
df['平均评分'] = df[['评分1', '评分2', '评分3']].mean(axis=1).round(2)

# 2. 找出评分>8.5的电影
high_rated = df[df['平均评分'] > 8.5]

# 3. 按平均评分排序
sorted_df = df.sort_values('平均评分', ascending=False)

print("平均评分:\n", df)
print("\n评分>8.5的电影:\n", high_rated)
print("\n按评分排序:\n", sorted_df)
案例5:股票价格分析
场景:某股票价格数据如下,请完成以下任务:
- 计算每日股价的涨跌幅(涨跌幅 = (当日收盘价 - 前一日收盘价) / 前一日收盘价)。
- 找出涨幅超过5%的日期。
- 按日期排序,并输出涨跌幅最高的日期。
import pandas as pd

data = {
    '日期': ['2023-01-01', '2023-01-02', '2023-01-03', '2023-01-04'],
    '收盘价': [100, 105, 110, 102]
}
df = pd.DataFrame(data)
df['日期'] = pd.to_datetime(df['日期'])

# 1. 计算涨跌幅
df['涨跌幅'] = df['收盘价'].pct_change().round(4)

# 2. 找出涨幅>5%的日期
high_increase = df[df['涨跌幅'] > 0.05]

# 3. 按日期排序并输出最高涨跌幅日期
sorted_df = df.sort_values('日期')
max_increase_date = df.loc[df['涨跌幅'].idxmax(), '日期']

print("涨跌幅计算:\n", df)
print("\n涨幅>5%的日期:\n", high_increase)
print("\n涨跌幅最高的日期:\n", max_increase_date)
案例 6:电商用户行为分析(基础版)
场景:某电商平台的用户行为数据如下,请完成以下任务:
- 计算每位用户的总消费金额(消费金额 = 商品单价 × 购买数量)
- 找出消费金额最高的用户,并输出其所有信息
- 计算所有用户的平均消费金额(保留2位小数)
- 统计电子产品的总购买数量
import pandas as pd

data = {
    '用户ID': [101, 102, 103, 104, 105],
    '用户名': ['Alice', 'Bob', 'Charlie', 'David', 'Eve'],
    '商品类别': ['电子产品', '服饰', '电子产品', '家居', '服饰'],
    '商品单价': [1200, 300, 800, 150, 200],
    '购买数量': [1, 3, 2, 5, 4]
}
df = pd.DataFrame(data)

# 1. 计算总消费金额
df['消费金额'] = df['商品单价'] * df['购买数量']

# 2. 找出消费金额最高的用户
max_spend_user = df[df['消费金额'] == df['消费金额'].max()]

# 3. 计算平均消费金额
avg_spend = round(df['消费金额'].mean(), 2)

# 4. 统计电子产品的总购买数量
electronic_total = df[df['商品类别'] == '电子产品']['购买数量'].sum()

print("用户消费分析:\n", df)
print("\n消费金额最高的用户:\n", max_spend_user)
print("\n平均消费金额:", avg_spend)
print("电子产品总购买数量:", electronic_total)
输出示例:
用户消费分析:
    用户ID     用户名  商品类别  商品单价  购买数量  消费金额
0   101    Alice  电子产品   1200       1   1200
1   102      Bob     服饰    300       3    900
2   103  Charlie  电子产品    800       2   1600
3   104    David     家居    150       5    750
4   105      Eve     服饰    200       4    800

消费金额最高的用户:
    用户ID     用户名  商品类别  商品单价  购买数量  消费金额
2   103  Charlie  电子产品    800       2   1600

平均消费金额: 1050.0
电子产品总购买数量: 3
数据的导入与导出
导出数据
| 方法 | 说明 |
|---|---|
| to_csv() | 将数据保存为csv格式文件,数据之间以逗号分隔,可通过sep参数设置使用其他分隔符,可通过index参数设置是否保存行标签,可通过header参数设置是否保存列标签。 |
| to_pickle() | 如要保存的对象是计算的中间结果,或者保存的对象以后会在Python中复用,可把对象保存为.pickle文件。如果保存成pickle文件,只能在python中使用。文件的扩展名可以是.p、.pkl、.pickle。 |
| to_excel() | 保存为Excel文件,需安装openpyxl包。 |
| to_clipboard() | 保存到剪切板。 |
| to_dict() | 保存为字典。 |
| to_hdf() | 保存为HDF格式,需安装tables包。 |
| to_html() | 保存为HTML格式,需安装lxml、html5lib、beautifulsoup4包。 |
| to_json() | 保存为JSON格式。 |
| to_feather() | feather是一种文件格式,用于存储二进制对象。feather对象也可以加载到R语言中使用。feather格式的主要优点是在Python和R语言之间的读写速度要比csv文件快。feather数据格式通常只用中间数据格式,用于Python和R之间传递数据,一般不用做保存最终数据。需安装pyarrow包。 |
| to_sql() | 保存到数据库。 |
代码演示:
import os
import pandas as pd
os.makedirs("data", exist_ok=True)
df = pd.DataFrame({"age": [20, 30, 40, 10], "name": ["张三", "李四", "王五", "赵六"], "id": [101, 102, 103, 104]})
df.set_index("id", inplace=True)
df.to_csv("data/df.csv")
df.to_csv("data/df.tsv", sep="\t")  # 设置分隔符为 \t
df.to_csv("data/df_noindex.csv", index=False)  # index=False 不保存行索引
df.to_pickle("data/df.pkl")
df.to_excel("data/df.xlsx")
df.to_clipboard()
df_dict = df.to_dict()
df.to_hdf("data/df.h5", key="df")
df.to_html("data/df.html")
df.to_json("data/df.json")
df.to_feather("data/df.feather")
导入数据
| 方法 | 说明 |
|---|---|
| read_csv() | 加载csv格式的数据。可通过sep参数指定分隔符,可通过index_col参数指定行索引。 |
| read_pickle() | 加载pickle格式的数据。 |
| read_excel() | 加载Excel格式的数据。 |
| read_clipboard() | 加载剪切板中的数据。 |
| read_hdf() | 加载HDF格式的数据。 |
| read_html() | 加载HTML格式的数据。 |
| read_json() | 加载JSON格式的数据。 |
| read_feather() | 加载feather格式的数据。 |
| read_sql() | 加载数据库中的数据。 |
代码演示:
import os
import pandas as pd
df_csv = pd.read_csv("data/df.csv", index_col="id")  # 指定行索引
df_tsv = pd.read_csv("data/df.tsv", sep="\t")  # 指定分隔符
df_pkl = pd.read_pickle("data/df.pkl")
df_excel = pd.read_excel("data/df.xlsx", index_col="id")
df_clipboard = pd.read_clipboard(index_col="id")
df_from_dict = pd.DataFrame(df_dict)
df_hdf = pd.read_hdf("data/df.h5", key="df")
df_html = pd.read_html("data/df.html", index_col=0)[0]
df_json = pd.read_json("data/df.json")
df_feather = pd.read_feather("data/df.feather")
print(df_csv)
print(df_tsv)
print(df_pkl)
print(df_excel)
print(df_clipboard)
print(df_from_dict)
print(df_hdf)
print(df_html)
print(df_json)
print(df_feather)
数据清洗与预处理
缺失值处理
| 方法/操作 | 语法示例 | 描述 |
|---|---|---|
| 检测缺失值 | df.isna() 或 df.isnull() | 返回布尔矩阵,标记缺失值(NaN或None) |
| 统计缺失值 | df.isna().sum() | 每列缺失值数量统计 |
| 删除缺失值 | df.dropna() | 删除包含缺失值的行(默认) |
| df.dropna(axis=1) | 删除包含缺失值的列 | |
| df.dropna(subset=['col1']) | 仅删除指定列的缺失值行 | |
| 填充缺失值 | df.fillna(value) | 用固定值填充(如df.fillna(0) |
| df.fillna(method='ffill') | 用前一个非缺失值填充(向前填充) | |
| df.fillna(method='bfill') | 用后一个非缺失值填充(向后填充) | |
| df.fillna(df.mean()) | 用列均值填充 |
pandas使用浮点值NaN(Not a Number)表示缺失数据,使用 NA(Not Available)表示缺失值。可以通过isnull()、isna()或notnull()、notna()方法判断某个值是否为缺失值。
Nan 通常表示一个无效的或未定义的数字值,是浮点数的一种特殊取值,用于表示那些不能表示为正常数字的情况,如 0/0、∞-∞ 等数学运算的结果。nan 与任何值(包括它自身)进行比较的结果都为False。例如在 Python 中,nan == nan返回 False。
NA 一般用于表示数据不可用或缺失的情况,它的含义更侧重于数据在某种上下文中是缺失或不存在的,不一定特指数字类型的缺失。
na 和 nan 都用于表示缺失值,但 nan 更强调是数值计算中的特殊值,而na更强调数据的可用性或存在性。
s = pd.Series([np.nan, None, pd.NA])
print(s)
# 0     NaN
# 1    None
# 2    <NA>
# dtype: object
print(s.isnull())
# 0    True
# 1    True
# 2    True
# dtype: bool
加载数据中包含缺失值。
df = pd.read_csv("data/weather_withna.csv")print(df.tail(5))
#             date  precipitation  temp_max  temp_min  wind weather
# 1456  2015-12-27            NaN       NaN       NaN   NaN     NaN
# 1457  2015-12-28            NaN       NaN       NaN   NaN     NaN
# 1458  2015-12-29            NaN       NaN       NaN   NaN     NaN
# 1459  2015-12-30            NaN       NaN       NaN   NaN     NaN
# 1460  2015-12-31           20.6      12.2       5.0   3.8    rain
可以通过keep_default_na参数设置是否将空白值设置为缺失值。
df = pd.read_csv("data/weather_withna.csv", keep_default_na=False)print(df.tail(5))
#             date precipitation temp_max temp_min wind weather
# 1456  2015-12-27
# 1457  2015-12-28
# 1458  2015-12-29
# 1459  2015-12-30
# 1460  2015-12-31          20.6     12.2      5.0  3.8    rain
可通过na_values参数将指定值设置为缺失值。
df = pd.read_csv("data/weather_withna.csv", na_values=["2015-12-31"])print(df.tail(5))
#             date  precipitation  temp_max  temp_min  wind weather
# 1456  2015-12-27            NaN       NaN       NaN   NaN     NaN
# 1457  2015-12-28            NaN       NaN       NaN   NaN     NaN
# 1458  2015-12-29            NaN       NaN       NaN   NaN     NaN
# 1459  2015-12-30            NaN       NaN       NaN   NaN     NaN
# 1460         NaN           20.6      12.2       5.0   3.8    rain
查看缺失值:通过isnull()查看缺失值数量
df = pd.read_csv("data/weather_withna.csv")
print(df.isnull().sum())
# date               0
# precipitation    303
# temp_max         303
# temp_min         303
# wind             303
# weather          303
# dtype: int64
剔除缺失值:通过dropna()方法来剔除缺失值。
- Series 剔除缺失值:
s = pd.Series([1, pd.NA, None])
print(s)
# 0       1
# 1    <NA>
# 2    None
# dtype: object
print(s.dropna())
# 0    1
# dtype: object
- DataFrame 剔除缺失值:
df = pd.DataFrame([[1, pd.NA, 2], [2, 3, 5], [pd.NA, 4, 6]])
print(df)
#       0     1  2
# 0     1  <NA>  2
# 1     2     3  5
# 2  <NA>     4  6
print(df.dropna())
#    0  1  2
# 1  2  3  5
无法从DataFrame中单独剔除一个值,只能剔除缺失值所在的整行或整列。默认情况下,dropna()会剔除任何包含缺失值的整行数据。
可以设置按不同的坐标轴剔除缺失值,比如axis=1(或 axis='columns')会剔除任何包含缺失值的整列数据。
df = pd.DataFrame([[1, pd.NA, 2], [2, 3, 5], [pd.NA, 4, 6]])
print(df)
#       0     1  2
# 0     1  <NA>  2
# 1     2     3  5
# 2  <NA>     4  6
print(df.dropna(axis=1))
#    2
# 0  2
# 1  5
# 2  6
有时只需要剔除全部是缺失值的行或列,或者绝大多数是缺失值的行或列。这些需求可以通过设置how或thresh参数来满足,它们可以设置剔除行或列缺失值的数量阈值。
df = pd.DataFrame([[1, pd.NA, 2], [pd.NA, pd.NA, 5], [pd.NA, pd.NA, pd.NA]])
print(df)
#       0     1     2
# 0     1  <NA>     2
# 1  <NA>  <NA>     5
# 2  <NA>  <NA>  <NA>
print(df.dropna(how="all"))  # 如果所有值都是缺失值,则删除这一行
#       0     1  2
# 0     1  <NA>  2
# 1  <NA>  <NA>  5
print(df.dropna(thresh=2))  # 如果至少有2个值不是缺失值,则保留这一行
#    0     1  2
# 0  1  <NA>  2
可以通过设置subset参数来设置某一列有缺失值则进行剔除。
df = pd.DataFrame([[1, pd.NA, 2], [pd.NA, pd.NA, 5], [pd.NA, pd.NA, pd.NA]])
print(df)
#       0     1     2
# 0     1  <NA>     2
# 1  <NA>  <NA>     5
# 2  <NA>  <NA>  <NA>
print(df.dropna(subset=[0]))  # 如果0列有缺失值,则删除这一行
#    0     1  2
# 0  1  <NA>  2
填充缺失值
- 使用固定值填充:通过
fillna()方法,传入值或字典进行填充。
df = pd.read_csv("data/weather_withna.csv")
print(df.fillna(0).tail())  # 使用固定值填充
#
print(df.fillna({"temp_max": 60, "temp_min": -60}).tail())  # 使用字典来填充
#             date  precipitation  temp_max  temp_min  wind weather
# 1456  2015-12-27            NaN      60.0     -60.0   NaN     NaN
# 1457  2015-12-28            NaN      60.0     -60.0   NaN     NaN
# 1458  2015-12-29            NaN      60.0     -60.0   NaN     NaN
# 1459  2015-12-30            NaN      60.0     -60.0   NaN     NaN
# 1460  2015-12-31           20.6      12.2       5.0   3.8    rain
- 使用统计值填充:通过
fillna()方法,传入统计后的值进行填充。
print(df.fillna(df[["precipitation", "temp_max", "temp_min", "wind"]].mean()).tail())  # 使用平均值填充
#             date  precipitation   temp_max  temp_min      wind weather
# 1456  2015-12-27       3.052332  15.851468  7.877202  3.242055     NaN
# 1457  2015-12-28       3.052332  15.851468  7.877202  3.242055     NaN
# 1458  2015-12-29       3.052332  15.851468  7.877202  3.242055     NaN
# 1459  2015-12-30       3.052332  15.851468  7.877202  3.242055     NaN
# 1460  2015-12-31      20.600000  12.200000  5.000000  3.800000    rain
- 使用前后的有效值填充:通过
ffill()或bfill()方法使用前面或后面的有效值填充。
print(df.ffill().tail())  # 使用前面的有效值填充
#             date  precipitation  temp_max  temp_min  wind weather
# 1456  2015-12-27            0.0      11.1       4.4   4.8     sun
# 1457  2015-12-28            0.0      11.1       4.4   4.8     sun
# 1458  2015-12-29            0.0      11.1       4.4   4.8     sun
# 1459  2015-12-30            0.0      11.1       4.4   4.8     sun
# 1460  2015-12-31           20.6      12.2       5.0   3.8    rain
print(df.bfill().tail())  # 使用后面的有效值填充
#             date  precipitation  temp_max  temp_min  wind weather
# 1456  2015-12-27           20.6      12.2       5.0   3.8    rain
# 1457  2015-12-28           20.6      12.2       5.0   3.8    rain
# 1458  2015-12-29           20.6      12.2       5.0   3.8    rain
# 1459  2015-12-30           20.6      12.2       5.0   3.8    rain
# 1460  2015-12-31           20.6      12.2       5.0   3.8    rain
- 通过线性插值填充:通过
interpolate()方法进行线性插值填充。线性插值操作,就是用于在已知数据点之间估算未知数据点的值。interpolate 方法支持多种插值方法,可通过 method 参数指定,常见的方法有:
import pandas as pd
import numpy as np
# 创建包含缺失值的 Series
s = pd.Series([1, np.nan, 3, 4, np.nan, 6])
# 使用默认的线性插值方法填充缺失值
s_interpolated = s.interpolate()
print(s_interpolated)
# 0    1.0
# 1    2.0
# 2    3.0
# 3    4.0
# 4    5.0
# 5    6.0
# dtype: float64
- `'linear'`:线性插值,基于两点之间的直线来估算缺失值,适用于数据呈线性变化的情况。
- `'time'`:适用于时间序列数据,会考虑时间间隔进行插值。
- `'polynomial'`:多项式插值,通过拟合多项式曲线来估算缺失值,可通过 order 参数指定多项式的阶数。
代码演示:
# 缺失值
import numpy as np
import pandas as pd
# 缺失值的类型 nan na
s = pd.Series([np.nan, None, pd.NA,2,4])
df = pd.DataFrame([[1, pd.NA, 2], [2, 3, 5], [pd.NA, 4, 6]])
print(s)
print(s.isnull())  #查看是否是缺失值
print(s.isna()) #查看是否是缺失值
print(s.isna().sum()) # 缺失值的个数
# 剔除缺失值
print(s.dropna())  #series剔除缺失值
print(df.dropna()) #只要有缺失值,就剔除一整条记录
print(df.dropna(how="all")) # 如果所有值都是缺失值,则删除这一行
print(df.dropna(thresh=2)) # 如果至少有2个值不是缺失值,则保留这一行
print(df.dropna(axis=1))  #剔除一列中含缺失值的列
#可以通过设置subset参数来设置某一列有缺失值则进行剔除。
print(df.dropna(subset=[0]))# 如果0列有缺失值,则删除这一行
#填充缺失值
print('********')
df = pd.read_csv("data/weather_withna.csv")
# df = df.fillna({"temp_max": 60, "temp_min": -60}) # 使用字典来填充
print(df['temp_max'].mean())
df.fillna(df[["precipitation", "temp_max", "temp_min", "wind"]].mean()).tail() # 使用平均值填充
print(df.ffill().tail()) # 使用前面的有效值填充
print(df.bfill().tail()) # 使用后面的有效值填充

df1 = pd.read_csv("data/weather_withna.csv")
df2 = pd.read_csv("data/weather_withna.csv", keep_default_na=False)
print(df1.temp_max.count())
print(df1.isnull().sum())
print(df2.temp_max.count())
print(df2.isnull().sum())
重复数据处理
| 方法/操作 | 语法示例 | 描述 |
|---|---|---|
| 检测重复行 | df.duplicated() | 返回布尔序列标记重复行(首次出现的行标记为False) |
| 删除重复行 | df.drop_duplicates() | 保留首次出现的行(默认检查所有列) |
| df.drop_duplicates(subset=['col1']) | 仅根据指定列去重 | |
| df.drop_duplicates(keep='last') | 保留最后一次出现的行 |
检测重复行:
import pandas as pd

# 创建包含重复数据的DataFrame
data = {
    'Name': ['Alice', 'Bob', 'Alice', 'Charlie', 'Bob'],
    'Age': [25, 30, 25, 35, 30],
    'City': ['NY', 'LA', 'NY', 'SF', 'LA']
}
df = pd.DataFrame(data)

# 检测重复行(默认检查所有列)
print("重复行标记(False表示首次出现,True表示重复):")
print(df.duplicated())
# 0    False
# 1    False
# 2     True
# 3    False
# 4     True
# dtype: bool
删除重复行:
import pandas as pd

# 创建包含重复数据的DataFrame
data = {
    'Name': ['Alice', 'Bob', 'Alice', 'Charlie', 'Bob'],
    'Age': [25, 30, 25, 35, 30],
    'City': ['NY', 'LA', 'NY', 'SF', 'LA']
}
df = pd.DataFrame(data)
# 默认保留首次出现的行
df_unique = df.drop_duplicates()
print("去重后的DataFrame:")
print(df_unique)
按指定列去重:
import pandas as pd

# 创建包含重复数据的DataFrame
data = {
    'Name': ['Alice', 'Bob', 'Alice', 'Charlie', 'Bob'],
    'Age': [25, 30, 25, 35, 30],
    'City': ['NY', 'LA', 'NY', 'SF', 'LA']
}
df = pd.DataFrame(data)
# 仅根据'Name'列去重(保留首次出现)
df_name_unique = df.drop_duplicates(subset=['Name'])
print("按Name列去重:")
print(df_name_unique)
#       Name  Age City
# 0    Alice   25   NY
# 1      Bob   30   LA
# 3  Charlie   35   SF
保留最后一次出现的重复行
import pandas as pd

# 创建包含重复数据的DataFrame
data = {
    'Name': ['Alice', 'Bob', 'Alice', 'Charlie', 'Bob'],
    'Age': [25, 30, 25, 35, 30],
    'City': ['NY', 'LA', 'NY', 'SF', 'LA']
}
# 保留最后一次出现的行
df_last = df.drop_duplicates(keep='last')
print("保留最后一次出现的行:")
print(df_last)
#       Name  Age City
# 2    Alice   25   NY
# 4      Bob   30   LA
# 3  Charlie   35   SF
数据类型转换
| 方法/操作 | 语法示例 | 描述 |
|---|---|---|
| 查看数据类型 | df.dtypes | 显示每列的数据类型 |
| 强制类型转换 | df['col'].astype('int') | 将列转换为指定类型(如int, float, str, datetime) |
| 转换为日期时间 | pd.to_datetime(df['col']) | 将字符串列转为datetime类型 |
| 转换为分类数据 | df['col'].astype('category') | 将列转为分类类型(节省内存,提高性能) |
| 数值格式化 | df['col'].round(2) | 保留2位小数 |
核心方法
| 操作 | 方法/函数 | 描述 |
|---|---|---|
| 查看数据类型 | df.dtypes | 显示每列的数据类型(如int64、float64、object等)。 |
| 强制类型转换 | df['col'].astype('type') | 将列转换为指定类型(如int、float、str、bool等)。 |
| 转换为日期时间 | pd.to_datetime(df['col']) | 将字符串或数值列转为datetime类型(支持自定义格式)。 |
| 转换为分类数据 | df['col'].astype('category') | 将列转为分类类型(节省内存,提高性能,适用于有限取值的列如性别、省份)。 |
| 数值格式化 | df['col'].round(2) | 保留指定小数位数(如2位)。 |
代码演示:
- 查看数据类型
import pandas as pd

# 加载数据(以sleep.csv为例)
df = pd.read_csv("sleep.csv")
print(df.dtypes)
# person_id                     int64
# gender                       object
# age                           int64
# occupation                   object
# sleep_duration              float64
# sleep_quality               float64
# ...                          ...
说明:object通常为字符串或混合类型,需检查是否需要转换。
- 强制类型转换:将数值列转换为整数或字符串
# 将sleep_duration从float转为int(丢失小数部分)
df['sleep_duration_int'] = df['sleep_duration'].astype('int32')

# 将gender转为字符串
df['gender_str'] = df['gender'].astype('str')

print(df[['sleep_duration', 'sleep_duration_int', 'gender_str']].head())
#    sleep_duration  sleep_duration_int gender_str
# 0             7.4                  7       Male
# 1             4.2                  4     Female
# 2             6.1                  6       Male
- 转换为日期时间:处理时间数据(假设employees.csv有日期列):
# 示例:创建临时日期列(实际数据可能为hire_date)
df_employees = pd.read_csv("employees.csv")
df_employees['fake_date'] = '2023-01-' + df_employees['employee_id'].astype(str).str[:2]

# 转换为datetime
df_employees['fake_date'] = pd.to_datetime(df_employees['fake_date'])
print(df_employees[['employee_id', 'fake_date']].head())
#    employee_id  fake_date
# 0          100 2023-01-10
# 1          101 2023-01-10
# 2          102 2023-01-10
- 注意:若原始格式非标准,需指定格式参数,如:
pd.to_datetime(df['date'], format='%Y/%m/%d')
4. 转换为分类数据:优化内存和性能(适用于低基数列):
# 将gender列转为分类类型
df['gender'] = df['gender'].astype('category')
print(df['gender'].dtypes)
# category
- 优势:
- 减少内存占用(尤其对重复值多的列)。
- 加速groupby、sort等操作。
5. 数值格式化:控制小数位数:
# 保留sleep_quality的2位小数
df['sleep_quality_rounded'] = df['sleep_quality'].round(2)
print(df[['sleep_quality', 'sleep_quality_rounded']].head())
#    sleep_quality  sleep_quality_rounded
# 0            7.0                   7.00
# 1            4.9                   4.90
# 2            6.0                   6.00
常见问题与技巧
- 处理转换错误:使用errors='coerce'将无效值转为NaN,避免报错:
df['age'] = pd.to_numeric(df['age'], errors='coerce')
- 内存优化:将数值列从int64转为int32或float32:
df['age'] = df['age'].astype('int32')
- 布尔类型转换:将字符串(如"Yes"/"No")转为布尔值:
df['is_active'] = df['active_flag'].map({'Yes': True, 'No': False})
- 自定义格式化:使用apply实现复杂转换(如百分比):
df['score_percent'] = df['score'].apply(lambda x: f"{x*100:.1f}%")
数据重塑与变形
| 方法/操作 | 语法示例 | 描述 |
|---|---|---|
| 行列转置 | df.T | 转置DataFrame(行变列,列变行) |
| 宽表转长表 | pd.melt(df, id_vars=['id']) | 将多列合并为键值对形式(variable和value列) |
| 长表转宽表 | df.pivot(index='id', columns='var', values='val') | 将长表转换为宽表(类似Excel数据透视) |
| 分列操作 | df['col'].str.split(',', expand=True) | 按分隔符拆分字符串为多列 |
注意事项
- pivot 与 pivot_table 的区别:
- pivot 要求索引和列的组合唯一,否则报错。
- pivot_table 支持聚合(如均值、求和),适合非唯一组合。
- 分列操作:
- 使用 expand=True 将拆分结果转为多列。
- 若分隔符数量不一致,需预处理数据(如填充缺失值)。
- 内存管理:
- 宽表转长表可能增加行数,需注意内存占用。
#数据变形
import pandas as pd
data = {
    'ID': [1, 2],
    'name':['alice','bob'],
    'Math': [90, 85],
    'English': [88, 92],
    'Science': [95, 89]
}
df = pd.DataFrame(data)
df
df.T
#宽表转长表
df2= pd.melt(df, id_vars=['ID','name'], var_name='科目', value_name='分数')
df2.sort_values(by=['name','科目'])
#长表转宽表
df3=pd.pivot(df2,index=['ID','name'],columns=['科目'],values='分数')
#分列
data = {
    'ID': [1, 2],
    'name':['alice smith','bob jack'],
    'Math': [90, 85],
    'English': [88, 92],
    'Science': [95, 89]
}
df = pd.DataFrame(data)
df[['first name','last name']] = df['name'].str.split(' ',expand=True)
# 加载数据
df = pd.read_csv("data/sleep.csv")

df=df[['person_id','blood_pressure']]
df[['high','low']]=df['blood_pressure'].str.split('/',expand=True)
df
文本数据处理
| 方法/操作 | 语法示例 | 描述 |
|---|---|---|
| 字符串大小写转换 | df['col'].str.lower() | 转为小写 |
| 去除空格 | df['col'].str.strip() | 去除两端空格 |
| 字符串替换 | df['col'].str.replace('old', 'new') | 替换文本 |
| 正则表达式提取 | df['col'].str.extract(r'(\d+)') | 提取匹配正则的文本(如数字) |
| 字符串包含检测 | df['col'].str.contains('abc') | 返回布尔序列,判断是否包含子串 |
时间数据处理
Timestamp 是 pandas 对 datetime64 数据类型的一个封装。datetime64 是 NumPy 中的一种数据类型,用于表示日期和时间,而 pandas 基于 datetime64 构建了 Timestamp 类,以便更方便地在 pandas 的数据结构(如 DataFrame 和 Series)中处理日期时间数据。
当 pd.to_datetime 接收单个日期时间值时,会返回 Timestamp 对象。
时间戳 timestamp
to_period()获取统计周期。
import pandas as pd
d = pd.Timestamp( "2015-05-01 09:08:07.123456" )
# 属性
print('年:',d.year)
print('月:',d.month)
print('日:',d.day)
print('小时:',d.hour)
print('分钟:',d.minute)
print('秒:',d.second)
print('微秒:',d.microsecond)
print('季度:',d.quarter)
print('是否是月底:',d.is_month_end)
print('是否是月初:',d.is_month_start)
print('是否是年底:',d.is_year_end)
print('是否是年初:',d.is_year_start)
# 方法
print('星期几:',d.day_name())
print('转换为年度:',d.to_period("Y"))
print('转换为季度:',d.to_period("Q"))
print('转换为月度:',d.to_period("M"))
print('转换为季度:',d.to_period("Q"))
print('转换为周维度:',d.to_period("W"))
freq:这是 to_period() 方法最重要的参数,用于指定要转换的时间周期频率。
常见的取值如下:
- "D":按天周期,例如 2024-01-01 会转换为 2024-01-01 这个天的周期。
- "W":按周周期,通常以周日作为一周的结束,比如日期落在某一周内,就会转换为该周的周期表示。
- "M":按月周期,像 2024-05-15 会转换为 2024-05。
- "Q":按季度周期,一年分为四个季度,日期会转换到对应的季度周期,例如 2024Q2 。
- "A" 或 "Y":按年周期,如 2024-07-20 会转换为 2024 。
日期数据转换
import pandas as pd

# 字符串字段转换为日期类型
a = pd.to_datetime('2025-07-01')
a = pd.to_datetime('20250409')
a = pd.to_datetime('2025/04/13')
a = pd.to_datetime('2025-07')
print(a)
print(type(a))
# dateFrame中的日期转换
df = pd.DataFrame({
    'sales':[100,50,40],
    'date':['2025-01-01','2023-03-02','2025-03-09']
})
df['datetime'] = pd.to_datetime(df['date'])
print(type(df['datetime'].dt))
df['datetime'].dt.day_name()
将日期数据作为索引
将datetime64类型的数据设置为索引,得到的就是DatetimeIndex。
df = pd.read_csv("data/weather.csv")df["date"] = pd.to_datetime(df["date"])  # 将date列转换为datetime64类型
df.set_index("date", inplace=True)  # 将date列设置为索引,inplace=true直接修改原对象
df.info()# <class 'pandas.core.frame.DataFrame'>
# DatetimeIndex: 1461 entries, 2012-01-01 to 2015-12-31
将时间作为索引后可以直接使用时间进行切片取值。
print(df.loc["2013-01":"2013-06"])  # 获取2013年1~6月的数据
#             precipitation  temp_max  temp_min  wind weather
# date
# 2013-01-01            0.0       5.0      -2.8   2.7     sun
# 2013-01-02            0.0       6.1      -1.1   3.2     sun
# ...                   ...       ...       ...   ...     ...
# 2013-06-29            0.0      30.0      18.3   1.7     sun
# 2013-06-30            0.0      33.9      17.2   2.5     sun
print  (  df  .  loc  [  "2015"  ])    # 获取2015年所有数据
#             precipitation  temp_max  temp_min  wind weather
# date
# 2015-01-01            0.0       5.6      -3.2   1.2     sun
# 2015-01-02            1.5       5.6       0.0   2.3    rain
# ...                   ...       ...       ...   ...     ...
# 2015-12-30            0.0       5.6      -1.0   3.4     sun
# 2015-12-31            0.0       5.6      -2.1   3.5     sun
也可以通过between_time()和at_time()获取某些时刻的数据。
df.between_time("9:00", "11:00")  # 获取9:00到11:00之间的数据
df.at_time("3:33")  # 获取3:33的数据
时间间隔 timedelta
当用一个日期减去另一个日期,返回的结果是timedelta64类型。
d1 = pd.Timestamp( "2015-05-01 09:08:07.123456" )
d2 = pd.Timestamp( "2015-05-31 09:23:07.123456" )
print(d2-d1)
print(type(d1))
print(type(d2-d1))
将timedelta64类型的数据设置为索引,得到的就是TimedeltaIndex。
df = pd.read_csv("data/weather.csv", parse_dates=[0])
df_date   =   pd  .  to_datetime  (  df  [  "date"  ])
df  [  "timedelta"  ] =   df_date     -     df_date  [  0  ]    # 得到timedelta64类型的数据
df  .  set_index  (  "timedelta"  ,   inplace  =  True  )    # 将timedelta列设置为索引
df  .  info  ()# <class 'pandas.core.frame.DataFrame'>
# TimedeltaIndex: 1461 entries, 0 days to 1460 days
将时间作为索引后可以直接使用时间进行切片取值。
print(df.loc["0 days":"5 days"])
#                 date  precipitation  temp_max  temp_min  wind  weather
# timedelta
# 0 days    2012-01-01            0.0      12.8       5.0   4.7  drizzle
# 1 days    2012-01-02           10.9      10.6       2.8   4.5     rain
# 2 days    2012-01-03            0.8      11.7       7.2   2.3     rain
# 3 days    2012-01-04           20.3      12.2       5.6   4.7     rain
# 4 days    2012-01-05            1.3       8.9       2.8   6.1     rain
# 5 days    2012-01-06            2.5       4.4       2.2   2.2     rain
时间序列
- 生成时间序列
为了能更简便地创建有规律的时间序列,pandas提供了date_range()方法。
date_range()通过开始日期、结束日期和频率代码(可选)创建一个有规律的日期序列,默认的频率是天。
print(pd.date_range("2015-07-03", "2015-07-10"))
# DatetimeIndex(['2015-07-03', '2015-07-04', '2015-07-05', '2015-07-06',
#                '2015-07-07', '2015-07-08', '2015-07-09', '2015-07-10'],
#               dtype='datetime64[ns]', freq='D')
此外,日期范围不一定非是开始时间与结束时间,也可以是开始时间与周期数periods。
print(pd.date_range("2015-07-03", periods=5))
# DatetimeIndex(['2015-07-03', '2015-07-04', '2015-07-05', '2015-07-06',
#                '2015-07-07'],
#               dtype='datetime64[ns]', freq='D')
可以通过freq参数设置时间频率,默认值是D。此处改为h,按小时变化的时间戳。
print(pd.date_range("2015-07-03", periods=5, freq="h"))
  # DatetimeIndex(['2015-07-03 00:00:00', '2015-07-03 01:00:00',
  #                '2015-07-03 02:00:00', '2015-07-03 03:00:00',
  #                '2015-07-03 04:00:00'],
  #               dtype='datetime64[ns]', freq='h')
下表为常见时间频率代码与说明:
| 代码 | 说明 |
|---|---|
| D | 天(calendar day,按日历算,含双休日) |
| B | 天(business day,仅含工作日) |
| W | 周(weekly) |
| ME / M | 月末(month end) |
| BME | 月末(business month end,仅含工作日) |
| MS | 月初(month start) |
| BMS | 月初(business month start,仅含工作日) |
| QE / Q | 季末(quarter end) |
| BQE | 季末(business quarter end,仅含工作日) |
| QS | 季初(quarter start) |
| BQS | 季初(business quarter start,仅含工作日) |
| YE / Y | 年末(year end) |
| BYE | 年末(business year end,仅含工作日) |
| YS | 年初(year start) |
| BYS | 年初(business year start,仅含工作日) |
| h | 小时(hours) |
| bh | 小时(business hours,工作时间) |
| min | 分钟(minutes) |
| s | 秒(seconds) |
| ms | 毫秒(milliseonds) |
| us | 微秒(microseconds) |
| ns | 纳秒(nanoseconds) |
- 偏移量
可以在频率代码后面加三位月份缩写字母来改变季、年频率的开始时间。
比如 QE-JAN、BQE-FEB、QS-MAR、BQS-APR等,YE-JAN、BYE-FEB、YS-MAR、BYS-APR 等。
print  (  pd  .  date_range  (  "2015-07-03"  ,   periods  =  10  ,   freq  =  "QE-JAN"  ))
  # 设置1月为季度末
  # DatetimeIndex(['2015-07-31', '2015-10-31', '2016-01-31', '2016-04-30',
  #                '2016-07-31', '2016-10-31', '2017-01-31', '2017-04-30',
  #                '2017-07-31', '2017-10-31'],
  #               dtype='datetime64[ns]', freq='QE-JAN')
同理,也可以在后面加三位星期缩写字母来改变一周的开始时间。
比如 W-SUN、W-MON、W-TUE、W-WED等。
print  (  pd  .  date_range  (  "2015-07-03"  ,   periods  =  10  ,   freq  =  "W-WED"  ))
  # 设置周三为一周的第一天
  # DatetimeIndex(['2015-07-08', '2015-07-15', '2015-07-22', '2015-07-29',
  #                '2015-08-05', '2015-08-12', '2015-08-19', '2015-08-26',
  #                '2015-09-02', '2015-09-09'],
  #               dtype='datetime64[ns]', freq='W-WED')
在这些代码的基础上,还可以将频率组合起来创建的新的周期。例如,可以用小时(h)和分钟(min)的组合来实现2小时30分钟。
print  (  pd  .  date_range  (  "2015-07-03"  ,   periods  =  10  ,   freq  =  "2h30min"  ))
  # DatetimeIndex(['2015-07-03 00:00:00', '2015-07-03 02:30:00',
  #                '2015-07-03 05:00:00', '2015-07-03 07:30:00',
  #                '2015-07-03 10:00:00', '2015-07-03 12:30:00',
  #                '2015-07-03 15:00:00', '2015-07-03 17:30:00',
  #                '2015-07-03 20:00:00', '2015-07-03 22:30:00'],
  #               dtype='datetime64[ns]', freq='150min')
数据分析与统计
| 分类 | 依赖关系 | 协同应用场景 | 示例 |
|---|---|---|---|
| 描述性统计 | 所有分析的基础 | 初步了解数据分布,指导后续分组策略 | df.describe() 发现某列标准差大 → 触发分组过滤 |
| 分组聚合 | 基于描述性统计或分组过滤结果 | 按维度拆分后计算指标(如各品类销售额总和) | df.groupby('category')['sales'].sum() |
| 分组转换 | 依赖分组聚合结构 | 在保留原始行数的前提下,添加组内计算列(如标准化、排名) | df.groupby('group')['value'].transform(lambda x: x/x.max()) |
| 分组过滤 | 依赖描述性统计或分组聚合结果 | 根据组级条件筛选数据(如剔除样本量不足的组) | df.groupby('group').filter(lambda x: len(x) > 5) |
| 相关性分析 | 可结合分组聚合结果 | 分析不同分组下变量的关联性(如各地区的价格-销量相关性) | df.groupby('region')[['price','sales']].corr() |
关键交互逻辑
- 从宏观到微观
+ 描述性统计(宏观) → 分组聚合(细分维度) → 分组转换/过滤(微观调整) - 数据流闭环
# 示例:分析高波动品类(闭环流程)
grouped = df.groupby('category')
# 1. 描述性统计 → 2. 分组过滤 → 3. 分组转换
result = (grouped.filter(lambda x: x['price'].std() > 2)
          .groupby('category')['price']
          .transform(lambda x: (x - x.mean())/x.std()))
- 功能互补性
+ 聚合 vs 转换:聚合减少行数,转换保持行数。
+ 过滤 vs 转*:过滤删除整组,转换修改组内值。
可视化应用场景
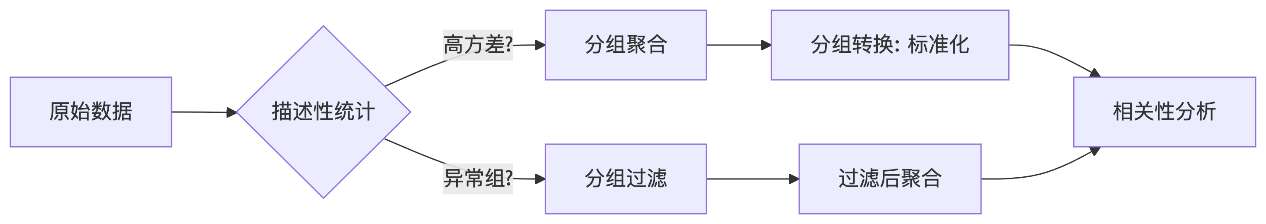
通过以上关系图和表格,可清晰理解如何组合这些方法解决实际问题,例如:
- 数据清洗:描述统计 → 发现异常 → 分组过滤
- 特征工程:分组聚合 → 分组转换(如生成占比特征)
- 业务分析:分组聚合 → 相关性分析(如用户分群行为关联)
聚合函数
| 方法 | 说明 |
|---|---|
| sum() | 求和 |
| mean() | 平均值 |
| min() | 最小值 |
| max() | 最大值 |
| var() | 方差 |
| std() | 标准差 |
| median() | 中位数 |
| quantile() | 指定位置的分位数,如quantile(0.5) |
| describe() | 常见统计信息 |
| size() | 所有元素的个数 |
| count() | 非空元素的个数 |
| first | 第一行 |
| last | 最后一行 |
| nth | 第n行 |
分组聚合
聚合语法:
df.groupby("分组字段")["要聚合的字段"].聚合函数()df.groupby(["分组字段", "分组字段2", ...])[["要聚合的字段", "要聚合的字段2", ...]].聚合函数()
DataFrameGroupBy 对象
对 DataFrame 对象调用groupby()方法后,会返回DataFrameGroupBy对象。如:<pandas.core.groupby.generic.DataFrameGroupBy object at 0x0000024FCBAFD700>
这个对象可以看成是一种特殊形式的 DataFrame,里面隐藏着若干组数据,但是在没有应用累计函数之前不会计算。GroupBy对象是一种非常灵活的抽象类型。在大多数场景中,可以将它看成是DataFrame的集合。
查看分组:通过groups属性查看分组结果,返回一个字典,字典的键是分组的标签,值是属于该组的所有索引的列表。
print(df.groupby("department_id").groups)  # 查看分组结果
# {10.0: [100], 20.0: [101, 102], 30.0: [14, 15, 16, 17, 18, 19]...
通过get_group()方法获取分组:
print(df.groupby("department_id").get_group(50))
# 获取分组为50的数据
#     employee_id first_name    last_name     email...
# 20          120    Matthew        Weiss    MWEISS...
# 21          121       Adam        Fripp    AFRIPP...
# 22          122      Payam     Kaufling  PKAUFLIN...
按列取值:
print(df.groupby("department_id")["salary"])
# 按department_id分组,取salary列
# <pandas.core.groupby.generic.SeriesGroupBy object at 0x0000022456D6F2F0>
这里从原来的DataFrame中取某个列名作为一个Series组。与GroupBy对象一样,直到运行累计函数,才会开始计算。
print(df.groupby("department_id")["salary"].mean())
# 计算每个部门平均薪资
# department_id
# 10.0      4400.000000
# 20.0      9500.000000
# 30.0      4150.000000
按组迭代:GroupBy对象支持直接按组进行迭代,返回的每一组都是Series或DataFrame。
for dept_id,group in df.groupby("department_id"):
    print(f"当前组为{dept_id},组里的数据情况{group.shape}:")
    print(group.iloc[:,0:3])
    print("-------------------")
# 当前组为10.0,组里的数据情况(1, 10):
#      employee_id first_name last_name
# 100          200   Jennifer    Whalen
# -------------------
# 当前组为20.0,组里的数据情况(2, 10):
#      employee_id first_name  last_name
# 101          201    Michael  Hartstein
# 102          202        Pat        Fay
按多字段分组:
salary_mean = df.groupby(["department_id", "job_id"])[
   ["salary", "commission_pct"]
].mean()  # 按department_id和job_id分组
print(salary_mean.index)  # 查看分组后的索引
# MultiIndex([( 10.0,    'AD_ASST'),
#             ( 20.0,     'MK_MAN'),
#             ( 20.0,     'MK_REP'),
#             ( 30.0,   'PU_CLERK'),
#             ( 30.0,     'PU_MAN'),
#             ...
print(salary_mean.columns)  # 查看分组后的列
# Index(['salary', 'commission_pct'], dtype='object')
按多个字段分组后得到的索引为复合索引。
可通过reset_index()方法重置索引。
print(salary_mean.reset_index())
#     department_id      job_id        salary  commission_pct
# 0            10.0     AD_ASST   4400.000000             NaN
# 1            20.0      MK_MAN  13000.000000             NaN
# 2            20.0      MK_REP   6000.000000             NaN
# 3            30.0    PU_CLERK   2780.000000             NaN
# 4            30.0      PU_MAN  11000.000000             NaN
也可以在分组的时候通过as_index = False参数(默认是True)重置索引。
salary_mean = df.groupby(["department_id", "job_id"], as_index=False)[
    ["salary", "commission_pct"]
].mean()  # 按department_id和job_id分组
print(salary_mean)#     department_id      job_id        salary  commission_pct
# 0            10.0     AD_ASST   4400.000000             NaN
# 1            20.0      MK_MAN  13000.000000             NaN
# 2            20.0      MK_REP   6000.000000             NaN
# 3            30.0    PU_CLERK   2780.000000             NaN
# 4            30.0      PU_MAN  11000.000000             NaN
分组频数计算:统计每个月不同天气状况的数量。
df.groupby("month")["weather"].nunique()
# date
# 2012-01    4
# 2012-02    4
# 2012-03    4
# 2012-04    4
# 2012-05    3
一次计算多个统计值
可以通过agg()或aggregate()进行更复杂的操作,如一次计算多个统计值。
df = pd.read_csv("data/employees.csv")  # 读取员工数据
# 按department_id分组,计算salary的最小值,中位数,最大值
print(df.groupby("department_id")["salary"].agg(["min", "median", "max"]))#                    min   median      max
# department_id
# 10.0            4400.0   4400.0   4400.0
# 20.0            6000.0   9500.0  13000.0
# 30.0            2500.0   2850.0  11000.0
# 40.0            6500.0   6500.0   6500.0
# 50.0            2100.0   3100.0   8200.0
多个列计算不同的统计值:可以在agg()中传入字典,对多个列计算不同的统计值。
df = pd.read_csv("data/employees.csv")  # 读取员工数据
# 按department_id分组,统计job_id的种类数,commission_pct的平均值
print(df.groupby("department_id").agg({"job_id": "nunique", "commission_pct": "mean"}))
#                job_id  commission_pct
# 10.0                1             NaN
# 20.0                2             NaN
# 30.0                2             NaN
# 40.0                1             NaN
# 50.0                3             NaN
重命名统计值:可以在agg()后通过rename()对统计后的列重命名。
df = pd.read_csv("data/employees.csv")  # 读取员工数据
# 按department_id分组,统计job_id的种类数,commission_pct的平均值
print(
    df.groupby("department_id")
    .agg(
        {"job_id": "nunique", "commission_pct": "mean"},
    )
    .rename(
        columns={"job_id": "工种数", "commission_pct": "佣金比例平均值"},
    )
)
#                工种数  佣金比例平均值
# department_id
# 10.0             1      NaN
# 20.0             2      NaN
# 30.0             2      NaN
# 40.0             1      NaN
# 50.0             3      NaN
自定义函数:可以向agg()中传入自定义函数进行计算。
df = pd.read_csv("data/employees.csv")  # 读取员工数据
def f(x):
    """统计每个部门员工last_name的首字母"""    result = set()
    for i in x:
        result.add(i[0])
    return result
print(df.groupby("department_id")["last_name"].agg(f))
# department_id
# 10.0                                                   {W}
# 20.0                                                {F, H}
# 30.0                                    {B, T, R, C, K, H}
# 40.0                                                   {M}
# 50.0     {O, E, K, S, W, L, P, D, C, V, B, T, M, J, F, ...
分组转换
聚合操作返回的是对组内全量数据缩减过的结果,而转换操作会返回一个新的全量数据。数据经过转换之后,其形状与原来的输入数据是一样的。
通过transform()将每一组的样本数据减去各组的均值,实现数据标准化
df = pd.read_csv("data/employees.csv")  # 读取员工数据
print(df.groupby("department_id")["salary"].transform(lambda x: x - x.mean()))
通过transform()按分组使用平均值填充缺失值
df = pd.read_csv("data/employees.csv")  # 读取员工数据
na_index = pd.Series(df.index.tolist()).sample(30)  # 随机挑选30条数据
df.loc[na_index, "salary"] = pd.NA  # 将这30条数据的salary设置为缺失值
print(df.groupby("department_id")["salary"].agg(["size", "count"]))  # 查看每组数据总数与非空数据数
def fill_missing(x):
    # 使用平均值填充,如果平均值也为NaN,用0填充
    if np.isnan(x.mean()):
        return 0
    return x.fillna(x.mean())
df["salary"] = df.groupby("department_id")["salary"].transform(fill_missing)
print(df.groupby("department_id")["salary"].agg(["size", "count"]))  # 查看每组数据总数与非空数据数
分组过滤
过滤操作可以让我们按照分组的属性丢弃若干数据。
例如,我们可能只需要保留commission_pct不包含空值的分组的数据。
commission_pct_filter = df.groupby("department_id").filter(lambda x: x["commission_pct"].notnull().all()
)  # 按department_id分组,过滤掉commission_pct包含空值的分组
print(commission_pct_filter)
Matplotlib 数据可视化
基本介绍
什么是 Matplotlib
Matplotlib 是一个Python绘图库,广泛用于创建各种类型的静态、动态和交互式图表。它是数据科学、机器学习、工程和科学计算领域中常用的绘图工具之一。
- 支持多种图表类型:折线图(Line plots)、散点图(Scatter plots)、柱状图(Bar charts)、直方图(Histograms)、饼图(Pie charts)、热图(Heatmaps)、箱型图(Box plots)、极坐标图(Polar plots)、3D图(3D plots,配合 mpl_toolkits.mplot3d)。
- 高度自定义:允许用户自定义图表的每个部分,包括标题、轴标签、刻度、图例等。支持多种颜色、字体和线条样式。提供精确的图形渲染控制,如坐标轴范围、图形大小、字体大小等。
- 兼容性:与NumPy、Pandas等库紧密集成,特别适用于绘制基于数据框和数组的数据可视化。可以输出到多种格式(如PNG、PDF、SVG、EPS等)。
- 交互式绘图:在Jupyter Notebook 中,Matplotlib支持交互式绘图,可以动态更新图表。支持图形缩放、平移等交互操作。
- 动态图表:可以生成动画(使用FuncAnimation类),为用户提供动态数据的可视化。
不同开发环境下显示图形:
- 在一个脚本文件中使用Matplotlib,那么显示图形的时候必须使用plt.show()。
- 在Notebook中使用Matplotlib,运行命令之后在每一个Notebook的单元中就会直接将PNG格式图形文件嵌入在单元中。
Python 可视化工具对比:
| 工具 | 说明 | 优点 | 缺点 |
|---|---|---|---|
| matplotlib | Python 最基础可视化库 | 灵活强大、定制性强 | 代码多、风格基础 |
| seaborn | 基于 matplotlib 的高级接口 | 风格美观、统计图方便 | 对简单图略繁琐 |
| pandas plot | 快速图表,调用 .plot() |
快捷、适合 EDA | 图表样式较少 |
常见图表类型及使用场景
| 图表类型 | 适用数据 | 常见用途 |
|---|---|---|
| 折线图 line | 连续变量 | 时间趋势、变化轨迹 |
| 条形图 bar | 分类数据 | 类别比较 |
| 饼图 pie | 构成比例 | 占比展示 |
| 散点图 scatter | 数值对数值 | 相关关系、聚类 |
| 箱线图 box | 数值型 | 数据分布、异常值 |
| 热力图 heatmap | 表格型 | 关联性、密度分布 |
好图的标准:
| 标准 | 说明 |
|---|---|
| 明确性 | 观众一眼能看懂图讲了什么 |
| 美观性 | 色彩协调,结构合理 |
| 信息量 | 图中内容丰富但不混乱 |
| 易读性 | 字体大小合适,单位清晰,图例明确 |
画图接口
折线图
函数: plt.plot(x, y, ...)
适用场景: 时间趋势、连续变化、趋势分析
常用参数:
x: X轴数据y: Y轴数据label: 图例标签color: 线条颜色linewidth或lw: 线条宽度linestyle或ls: 线条样式('-'实线,'--'虚线,':'点线,'-.'点划线)marker: 数据点标记('o'圆点,'s'方块,'^'三角等)
示例代码:
import matplotlib.pyplot as plt
from matplotlib import rcParams
# rcParams['font.sans-serif'] = 'STHeiti'  # 设置中文字体

plt.figure(figsize=(10, 5))
month = ['1月', '2月', '3月', '4月']
sales = [100, 150, 80, 130]

plt.plot(month, sales,
         label='产品A',
         color='orange',
         linewidth=2,
         linestyle='--',
         marker='o')

plt.title('2025年销售趋势', color='red', fontsize=20)
plt.xlabel('月份', fontsize=10)
plt.ylabel('销售额(万元)', fontsize=10)
plt.legend(loc='upper left')
plt.grid(True, alpha=0.1, color='blue', linestyle='--')
plt.show()
条形图 (Bar Chart)
函数: plt.bar(x, height, ...) 或 plt.barh(y, width, ...)
适用场景: 类别比较、分类数据展示
常用参数:
x: X轴位置(类别)height: 柱子的高度(数值)width: 柱子宽度(默认0.8)color: 柱子颜色label: 图例标签plt.barh(): 水平条形图,参数为y和width
示例代码:
import matplotlib.pyplot as plt
from matplotlib import rcParams
# rcParams['font.sans-serif'] = 'STHeiti'

plt.figure(figsize=(10, 5))
subjects = ['语文', '数学', '英语', '科学']
scores = [85, 92, 78, 88]

plt.bar(subjects, scores,
        label='小红',
        color='orange',
        width=0.6)

plt.title('2025年成绩分布', color='red', fontsize=20)
plt.xlabel('科目', fontsize=10)
plt.ylabel('分数', fontsize=10)
plt.legend(loc='upper right')
plt.grid(axis='y', alpha=0.1, color='blue', linestyle='--')
plt.ylim(0, 100)

# 在每个柱子上显示数值
for x, y in zip(subjects, scores):
    plt.text(x, y+1, str(y), ha='center', va='bottom', fontsize=10)

plt.tight_layout()
plt.show()
饼图 (Pie Chart)
函数: plt.pie(x, labels=..., ...)
适用场景: 构成比例、占比展示
常用参数:
x: 数据值(列表)labels: 标签列表autopct: 显示百分比格式(如'%.1f%%')colors: 颜色列表explode: 突出显示某些扇形(列表,0表示不突出)startangle: 起始角度(0-360)shadow: 是否显示阴影(True/False)
示例代码:
import matplotlib.pyplot as plt
from matplotlib import rcParams
# rcParams['font.sans-serif'] = 'STHeiti'

plt.figure(figsize=(10, 5))
things = ['学习', '娱乐', '运动', '睡觉', '其他']
times = [6, 4, 1, 8, 5]
colors = ['#66b3ff', '#99ff99', '#ffcc99', '#ff9999', '#ff4499']
explode = [0.1, 0, 0, 0, 0]  # 突出显示第一块

plt.pie(times, labels=things,
        autopct='%.1f%%',  # 显示百分比
        startangle=0,
        colors=colors,
        explode=explode,
        shadow=True)

plt.title('一天的时间分布', color='red', fontsize=20)
plt.tight_layout()
plt.show()
散点图 (Scatter Plot)
函数: plt.scatter(x, y, ...)
适用场景: 相关关系、聚类、分布观察
常用参数:
x: X轴数据y: Y轴数据s: 点的大小c: 点的颜色(可以是单个值或数组)alpha: 透明度(0-1)marker: 标记样式
示例代码:
import matplotlib.pyplot as plt
from matplotlib import rcParams
# rcParams['font.sans-serif'] = 'STHeiti'

plt.figure(figsize=(10, 5))
scores = [50, 55, 60, 65, 70, 75, 80]
hours = [1, 2, 3, 4, 5, 6, 7]

plt.scatter(hours, scores,
            s=100,  # 点的大小
            c='blue',
            alpha=0.6,
            marker='o')

plt.title('学习时间与成绩关系', fontsize=16)
plt.xlabel('学习时间(小时)', fontsize=12)
plt.ylabel('成绩', fontsize=12)
plt.grid(True, alpha=0.3)
plt.show()
箱线图 (Boxplot)
函数: plt.boxplot(data, ...)
适用场景: 数据分布、异常值检测、统计摘要
常用参数:
data: 数据(可以是列表、数组或字典)labels: 标签列表notch: 是否显示缺口(True/False)vert: 是否垂直显示(True/False)patch_artist: 是否填充颜色(True/False)
箱线图说明:
- 箱体:表示数据的四分位数范围(Q1到Q3)
- 中位线:箱体中间的线,表示中位数
- 须线:延伸到最大值和最小值(排除异常值)
- 异常值:超出1.5倍四分位距的点
示例代码:
import matplotlib.pyplot as plt
from matplotlib import rcParams
# rcParams['font.sans-serif'] = 'STHeiti'

plt.figure(figsize=(8, 6))

# 模拟3门课的成绩
data = {
    '语文': [82, 85, 88, 70, 90, 76, 84, 83, 95],
    '数学': [75, 80, 79, 93, 88, 82, 87, 89, 92],
    '英语': [70, 72, 68, 65, 78, 80, 85, 90, 95]
}

plt.boxplot(data.values(), tick_labels=data.keys())

plt.title('各科成绩分布(箱线图)', fontsize=16)
plt.ylabel('分数', fontsize=12)
plt.grid(True, axis='y', linestyle='--', alpha=0.5)
plt.show()
面向对象接口
除了使用 plt.xxx() 的函数式接口,matplotlib 还支持面向对象的接口,更适合复杂的图表和多子图场景。
面向对象接口的优势
- 更清晰:明确知道操作的是哪个子图
- 更灵活:可以精确控制每个子图的属性
- 更适合复杂图表:多子图、组合图等场景
- 更符合编程习惯:面向对象的编程风格
基本用法
import matplotlib.pyplot as plt

# 创建图形和坐标轴对象
fig, ax = plt.subplots(figsize=(10, 5))

# 使用 ax 对象绘图
ax.plot([1, 2, 3, 4], [1, 4, 2, 3])
ax.set_title('标题')
ax.set_xlabel('X轴')
ax.set_ylabel('Y轴')
ax.grid(True)

plt.show()
多子图示例
import matplotlib.pyplot as plt

# 创建2x2的子图
fig, axes = plt.subplots(2, 2, figsize=(12, 10))

# 第一个子图:折线图
axes[0, 0].plot([1, 2, 3, 4], [1, 4, 2, 3])
axes[0, 0].set_title('折线图')

# 第二个子图:柱状图
axes[0, 1].bar(['A', 'B', 'C'], [10, 20, 15])
axes[0, 1].set_title('柱状图')

# 第三个子图:散点图
axes[1, 0].scatter([1, 2, 3, 4], [1, 4, 2, 3])
axes[1, 0].set_title('散点图')

# 第四个子图:饼图
axes[1, 1].pie([30, 25, 45], labels=['A', 'B', 'C'])
axes[1, 1].set_title('饼图')

plt.tight_layout()  # 自动调整布局
plt.show()
常用方法对比
| 函数式接口 | 面向对象接口 |
|---|---|
plt.plot() |
ax.plot() |
plt.title() |
ax.set_title() |
plt.xlabel() |
ax.set_xlabel() |
plt.ylabel() |
ax.set_ylabel() |
plt.xlim() |
ax.set_xlim() |
plt.ylim() |
ax.set_ylim() |
plt.legend() |
ax.legend() |
plt.grid() |
ax.grid() |
其他接口
设置中文字体
from matplotlib import rcParams
rcParams['font.sans-serif'] = 'STHeiti'  # Mac
# rcParams['font.sans-serif'] = 'SimHei'  # Windows
保存图表
plt.savefig('figure.png', dpi=300, bbox_inches='tight')
清除和关闭
plt.clf()    # 清除当前图形
plt.close()  # 关闭图形窗口
自动布局优化
plt.tight_layout() # 自动调整子图布局,避免重叠
Seaborn 可视化
Seaborn 是基于 matplotlib 的高级数据可视化库,提供了更美观的统计图表和更简洁的 API。
主要特点:
- 美观的默认样式:内置多种美观的图表样式
- 统计图方便:专门为统计分析设计的图表类型
- 基于 matplotlib:底层使用 matplotlib,可以结合使用
- DataFrame 友好:直接接受 pandas DataFrame 作为数据源
导入方式:
import seaborn as sns
import matplotlib.pyplot as plt
import pandas as pd

# 设置中文字体
plt.rcParams["font.sans-serif"] = ["STHeiti"]
单变量可视化
单变量可视化用于展示单个变量的分布情况。
使用penguins(企鹅)数据集,其中包含7个字段:
- species:企鹅种类(Adelie、Gentoo、Chinstrap)。
- island:观测岛屿(Torgersen, Biscoe, Dream)。
- bill_length_mm:喙(嘴)长度(毫米)。
- bill_depth_mm:喙深度(毫米)。
- flipper_length_mm:脚蹼长度(毫米)。
- body_mass_g:体重(克)。
- sex:性别(Male、Female)。
(原文档附带的附件请到语雀源文档查看)
加载数据:
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt

plt.rcParams["font.sans-serif"] = ["KaiTi"]
penguins = pd.read_csv("data/penguins.csv")
penguins.dropna(inplace=True)
penguins.info()
# <class 'pandas.core.frame.DataFrame'>
# Index: 333 entries, 0 to 343
# Data columns (total 7 columns):
#  #   Column             Non-Null Count  Dtype
# ---  ------             --------------  -----
#  0   species            333 non-null    object
#  1   island             333 non-null    object
#  2   bill_length_mm     333 non-null    float64
#  3   bill_depth_mm      333 non-null    float64
#  4   flipper_length_mm  333 non-null    float64
#  5   body_mass_g        333 non-null    float64
#  6   sex                333 non-null    object
# dtypes: float64(4), object(3)
# memory usage: 20.8+ KB
直方图 (histplot)
函数: sns.histplot(data=df, x="column")
用途: 展示数值变量的分布,或分类变量的计数。
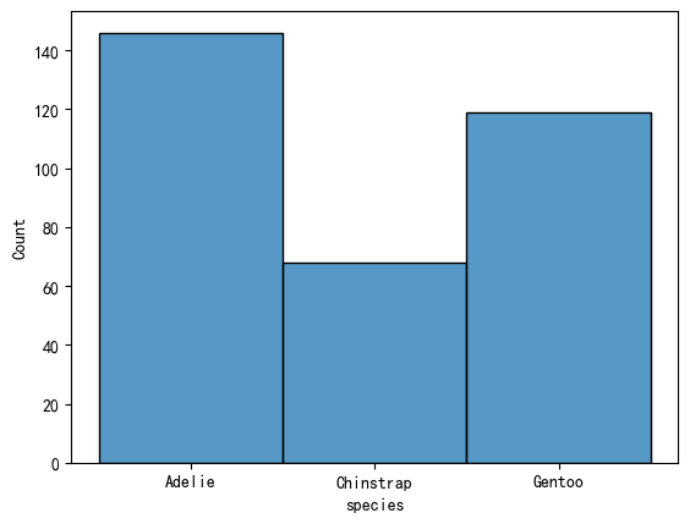
示例代码:
import seaborn as sns
import matplotlib.pyplot as plt
import pandas as pd

# 设置中文字体
plt.rcParams["font.sans-serif"] = ["STHeiti"]

# 加载数据(示例)
penguins = pd.read_csv("data/penguins.csv")
penguins.dropna(inplace=True)

# 分类变量的计数
sns.histplot(data=penguins, x="species")
plt.title('企鹅种类分布')
plt.show()

# 数值变量的分布
sns.histplot(data=penguins, x="bill_length_mm")
plt.title('喙长度分布')
plt.xlabel('喙长度 (mm)')
plt.ylabel('频数')
plt.show()
核密度估计图 (kdeplot)
函数: sns.kdeplot(data=df, x="column")
说明: 核密度估计图(KDE,Kernel Density Estimate Plot)是一种用于显示数据分布的统计图表,它通过平滑直方图的方法来估计数据的概率密度函数,使得分布图看起来更加连续和平滑。核密度估计是一种非参数方法,用于估计随机变量的概率密度函数。其基本思想是,将每个数据点视为一个"核"(通常是高斯分布),然后将这些核的贡献相加以形成平滑的密度曲线。
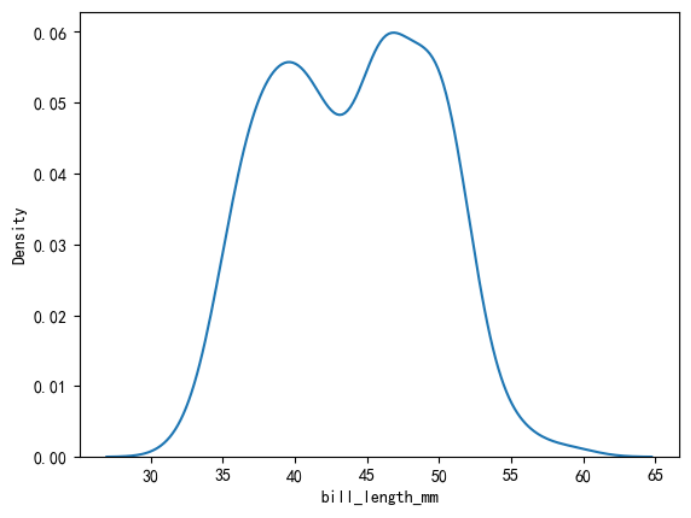
示例代码:
import seaborn as sns
import matplotlib.pyplot as plt
import pandas as pd

# 设置中文字体
# plt.rcParams["font.sans-serif"] = ["STHeiti"]

# 加载数据(示例)
penguins = pd.read_csv("data/penguins.csv")
penguins.dropna(inplace=True)

# 绘制喙长度的核密度估计图
sns.kdeplot(data=penguins, x="bill_length_mm")
plt.title('喙长度核密度估计图')
plt.xlabel('喙长度 (mm)')
plt.ylabel('密度')
plt.show()

# 直方图 + KDE 曲线
sns.histplot(data=penguins, x="bill_length_mm", kde=True)
plt.title('喙长度分布(直方图+KDE)')
plt.xlabel('喙长度 (mm)')
plt.ylabel('频数')
plt.show()
在histplot()中设置kde=True也可以得到核密度估计图。
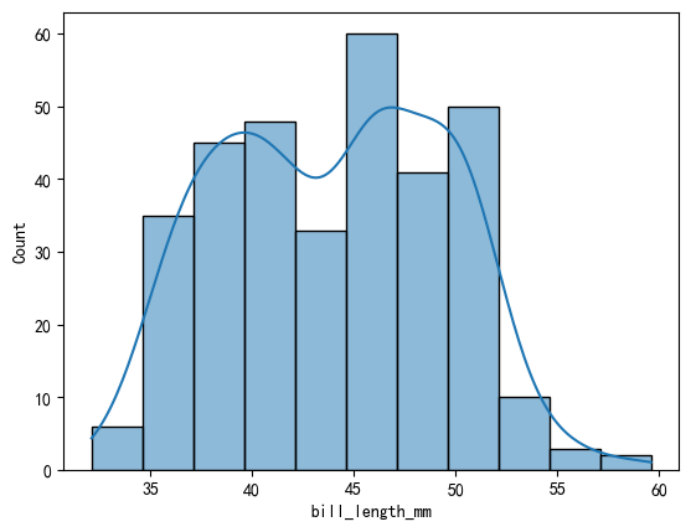
计数图 (countplot)
函数: sns.countplot(data=df, x="column")
说明: 计数图用于绘制分类变量的计数分布图,显示每个类别在数据集中出现的次数,是分析分类数据非常直观的工具,可以快速了解类别的分布情况。
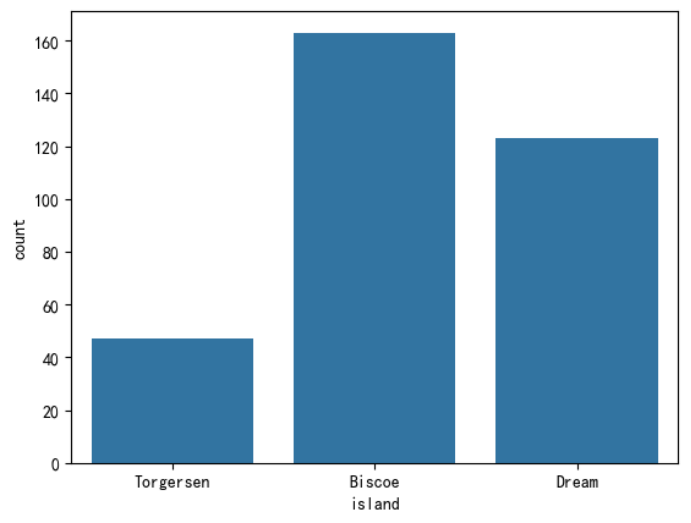
示例代码:
import seaborn as sns
import matplotlib.pyplot as plt
import pandas as pd

# 设置中文字体
plt.rcParams["font.sans-serif"] = ["STHeiti"]

# 加载数据(示例)
penguins = pd.read_csv("data/penguins.csv")
penguins.dropna(inplace=True)

# 绘制不同岛屿企鹅数量的计数图
sns.countplot(data=penguins, x="island")
plt.title('不同岛屿企鹅数量')
plt.xlabel('岛屿')
plt.ylabel('数量')
plt.show()
双变量可视化
双变量可视化用于展示两个变量之间的关系。
散点图 (scatterplot)
函数: sns.scatterplot(data=df, x="col1", y="col2", hue="col3")
用途: 展示两个数值变量之间的关系,可通过 hue 参数按第三个变量分组。
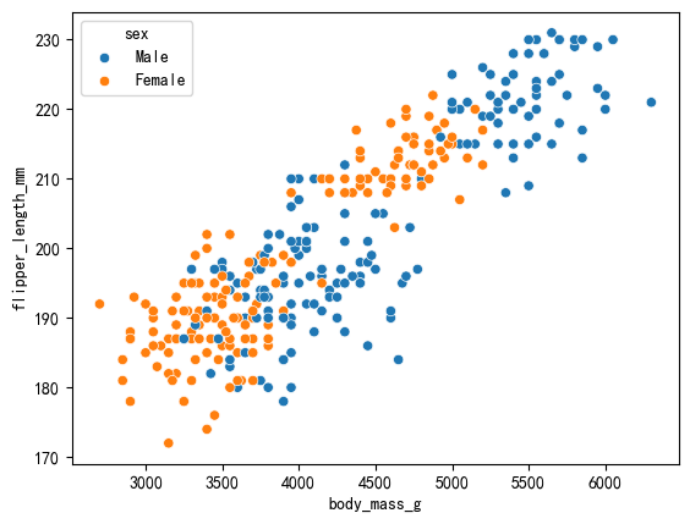
示例代码:
import seaborn as sns
import matplotlib.pyplot as plt
import pandas as pd

# 设置中文字体
plt.rcParams["font.sans-serif"] = ["STHeiti"]

# 加载数据(示例)
penguins = pd.read_csv("data/penguins.csv")
penguins.dropna(inplace=True)

# 绘制横轴为体重,纵轴为脚蹼长度的散点图
# 可通过hue参数设置不同组别进行对比
sns.scatterplot(data=penguins, x="body_mass_g", y="flipper_length_mm", hue="sex")
plt.title('体重与脚蹼长度关系')
plt.xlabel('体重 (g)')
plt.ylabel('脚蹼长度 (mm)')
plt.legend(title='性别')
plt.show()
也可以通过regplot()函数绘制散点图,同时会拟合回归曲线。可以通过fit_reg=False关闭拟合。
sns.regplot(data=penguins, x="body_mass_g", y="flipper_length_mm")
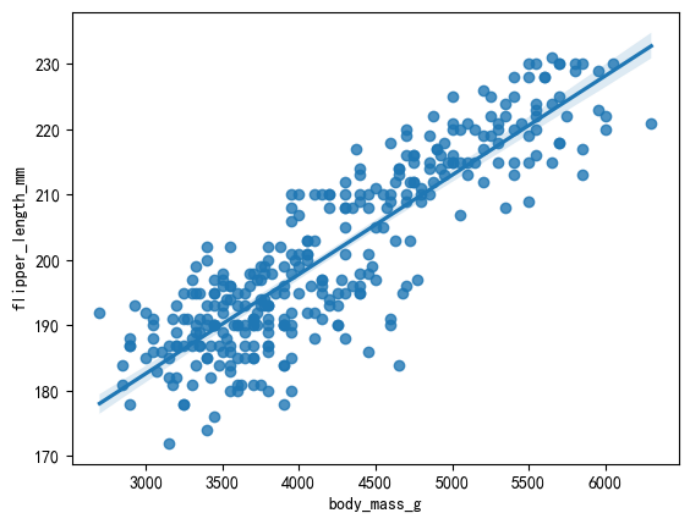
也可以通过lmplot()函数绘制基于hue参数的分组回归图。
sns.lmplot(data=penguins, x="body_mass_g", y="flipper_length_mm", hue="sex")
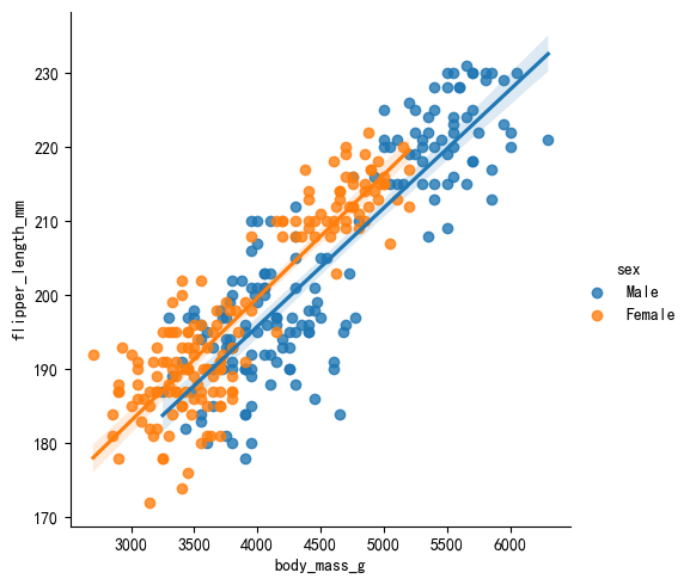
也可以通过jointplot()函数绘制在每个轴上包含单个变量的散点图。
sns.jointplot(data=penguins, x="body_mass_g", y="flipper_length_mm")
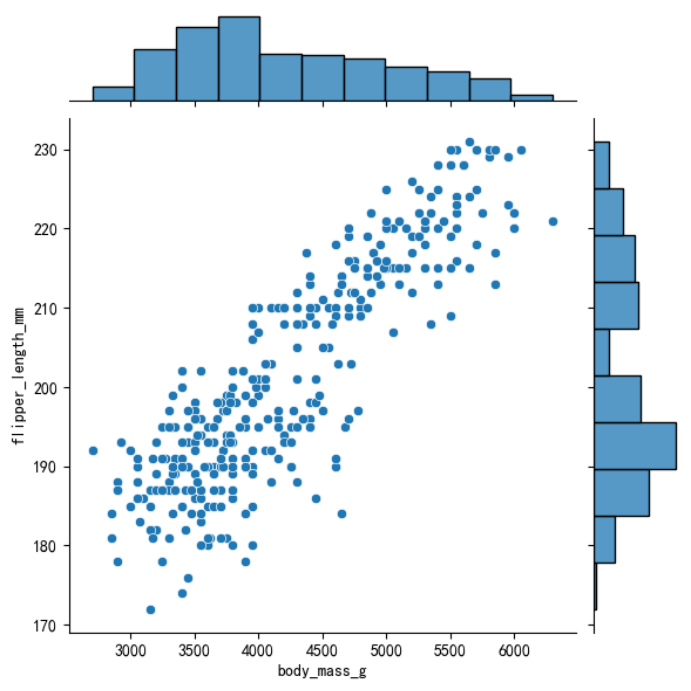
蜂窝图 (jointplot with hex)
函数: sns.jointplot(data=df, x="col1", y="col2", kind="hex")
用途: 展示两个变量的联合分布,用六边形密度表示数据点的密集程度。
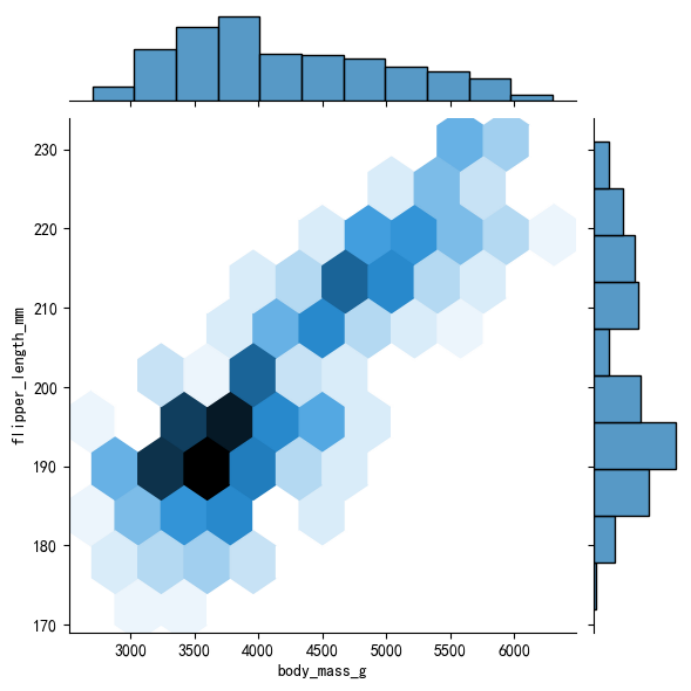
示例代码:
import seaborn as sns
import matplotlib.pyplot as plt
import pandas as pd

# 设置中文字体
plt.rcParams["font.sans-serif"] = ["STHeiti"]

# 加载数据(示例)
penguins = pd.read_csv("data/penguins.csv")
penguins.dropna(inplace=True)

# 通过jointplot()函数,设置kind="hex"来绘制蜂窝图
sns.jointplot(data=penguins, x="body_mass_g", y="flipper_length_mm", kind="hex")
plt.show()
二维核密度估计图 (kdeplot 2D)
函数: sns.kdeplot(data=df, x="col1", y="col2", fill=True, cbar=True)
用途: 展示两个变量的联合概率密度分布。
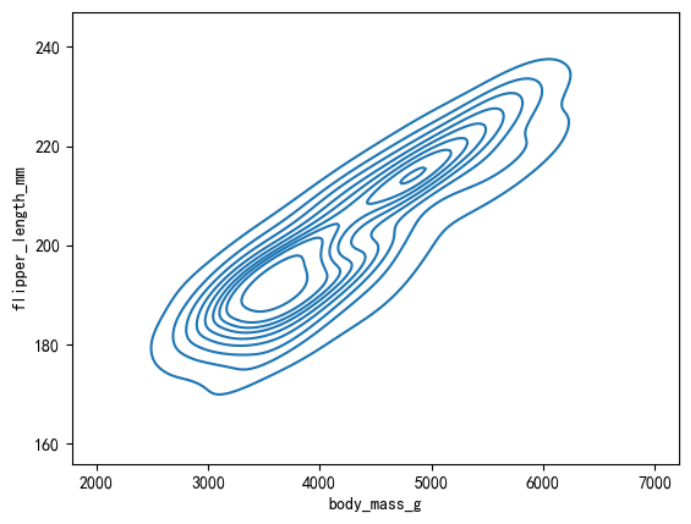
示例代码:
import seaborn as sns
import matplotlib.pyplot as plt
import pandas as pd

# 设置中文字体
plt.rcParams["font.sans-serif"] = ["STHeiti"]

# 加载数据(示例)
penguins = pd.read_csv("data/penguins.csv")
penguins.dropna(inplace=True)

# 通过kdeplot()函数,同时设置x参数和y参数来绘制二维核密度估计图
sns.kdeplot(data=penguins, x="body_mass_g", y="flipper_length_mm")
plt.title('体重与脚蹼长度联合密度分布')
plt.xlabel('体重 (g)')
plt.ylabel('脚蹼长度 (mm)')
plt.show()

# 填充版本,显示颜色示意条
sns.kdeplot(data=penguins, x="body_mass_g", y="flipper_length_mm", fill=True, cbar=True)
plt.title('体重与脚蹼长度联合密度分布(填充版)')
plt.xlabel('体重 (g)')
plt.ylabel('脚蹼长度 (mm)')
plt.show()
通过fill=True设置为填充,通过cbar=True设置显示颜色示意条。
sns.kdeplot(data=penguins, x="body_mass_g", y="flipper_length_mm", fill=True, cbar=True)
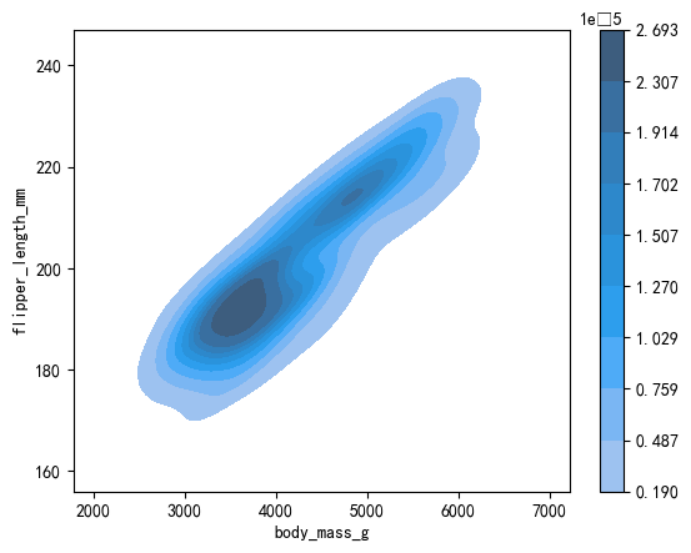
条形图 (barplot)
函数: sns.barplot(data=df, x="col1", y="col2", estimator="mean", errorbar=None)
用途: 展示分类变量与数值变量的关系,默认显示均值。
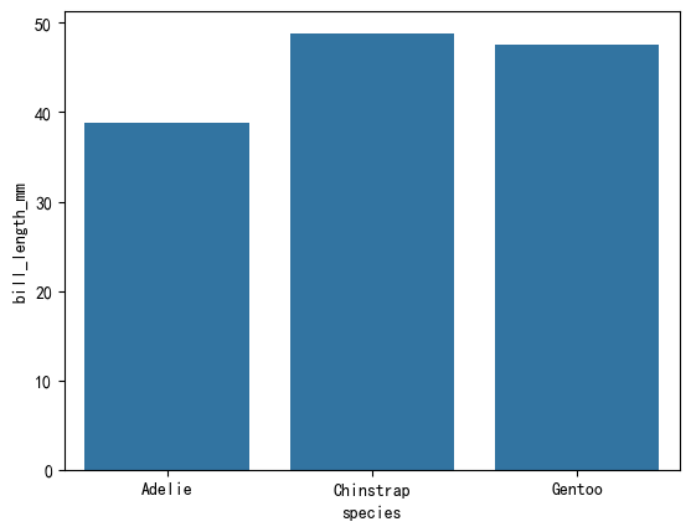
常用参数:
estimator: 聚合函数(如"mean","median","sum"等)errorbar: 误差条设置(None表示不显示)
示例代码:
import seaborn as sns
import matplotlib.pyplot as plt
import pandas as pd

# 设置中文字体
plt.rcParams["font.sans-serif"] = ["STHeiti"]

# 加载数据(示例)
penguins = pd.read_csv("data/penguins.csv")
penguins.dropna(inplace=True)

# 条形图
sns.barplot(data=penguins, x="species", y="bill_length_mm", estimator="mean", errorbar=None)
plt.title('不同种类企鹅的平均喙长度')
plt.xlabel('企鹅种类')
plt.ylabel('平均喙长度 (mm)')
plt.show()
箱线图 (boxplot)
箱线图是一种用于展示数据分布、集中趋势、散布情况以及异常值的统计图表。它通过五个关键的统计量(最小值、第一四分位数、中位数、第三四分位数、最大值)来展示数据的分布情况。
箱线图通过箱体和须来表现数据的分布,能够有效地显示数据的偏斜、分散性以及异常值。箱线图的组成部分:
- 箱体(Box):
- 下四分位数(Q1):数据集下 25% 的位置,箱体的下边缘。
- 上四分位数(Q3):数据集下 75% 的位置,箱体的上边缘。
- 四分位间距(IQR, Interquartile Range):Q3 和 Q1 之间的距离,用来衡量数据的离散程度。
- 中位数(Median):箱体内部的水平线,表示数据集的中位数。
- 须(Whiskers):
- 下须:从 Q1 向下延伸,通常是数据集中最小值与 Q1 的距离,直到没有超过1.5倍 IQR 的数据点为止。
- 上须:从 Q3 向上延伸,通常是数据集中最大值与 Q3 的距离,直到没有超过1.5倍 IQR 的数据点为止。
- 异常值(Outliers):
- 超过1.5倍 IQR 的数据被认为是异常值,通常用点标记出来。异常值是数据中相对于其他数据点而言“非常大”或“非常小”的值。
函数: **sns.boxplot(data=df, x="col1", y="col2")**
用途: 展示分类变量与数值变量的分布关系,包括中位数、四分位数和异常值。
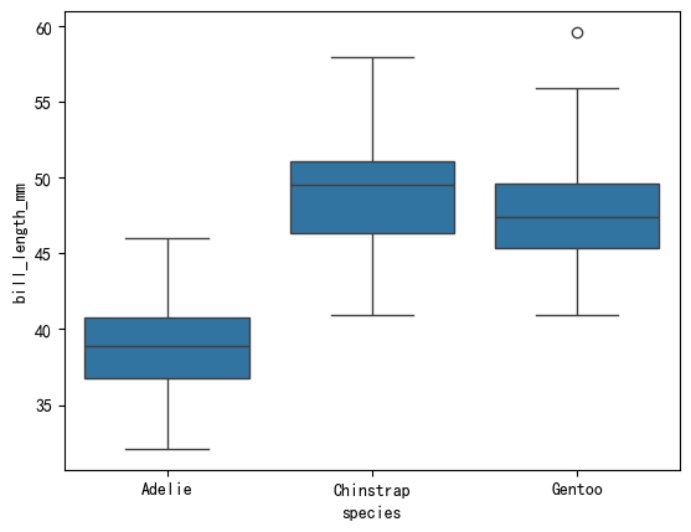
示例代码:
import seaborn as sns
import matplotlib.pyplot as plt
import pandas as pd

# 设置中文字体
plt.rcParams["font.sans-serif"] = ["STHeiti"]

# 加载数据(示例)
penguins = pd.read_csv("data/penguins.csv")
penguins.dropna(inplace=True)

# 箱线图
sns.boxplot(data=penguins, x="species", y="bill_length_mm")
plt.title('不同种类企鹅的喙长度分布')
plt.xlabel('企鹅种类')
plt.ylabel('喙长度 (mm)')
plt.show()
小提琴图 (violinplot)
函数: sns.violinplot(data=df, x="col1", y="col2")
说明: 小提琴图(Violin Plot)是一种结合了箱线图和核密度估计图(KDE)的可视化图表,用于展示数据的分布情况、集中趋势、散布情况以及异常值。小提琴图不仅可以显示数据的基本统计量(如中位数和四分位数),还可以展示数据的概率密度,提供比箱线图更丰富的信息。
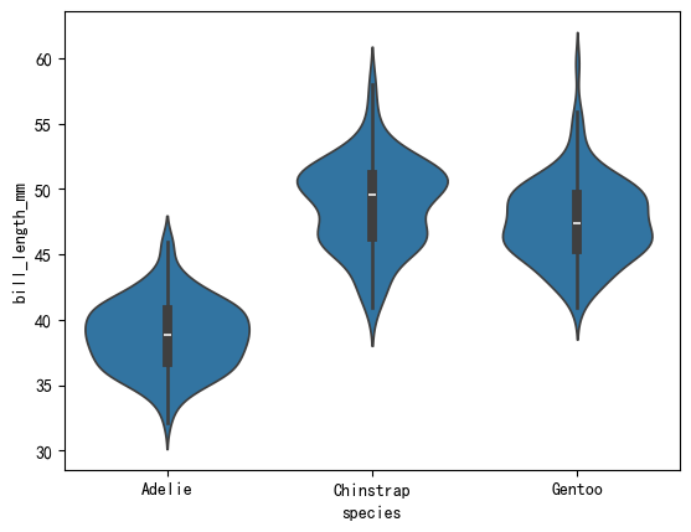
示例代码:
import seaborn as sns
import matplotlib.pyplot as plt
import pandas as pd

# 设置中文字体
plt.rcParams["font.sans-serif"] = ["STHeiti"]

# 加载数据(示例)
penguins = pd.read_csv("data/penguins.csv")
penguins.dropna(inplace=True)

# 小提琴图
sns.violinplot(data=penguins, x="species", y="bill_length_mm")
plt.title('不同种类企鹅的喙长度分布(小提琴图)')
plt.xlabel('企鹅种类')
plt.ylabel('喙长度 (mm)')
plt.show()
多变量可视化
多变量可视化用于同时展示多个变量之间的关系。
成对关系图 (pairplot)
函数: sns.pairplot(data=df, hue="column")
说明: 成对关系图是一种用于显示多个变量之间关系的可视化工具。它可以展示各个变量之间的成对关系,并且通过不同的图表形式帮助我们理解数据中各个变量之间的相互作用。对角线上的图通常显示每个变量的分布(如直方图或核密度估计图),帮助观察每个变量的单变量特性。其他位置展示所有变量的两两关系,用散点图表示。
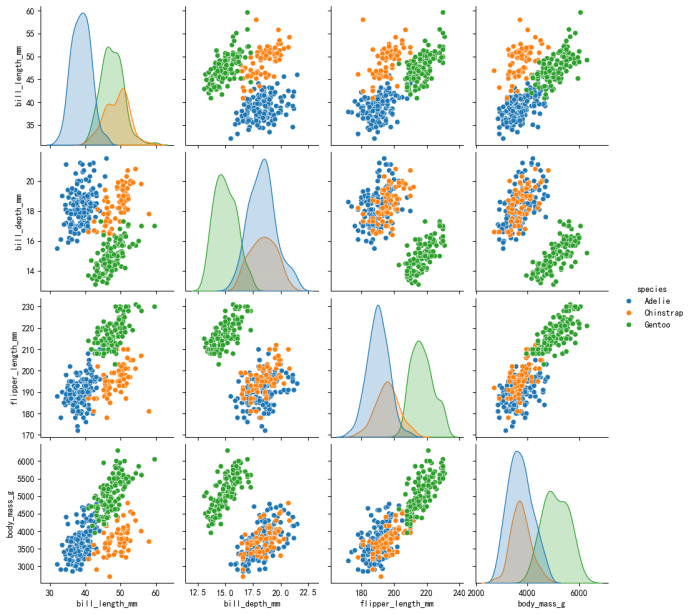
常用参数:
hue: 按某个变量分组,用不同颜色区分
示例代码:
import seaborn as sns
import matplotlib.pyplot as plt
import pandas as pd

# 设置中文字体
plt.rcParams["font.sans-serif"] = ["STHeiti"]

# 加载数据(示例)
penguins = pd.read_csv("data/penguins.csv")
penguins.dropna(inplace=True)

# 成对关系图
sns.pairplot(data=penguins, hue="species")
plt.show()
通常情况下成对关系图左上和右下对应位置的图的信息是相同的,可以通过PairGrid()为每个区域设置不同的图类型。
pair_grid = sns.PairGrid(data=penguins, hue="species")

# 通过 map 方法在网格上绘制不同的图形
pair_grid.map_upper(sns.scatterplot)  # 上三角部分使用散点图
pair_grid.map_lower(sns.kdeplot)  # 下三角部分使用核密度估计图
pair_grid.map_diag(sns.histplot)  # 对角线部分使用直方图
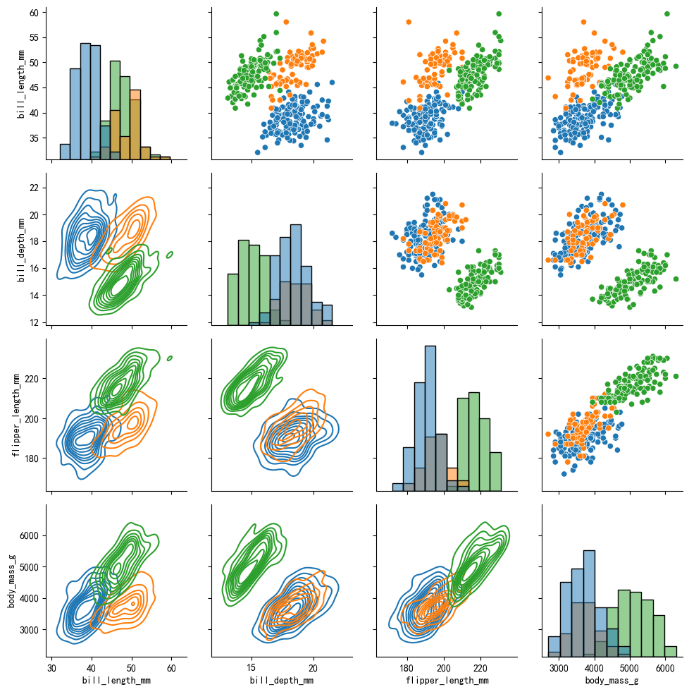
Seaborn 样式
Seaborn 提供了多种内置样式,可以快速改变图表的外观。
设置样式:
# 设置样式
sns.set_style("whitegrid")  # 白色网格背景
sns.set_style("darkgrid")   # 深色网格背景
sns.set_style("white")      # 白色背景
sns.set_style("dark")       # 深色背景
sns.set_style("ticks")      # 带刻度的简洁样式

# 设置调色板
sns.set_palette("husl")     # 设置颜色主题
sns.set_palette("Set2")      # 使用预定义调色板

# 设置上下文(控制图表大小)
sns.set_context("paper")     # 论文大小
sns.set_context("notebook")  # 笔记本大小(默认)
sns.set_context("talk")      # 演讲大小
sns.set_context("poster")    # 海报大小
常用样式组合:
# 设置美观的默认样式
sns.set_style("whitegrid")
sns.set_palette("husl")
sns.set_context("notebook")
Pandas 可视化
Pandas 提供了快速便捷的可视化接口,通过 DataFrame 和 Series 的 .plot() 方法可以快速绘制图表。
导入方式:
import pandas as pd
import matplotlib.pyplot as plt

# 设置中文字体
plt.rcParams["font.sans-serif"] = ["STHeiti"]
单变量可视化
直方图
方法: df['column'].plot(kind='hist') 或 df['column'].hist()
示例代码:
import pandas as pd
import matplotlib.pyplot as plt

# 设置中文字体
plt.rcParams["font.sans-serif"] = ["STHeiti"]

# 创建示例数据
df = pd.DataFrame({
    'age': [20, 25, 30, 35, 40, 45, 50, 25, 30, 35, 40, 45, 30, 35, 40]
})

# 绘制单列的直方图
df['age'].plot(kind='hist', bins=20, title='年龄分布')
plt.xlabel('年龄')
plt.ylabel('频数')
plt.show()

# 等价写法
df['age'].hist(bins=20)
plt.title('年龄分布')
plt.xlabel('年龄')
plt.ylabel('频数')
plt.show()
密度图
方法: df['column'].plot(kind='density') 或 df['column'].plot.kde()
示例代码:
import pandas as pd
import matplotlib.pyplot as plt

# 设置中文字体
plt.rcParams["font.sans-serif"] = ["STHeiti"]

# 创建示例数据
df = pd.DataFrame({
    'age': [20, 25, 30, 35, 40, 45, 50, 25, 30, 35, 40, 45, 30, 35, 40]
})

# 绘制密度图
df['age'].plot(kind='density', title='年龄密度分布')
plt.xlabel('年龄')
plt.ylabel('密度')
plt.show()

# 等价写法
df['age'].plot.kde()
plt.title('年龄密度分布')
plt.xlabel('年龄')
plt.ylabel('密度')
plt.show()
箱线图
方法: df['column'].plot(kind='box') 或 df['column'].plot.box()
示例代码:
import pandas as pd
import matplotlib.pyplot as plt

# 设置中文字体
plt.rcParams["font.sans-serif"] = ["STHeiti"]

# 创建示例数据
df = pd.DataFrame({
    'age': [20, 25, 30, 35, 40, 45, 50, 25, 30, 35, 40, 45, 30, 35, 40]
})

# 绘制箱线图
df['age'].plot(kind='box', title='年龄分布箱线图')
plt.ylabel('年龄')
plt.show()

# 等价写法
df['age'].plot.box()
plt.title('年龄分布箱线图')
plt.ylabel('年龄')
plt.show()
计数图(分类变量)
方法: df['column'].value_counts().plot(kind='bar')
示例代码:
import pandas as pd
import matplotlib.pyplot as plt

# 设置中文字体
plt.rcParams["font.sans-serif"] = ["STHeiti"]

# 创建示例数据
df = pd.DataFrame({
    'category': ['A', 'B', 'A', 'C', 'B', 'A', 'C', 'B', 'A', 'C']
})

# 绘制分类变量的计数图
df['category'].value_counts().plot(kind='bar', title='类别计数')
plt.xlabel('类别')
plt.ylabel('数量')
plt.xticks(rotation=0)
plt.show()
双变量可视化
散点图
方法: df.plot(x='col1', y='col2', kind='scatter')
示例代码:
import pandas as pd
import matplotlib.pyplot as plt

# 设置中文字体
plt.rcParams["font.sans-serif"] = ["STHeiti"]

# 创建示例数据
df = pd.DataFrame({
    'age': [25, 30, 35, 40, 45, 50, 28, 32, 38, 42],
    'salary': [5000, 6000, 8000, 10000, 12000, 15000, 5500, 7000, 9000, 11000]
})

# 绘制散点图
df.plot(x='age', y='salary', kind='scatter', title='年龄与薪资关系')
plt.xlabel('年龄')
plt.ylabel('薪资')
plt.show()
折线图
方法: df.plot(x='col1', y='col2', kind='line') 或 df.plot.line(x='col1', y='col2')
示例代码:
import pandas as pd
import matplotlib.pyplot as plt

# 设置中文字体
plt.rcParams["font.sans-serif"] = ["STHeiti"]

# 创建示例数据
df = pd.DataFrame({
    'date': pd.date_range('2024-01-01', periods=10, freq='D'),
    'sales': [100, 120, 110, 130, 125, 140, 135, 150, 145, 160],
    'profit': [20, 25, 22, 28, 26, 30, 29, 35, 32, 38]
})

# 绘制折线图
df.plot(x='date', y='sales', kind='line', title='销售额趋势')
plt.xlabel('日期')
plt.ylabel('销售额')
plt.xticks(rotation=45)
plt.show()

# 多列折线图
df[['sales', 'profit']].plot(kind='line', title='销售额与利润趋势')
plt.xlabel('索引')
plt.ylabel('数值')
plt.legend(['销售额', '利润'])
plt.show()
条形图
方法: df.plot(x='col1', y='col2', kind='bar') 或 df.plot.bar(x='col1', y='col2')
示例代码:
import pandas as pd
import matplotlib.pyplot as plt

# 设置中文字体
plt.rcParams["font.sans-serif"] = ["STHeiti"]

# 创建示例数据
df = pd.DataFrame({
    'category': ['A', 'B', 'C', 'D'],
    'value': [100, 150, 120, 180]
})

# 绘制条形图
df.plot(x='category', y='value', kind='bar', title='各类别数值')
plt.xlabel('类别')
plt.ylabel('数值')
plt.xticks(rotation=0)
plt.show()

# 水平条形图
df.plot(x='category', y='value', kind='barh', title='各类别数值(水平)')
plt.xlabel('数值')
plt.ylabel('类别')
plt.show()
箱线图(多列对比)
方法: df[['col1', 'col2', 'col3']].plot(kind='box')
示例代码:
import pandas as pd
import matplotlib.pyplot as plt

# 设置中文字体
plt.rcParams["font.sans-serif"] = ["STHeiti"]

# 创建示例数据
df = pd.DataFrame({
    'age': [25, 30, 35, 40, 45, 50, 28, 32, 38, 42],
    'salary': [5000, 6000, 8000, 10000, 12000, 15000, 5500, 7000, 9000, 11000],
    'bonus': [500, 600, 800, 1000, 1200, 1500, 550, 700, 900, 1100]
})

# 绘制多列的箱线图对比
df[['age', 'salary', 'bonus']].plot(kind='box', title='多变量箱线图对比')
plt.ylabel('数值')
plt.xticks(rotation=45)
plt.show()
面积图
方法: df.plot(kind='area')
示例代码:
import pandas as pd
import matplotlib.pyplot as plt

# 设置中文字体
plt.rcParams["font.sans-serif"] = ["STHeiti"]

# 创建示例数据
df = pd.DataFrame({
    'sales': [100, 120, 110, 130, 125, 140, 135, 150],
    'profit': [20, 25, 22, 28, 26, 30, 29, 35]
})

# 绘制面积图
df[['sales', 'profit']].plot(kind='area', stacked=False, title='销售额与利润面积图')
plt.xlabel('索引')
plt.ylabel('数值')
plt.legend(['销售额', '利润'])
plt.show()
一起交流
分享你的思考,让讨论更进一步。