
📍 你在这里 AI 基础 · 第 7 篇 / 共 13 篇
← 上一篇 Python 项目虚拟环境搭建 · 下一篇 → 常见数学符号表
高等数学
导数
导数的概念
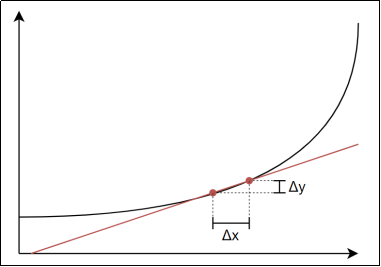
导数(derivative)是微积分中的一个概念。函数在某一点的导数是指这个函数在这一点附近的变化率(即函数在这一点的切线斜率)。导数的本质是通过极限的概念对函数进行局部的线性逼近。
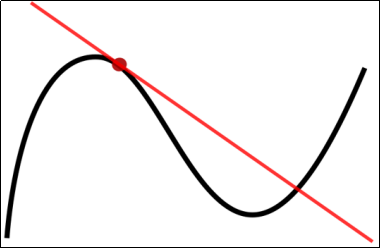
当函数的自变量在一点上产生一个增量$ \Delta x $时,函数输出值的增量与自变量增量的比值在趋于0时的极限如果存在,即为在$ x $处的导数,记作$ f'(x) $、$ \frac{dy}{dx} $或$ y' $。
$ f'(x) = \lim_{\Delta x \to 0} \frac{f(x + \Delta x) - f(x)}{\Delta x} $
例如在运动学中,物体的位移对于时间的导数就是物体的瞬时速度:$ v = \frac{ds}{dt} $。
基本函数的导数
| 说明 | 公式 | 例子 |
|---|---|---|
| 常数的导数 | $ (c)' = 0 $ | $ (5)' = 0 $ |
| 幂函数的导数 | $ (x^n)' = nx^{n-1} $ | $ (x^3)' = 3x^2 $ |
| 指数函数的导数 | $ (a^x)' = a^x \ln a $ | $ (2^x)' = 2^x \ln 2 $ |
| 指数函数的导数 | $ (e^x)' = e^x $ | — |
| 对数函数的导数 | $ (\log_a x)' = \frac{1}{x \ln a} $ | $ (\log_2 x)' = \frac{1}{x \ln 2} $ |
| 对数函数的导数 | $ (\ln x)' = \frac{1}{x} $ | — |
| 三角函数的导数 | $ (\sin x)' = \cos x $ | — |
| 三角函数的导数 | $ (\cos x)' = -\sin x $ | — |
| 三角函数的导数 | $ (\tan x)' = \sec^2 x $ | — |
| 三角函数的导数 | $ (\cot x)' = -\csc^2 x $ | — |
导数的求导法则
| 说明 | 公式 |
|---|---|
| 两函数之和求导 | $ (f + g)' = f' + g' $ |
| 两函数之积求导 | $ (fg)' = f'g + fg' $ |
| 两函数之商求导 | $ (f/g)' = \frac{f'g - fg'}{g^2} $ |
| 复合函数的导数 | 若$ f(x) = h[g(x)] $,则$ f'(x) = h'[g(x)] \cdot g'(x) $ |
例如:求函数$ f(x) = x^3 $在$ x = 2 $处的导数。
$ f'(x) = 3x^2 $
$ f'(2) = 3 \times 2^2 = 12 $
利用导数求极值
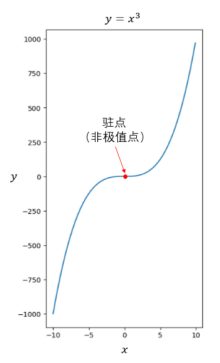
导数等于零的点称为函数的驻点(或极值可疑点),在这类点上函数可能会取得极大值或极小值。进一步判断则需要知道导数在$ x_0 $附近的符号。
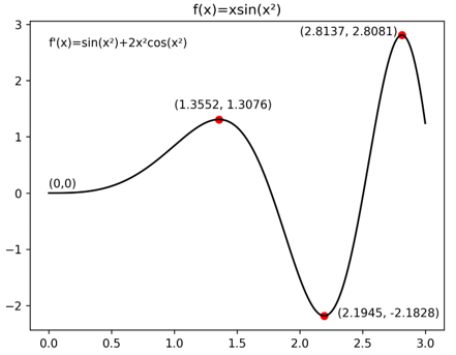
例如,$ f(x) = x^3 $在$ x = 0 $处导数为0,但并不会取得极大值或者极小值。
二阶导数
二阶导数的概念
在微积分中,函数的二阶导数是函数导数的导数。粗略来说,某个量的二阶导数描述该量变化率变化的快慢。例如物体位置对时间的二阶导数是物体的瞬时加速度,即该物体速度随时间的变化率:$ a = \frac{d^2s}{dt^2} $。
函数的二阶导数通常记作$ f''(x) $、$ \frac{d^2y}{dx^2} $或$ y'' $。
二阶导数与函数凹凸的关系
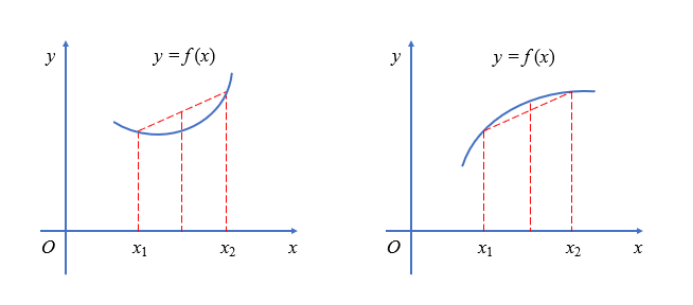
函数的二阶导数描述了函数图像的凹凸方向和程度。若二阶导数在某区间恒为正,则函数在该区间向上弯(也称下凸函数)。反之,若二阶导数在某区间恒为负,则函数在该区间向下弯(也称上凸函数)。
若函数的二阶导数在某点左右异号,则图像由向上弯转为向下弯,或反之。这种点称之为拐点。若二阶导数连续,则在该点处二阶导数为0。但反之二阶导数为0的点不一定是拐点。如$ f(x) = x^4 $,在$ x = 0 $处有$ f''(0) = 0 $,但在实数系上无拐点。
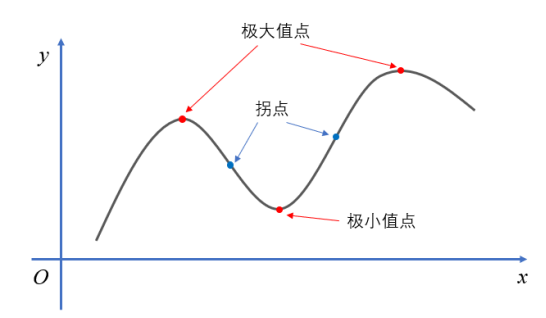
二阶导数与凹凸性的关系有助于判断函数的驻点是否为极大值点或极小值点:
若$ f'(x_0) = 0 $,$ f''(x_0) < 0 $,则在$ x_0 $取得极大值。
若$ f'(x_0) = 0 $,$ f''(x_0) > 0 $,则在$ x_0 $取得极小值。
若$ f'(x_0) = 0 $,$ f''(x_0) = 0 $,则该点可能是拐点,也可能是极大值点或极小值点。
偏导与梯度
偏导数
如果函数的自变量并非单个元素,而是多个元素,例如:
$ f(x, y) = x^2 + xy + y^2 $
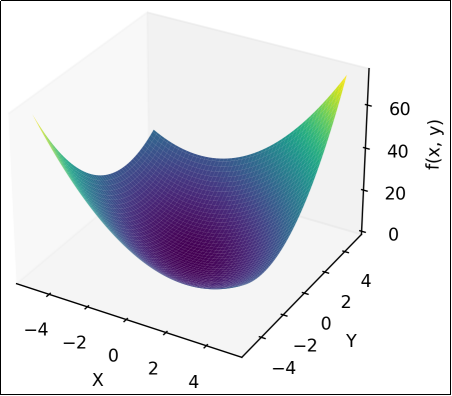
可将其中一个元素看作常数,此时可看作关于另一元素的函数。
例如,将$ x $看作常数,此时$ f $可看作关于$ y $的函数:$ f_x(y) = x^2 + xy + y^2 $。
在$ x = a $固定的情况下,可计算$ f_x $关于$ y $的导数:
$ f'_{x=a}(y) = a + 2y $
这种导数称为偏导数,一般记作:
$ \frac{\partial f}{\partial y}(x, y) = x + 2y $
更一般地来说,一个多元函数$ f(x_1, x_2, \ldots, x_n) $在点$ (a_1, a_2, \ldots, a_n) $处对$ x_i $的偏导数定义为:
$ \frac{\partial f}{\partial x_i}(a_1, a_2, \ldots, a_n) = \lim_{\Delta x_i \to 0} \frac{f(a_1, \ldots, a_i + \Delta x_i, \ldots, a_n) - f(a_1, \ldots, a_i, \ldots, a_n)}{\Delta x_i} $
方向导数
偏导数可以看作是多元函数沿某个自变量轴方向的变化率。
如果我们任意选取一个方向$ l $,那么在某个点$ (x_0, y_0) $处,二元函数$ f(x, y) $沿着这个方向的变化率可以用极限定义为:
$ \frac{\partial f}{\partial l}(x_0, y_0) = \lim_{\Delta l \to 0} \frac{f(x_0 + \Delta x, y_0 + \Delta y) - f(x_0, y_0)}{\Delta l} $
这里,$ \Delta l $就是沿方向$ l $的微小改变量,$ \Delta x $和$ \Delta y $与$ \Delta l $的关系为:
$ \Delta x = \Delta l \cdot \cos \alpha, \quad \Delta y = \Delta l \cdot \cos \beta $
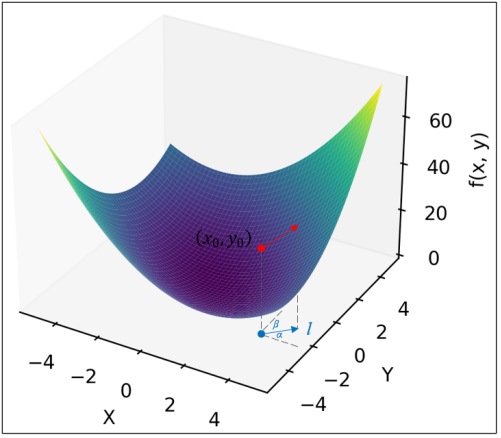
根据全微分公式,上式可以表示为:
$ \frac{\partial f}{\partial l}(x_0, y_0) = f_x(x_0, y_0) \cos \alpha + f_y(x_0, y_0) \cos \beta $
其中$ f_x(x_0, y_0) $、$ f_y(x_0, y_0) $表示点$ (x_0, y_0) $处$ f $对$ x $、$ y $的偏导数;$ \cos \alpha $、$ \cos \beta $是方向$ l $的方向余弦,即$ l $方向的单位方向向量可以表示为$ \mathbf{l}_0 = (\cos \alpha, \cos \beta) $。
这个"沿某个方向的变化率",就被称为沿方向$ l $的方向导数。
梯度
对于多元函数$ f(x_1, x_2, \ldots, x_n) $,如果它在点$ \mathbf{a} = (a_1, a_2, \ldots, a_n) $处关于每个变量$ x_i $都有偏导数$ \frac{\partial f}{\partial x_i}(\mathbf{a}) $,那么这些偏导数定义出一个向量:
$ \nabla f(\mathbf{a}) = \left[\frac{\partial f}{\partial x_1}(\mathbf{a}), \frac{\partial f}{\partial x_2}(\mathbf{a}), \ldots, \frac{\partial f}{\partial x_n}(\mathbf{a})\right] $
这个向量称为在点$ \mathbf{a} $的梯度,记作$ \nabla f(\mathbf{a}) $或者$ \text{grad } f(\mathbf{a}) $。
例如:$ f(x, y) = x^2 + xy + y^2 $在$ (1, 1) $处的梯度为$ \nabla f(1, 1) = [3, 3] $。
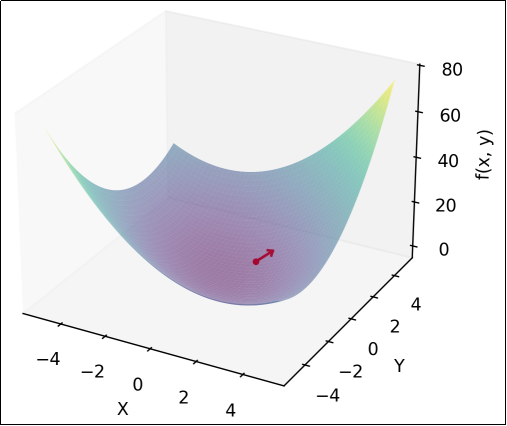
梯度向量表示的方向,就是函数在这一点处,方向导数取最大值的方向。换句话说,梯度的方向,就是函数值变化最快的方向。
线性代数
标量与向量
标量与向量的概念
标量(scalar):标量是一个单独的数,只有大小。
向量(vector):向量由标量组成,有大小有方向。
- 行向量:
$ \mathbf{x}^T = [x_1, x_2, \ldots, x_n] $
- 列向量:
$ \mathbf{x} = \begin{bmatrix} x_1 \ x_2 \ \vdots \ x_n \end{bmatrix} $
向量运算
- 向量转置:列向量转置结果为行向量
$ \mathbf{x} = \begin{bmatrix} x_1 \ x_2 \ \vdots \ x_n \end{bmatrix}, \quad \mathbf{x}^T = [x_1, x_2, \ldots, x_n] $
- 向量相加:对应元素相加
$ \mathbf{x} + \mathbf{y} = [x_1 + y_1, x_2 + y_2, \ldots, x_n + y_n] $
- 向量与标量相乘:标量与向量每个元素相乘
$ c\mathbf{x} = [cx_1, cx_2, \ldots, cx_n] $
- 向量内积:又称向量点乘,两向量对应元素乘积之和,结果为标量
$ \mathbf{x} \cdot \mathbf{y} = \sum_{i=1}^{n} x_i y_i $
- 两向量之间夹角表示为
$ \cos \theta = \frac{\mathbf{x} \cdot \mathbf{y}}{|\mathbf{x}||\mathbf{y}|} $
向量范数
范数(norm)是具有“长度”概念的函数。
- L0范数(也称0范数)
$ |\mathbf{x}|_0 = \text{非零元素的个数} $
- 例如:$ \mathbf{x} = [2, 0, 5, 0, 8] $,则$ |\mathbf{x}|_0 = 3 $。
2. L1范数(也称和范数或1范数)
$ |\mathbf{x}|1 = \sum{i=1}^{n} |x_i| $
- 例如:$ \mathbf{x} = [2, -5, 8] $,则$ |\mathbf{x}|_1 = 2 + 5 + 8 = 15 $。
3. L2范数(也称欧几里得范数或2范数)
$ |\mathbf{x}|2 = \sqrt{\sum{i=1}^{n} x_i^2} $
- 例如:$ \mathbf{x} = [2, 5, 8] $,则$ |\mathbf{x}|_2 = \sqrt{4 + 25 + 64} = \sqrt{93} $。
4. Lp范数
$ |\mathbf{x}|p = \left(\sum{i=1}^{n} |x_i|^p\right)^{1/p} $
- 在numpy中,可以利用linalg.norm 函数方便地计算向量的范数。
矩阵与张量
矩阵的概念
一个$ m \times n $的矩阵(matrix)是一个有m行n列元素的矩形阵列。用$ \mathbb{R}^{m \times n} $表示所有实数矩阵的向量空间。
- 方阵:行数等于列数的矩阵
$ A = \begin{bmatrix} a_{11} & a_{12} & \cdots & a_{1n} \ a_{21} & a_{22} & \cdots & a_{2n} \ \vdots & \vdots & \ddots & \vdots \ a_{n1} & a_{n2} & \cdots & a_{nn} \end{bmatrix} $
- 对角矩阵:主对角线以外元素全为0的方阵
$ \text{diag}(d_1, d_2, \ldots, d_n) = \begin{bmatrix} d_1 & 0 & \cdots & 0 \ 0 & d_2 & \cdots & 0 \ \vdots & \vdots & \ddots & \vdots \ 0 & 0 & \cdots & d_n \end{bmatrix} $
- 单位矩阵:主对角线元素全为1的对角矩阵
$ I = \begin{bmatrix} 1 & 0 & \cdots & 0 \ 0 & 1 & \cdots & 0 \ \vdots & \vdots & \ddots & \vdots \ 0 & 0 & \cdots & 1 \end{bmatrix} $
矩阵乘法
矩阵乘法运算
两个矩阵的乘法仅当矩阵$ A $的列数和矩阵$ B $的行数相等时才能定义。如$ A \in \mathbb{R}^{m \times n} $,$ B \in \mathbb{R}^{n \times p} $,它们的乘积$ C = AB \in \mathbb{R}^{m \times p} $,其中:
$ c_{ij} = \sum_{k=1}^{n} a_{ik} b_{kj} $
例如:
$ A = \begin{bmatrix} 1 & 0 & 2 \ -1 & 3 & 1 \end{bmatrix} \in \mathbb{R}^{2 \times 3}, \quad B = \begin{bmatrix} 3 & 1 \ 2 & 1 \ 1 & 0 \end{bmatrix} \in \mathbb{R}^{3 \times 2} $
$ AB = \begin{bmatrix} 1 \times 3 + 0 \times 2 + 2 \times 1 & 1 \times 1 + 0 \times 1 + 2 \times 0 \ (-1) \times 3 + 3 \times 2 + 1 \times 1 & (-1) \times 1 + 3 \times 1 + 1 \times 0 \end{bmatrix} = \begin{bmatrix} 5 & 1 \ 4 & 2 \end{bmatrix} $
特别地,矩阵与单位矩阵相乘等于矩阵本身:
$ AI = A \quad (A \in \mathbb{R}^{m \times n}, I \in \mathbb{R}^{n \times n}) $或$ IA = A \quad (I \in \mathbb{R}^{n \times n}, A \in \mathbb{R}^{n \times m}) $
例如:
$ A = \begin{bmatrix} 1 & 2 \ 3 & 5 \ 4 & 8 \end{bmatrix} \in \mathbb{R}^{3 \times 2}, \quad I = \begin{bmatrix} 1 & 0 \ 0 & 1 \end{bmatrix} \in \mathbb{R}^{2 \times 2} $
$ AI = \begin{bmatrix} 1 \times 1 + 2 \times 0 & 1 \times 0 + 2 \times 1 \ 3 \times 1 + 5 \times 0 & 3 \times 0 + 5 \times 1 \ 4 \times 1 + 8 \times 0 & 4 \times 0 + 8 \times 1 \end{bmatrix} = \begin{bmatrix} 1 & 2 \ 3 & 5 \ 4 & 8 \end{bmatrix} = A $
矩阵乘法的性质
矩阵乘法满足结合律、左分配律和右分配律。不满足交换律即$ AB \neq BA $。
- 结合律:若$ A \in \mathbb{R}^{m \times n} $,$ B \in \mathbb{R}^{n \times p} $,$ C \in \mathbb{R}^{p \times q} $,则$ (AB)C = A(BC) $
- 左分配律:若$ A \in \mathbb{R}^{m \times n} $,$ B, C \in \mathbb{R}^{n \times p} $,则$ A(B + C) = AB + AC $
- 右分配律:若$ A, B \in \mathbb{R}^{m \times n} $,$ C \in \mathbb{R}^{n \times p} $,则$ (A + B)C = AC + BC $
矩阵转置
矩阵转置运算
矩阵$ A \in \mathbb{R}^{m \times n} $的转置是一个$ n \times m $的矩阵,记为$ A^T $。其中$ A^T $的第$ i $个行向量是原矩阵$ A $的第$ i $个列向量;或者说,转置矩阵$ A^T $第$ i $行第$ j $列的元素是原矩阵$ A $第$ j $行第$ i $列的元素。
数学上可以表示为:
$ [A^T]{ij} = a{ji} $
例如:
$ A = \begin{bmatrix} 1 & 2 \ 3 & 5 \ 4 & 8 \end{bmatrix} \in \mathbb{R}^{3 \times 2}, \quad A^T = \begin{bmatrix} 1 & 3 & 4 \ 2 & 5 & 8 \end{bmatrix} \in \mathbb{R}^{2 \times 3} $
矩阵转置的性质
$ (A^T)^T = A $
$ (A + B)^T = A^T + B^T $
$ (kA)^T = kA^T $
$ (AB)^T = B^T A^T $
矩阵的逆
对于方阵$ A $,如果存在另一个方阵$ A^{-1} $,使得$ AA^{-1} = I $成立,此时$ A^{-1}A = I $也同样成立。称$ A^{-1} $为$ A $的逆矩阵。
例如:
$ A = \begin{bmatrix} 1 & 2 \ 3 & 5 \end{bmatrix}, \quad A^{-1} = \begin{bmatrix} -5 & 2 \ 3 & -1 \end{bmatrix} $
$ AA^{-1} = \begin{bmatrix} 1 & 2 \ 3 & 5 \end{bmatrix} \times \begin{bmatrix} -5 & 2 \ 3 & -1 \end{bmatrix} = \begin{bmatrix} 1 \times (-5) + 2 \times 3 & 1 \times 2 + 2 \times (-1) \ 3 \times (-5) + 5 \times 3 & 3 \times 2 + 5 \times (-1) \end{bmatrix} = \begin{bmatrix} 1 & 0 \ 0 & 1 \end{bmatrix} = I $
其他矩阵运算
- 矩阵的向量化
矩阵$ A \in \mathbb{R}^{m \times n} $的向量化$ \text{vec}(A) $将矩阵$ A $的元素按列排列成一个$ mn \times 1 $的向量。
$ \text{vec}(A) = [a_{11}, \ldots, a_{m1}, a_{12}, \ldots, a_{m2}, \ldots, a_{1n}, \ldots, a_{mn}]^T $
矩阵也可以转化为行向量,称为矩阵的行向量化$ \text{rvec}(A) $。
$ \text{rvec}(A) = [a_{11}, \ldots, a_{1n}, a_{21}, \ldots, a_{2n}, \ldots, a_{m1}, \ldots, a_{mn}] $
例如:
$ A = \begin{bmatrix} 1 & 2 \ 3 & 4 \end{bmatrix} $
- 列向量化:
$ \text{vec}(A) = \begin{bmatrix} 1 \ 3 \ 2 \ 4 \end{bmatrix} $
- 行向量化:
$ \text{rvec}(A) = (1, 2, 3, 4) $
- 矩阵的内积
矩阵$ A \in \mathbb{R}^{m \times n} $和矩阵$ B \in \mathbb{R}^{m \times n} $的内积记作$ (A, B) $,它是两个矩阵对应元素乘积之和,是一个标量。
$ (A, B) = (\text{vec}(A), \text{vec}(B)) = \sum_{i=1}^{m} \sum_{j=1}^{n} a_{ij} b_{ij} $
- 矩阵的Hadamard积
矩阵$ A \in \mathbb{R}^{m \times n} $和矩阵$ B \in \mathbb{R}^{m \times n} $的Hadamard积记作$ A \odot B $,它是两个矩阵对应元素的乘积,是一个$ m \times n $的矩阵。
$ (A \odot B){ij} = a{ij} b_{ij} $
- 矩阵的Kronecker积
矩阵$ A \in \mathbb{R}^{m \times n} $和矩阵$ B \in \mathbb{R}^{p \times q} $的Kronecker积记作$ A \otimes B $,它是矩阵$ A $中每个元素与矩阵$ B $的乘积,是一个$ mp \times nq $的矩阵。
$ (A \otimes B){ij} = [a{ij} B]_{i=1,j=1}^{m,n} $
$ A \otimes B = \begin{bmatrix} a_{11}B & a_{12}B & \cdots & a_{1n}B \ a_{21}B & a_{22}B & \cdots & a_{2n}B \ \vdots & \vdots & \ddots & \vdots \ a_{m1}B & a_{m2}B & \cdots & a_{mn}B \end{bmatrix} $
Kronecker积也称为直积或张量积。
张量
张量(tensor)可视为多维数组,是标量,1维向量和2维矩阵的n维推广。
例如:3维张量
$ \mathcal{T} \in \mathbb{R}^{d_1 \times d_2 \times d_3} $
矩阵求导
矩阵求导的本质是:函数对变元的每个元素分别求导后,将结果按向量/矩阵的结构重新组织呈现(而非简单的"数值导数",而是保留向量/矩阵的维度形式)。
为精准理解,先对「变元(自变量)」和「函数」做统一的符号与定义规范:
- 变元的符号规则
+ 实向量变元
设 $ \mathbf{x} = [x_1, x_2, \dots, x_m]^T \in \mathbb{R}^m $。
解释:$ [x_1, x_2, \dots, x_m] $ 是行形式的元素列表,上标 $ T $ 表示转置,转置后将行向量转化为 $ m $ 维列向量(线性代数中向量默认以"列优先"形式参与运算,保证矩阵乘法等操作的维度一致性)。
- 实矩阵变元
设 $ \mathbf{X} \in \mathbb{R}^{m \times n} $(原文符号表述存在小瑕疵,修正后逻辑为:$ \mathbf{X} $ 是 $ m $ 行 $ n $ 列的实矩阵,可理解为"由 $ n $ 个 $ m $ 维列向量 $ \mathbf{x}_1, \mathbf{x}_2, \dots, \mathbf{x}_n $ 按列拼接而成",即 $ \mathbf{X} = [\mathbf{x}_1 \ \mathbf{x}_2 \ \dots \ \mathbf{x}_n] $,其中每个 $ \mathbf{x}_i \in \mathbb{R}^m $ 是列向量)。
- 函数的分类与符号规则
依据函数输出维度和变元类型(向量/矩阵),函数可分为以下4类:
| 函数类型 | 输出维度 | 变元类型 | 核心含义 |
|---|---|---|---|
| 实标量函数(向量变元) | $ f(\mathbf{x}) \in \mathbb{R} $ | 实向量 $ \mathbf{x} $ | 输入是 $ m $ 维列向量,输出是单个实数 |
| 实标量函数(矩阵变元) | $ f(\mathbf{X}) \in \mathbb{R} $ | 实矩阵 $ \mathbf{X} $ | 输入是 $ m \times n $ 实矩阵,输出是单个实数 |
| 实向量函数(向量变元) | $ f(\mathbf{x}) \in \mathbb{R}^p $ | 实向量 $ \mathbf{x} $ | 输入是 $ m $ 维列向量,输出是 $ p $ 维列向量 |
| 实向量函数(矩阵变元) | $ f(\mathbf{X}) \in \mathbb{R}^p $ | 实矩阵 $ \mathbf{X} $ | 输入是 $ m \times n $ 实矩阵,输出是 $ p $ 维列向量 |
此外,函数还可直接以矩阵形式 $ \mathbf{F} $ 存在(即输出为矩阵)——此时可将其视为"实向量函数的高维扩展"(若把向量理解为"单列矩阵",则矩阵函数是"多列向量的堆叠")。
典型计算场景
- 标量对向量求导
数学上,一般定义向量为列向量形式。由于$ f(\mathbf{x}) = f(x_1, x_2, \ldots, x_n) $,所以
它对向量变元$ \mathbf{x} $求导,本质就是对$ \mathbf{x} $的每个元素求偏导:
$ \frac{\partial f}{\partial \mathbf{x}} = \begin{bmatrix} \frac{\partial f}{\partial x_1} \ \frac{\partial f}{\partial x_2} \ \vdots \ \frac{\partial f}{\partial x_n} \end{bmatrix} $
例如:
函数$ f(\mathbf{x}) = x_1^2 + 2x_1x_2 + x_2^2 $,令$ \mathbf{x} = [x_1, x_2]^T $,则
$ \frac{\partial f}{\partial \mathbf{x}} = \begin{bmatrix} 2x_1 + 2x_2 \ 2x_1 + 2x_2 \end{bmatrix} $
- 标量对矩阵求导
变元$ X $是一个$ m \times n $的矩阵,可以看成是$ m $个行向量的组合,每个向量维度为$ n $。
那么$ f $对$ X $求导,同样也是对其中的每个元素求导,结果形状与$ X $相同:
$ \frac{\partial f}{\partial X} = \begin{bmatrix} \frac{\partial f}{\partial x_{11}} & \frac{\partial f}{\partial x_{12}} & \cdots & \frac{\partial f}{\partial x_{1n}} \ \frac{\partial f}{\partial x_{21}} & \frac{\partial f}{\partial x_{22}} & \cdots & \frac{\partial f}{\partial x_{2n}} \ \vdots & \vdots & \ddots & \vdots \ \frac{\partial f}{\partial x_{m1}} & \frac{\partial f}{\partial x_{m2}} & \cdots & \frac{\partial f}{\partial x_{mn}} \end{bmatrix} $
- 向量对标量求导
对于向量函数$ \mathbf{f}(x) $,可以写为:
$ \mathbf{f}(x) = \begin{bmatrix} f_1(x) \ f_2(x) \ \vdots \ f_m(x) \end{bmatrix} $
显然,此时的$ \mathbf{f} $可以看作多个函数的组合,对$ x $求导时,只要让其中的每个元素分别对$ x $求导即可:
$ \frac{d\mathbf{f}}{dx} = \begin{bmatrix} \frac{df_1}{dx} \ \frac{df_2}{dx} \ \vdots \ \frac{df_m}{dx} \end{bmatrix} $
例如:
函数$ \mathbf{f}(x) = \begin{bmatrix} x^2 \ 2x \ 3 \end{bmatrix} $,则
$ \frac{d\mathbf{f}}{dx} = \begin{bmatrix} 2x \ 2 \ 0 \end{bmatrix} $
- 向量对向量求导(了解)
类似(3)中的分析,向量函数$ \mathbf{f}(\mathbf{x}) $可以写为:
$ \mathbf{f}(\mathbf{x}) = \begin{bmatrix} f_1(\mathbf{x}) \ f_2(\mathbf{x}) \ \vdots \ f_m(\mathbf{x}) \end{bmatrix} $
这里$ \mathbf{f} $的每一个元素$ f_i $,都是变元$ \mathbf{x} $为向量的实标量函数。
接下来只要应用(1)中的结论,将$ \mathbf{f} $中的每个标量函数对$ \mathbf{x} $求导即可:
$ \frac{\partial \mathbf{f}}{\partial \mathbf{x}} = \begin{bmatrix} \frac{\partial f_1}{\partial x_1} & \frac{\partial f_1}{\partial x_2} & \cdots & \frac{\partial f_1}{\partial x_n} \ \frac{\partial f_2}{\partial x_1} & \frac{\partial f_2}{\partial x_2} & \cdots & \frac{\partial f_2}{\partial x_n} \ \vdots & \vdots & \ddots & \vdots \ \frac{\partial f_m}{\partial x_1} & \frac{\partial f_m}{\partial x_2} & \cdots & \frac{\partial f_m}{\partial x_n} \end{bmatrix} $
常用求导结果
| 函数类型 | 求导结果 |
|---|---|
| 标量对向量 | $ \frac{\partial (\mathbf{x}^T \mathbf{a})}{\partial \mathbf{x}} = \frac{\partial (\mathbf{a}^T \mathbf{x})}{\partial \mathbf{x}} = \mathbf{a} $ |
| 标量对向量 | $ \frac{\partial (\mathbf{x}^T \mathbf{x})}{\partial \mathbf{x}} = 2\mathbf{x} $ |
| 标量对向量 | $ \frac{\partial (A\mathbf{x})}{\partial \mathbf{x}} = A^T $ |
| 标量对向量 | $ \frac{\partial (\mathbf{x}^T A)}{\partial \mathbf{x}} = A $ |
| 标量对向量 | $ \frac{\partial (\mathbf{x}^T A \mathbf{x})}{\partial \mathbf{x}} = (A^T + A)\mathbf{x} $ |
| 标量对矩阵 | $ \frac{\partial (\mathbf{a}^T X \mathbf{b})}{\partial X} = \mathbf{a}\mathbf{b}^T $ |
| 标量对矩阵 | $ \frac{\partial (\mathbf{a}^T X^T \mathbf{b})}{\partial X} = \frac{\partial (\mathbf{b}^T X \mathbf{a})}{\partial X} = \mathbf{b}\mathbf{a}^T $ |
| 标量对矩阵 | $ \frac{\partial (\mathbf{a}^T X X^T \mathbf{b})}{\partial X} = \mathbf{a}\mathbf{b}^T X + \mathbf{b}\mathbf{a}^T X $ |
| 标量对矩阵 | $ \frac{\partial (\mathbf{a}^T X^T X \mathbf{b})}{\partial X} = X\mathbf{b}\mathbf{a}^T + X\mathbf{a}\mathbf{b}^T $ |
梯度矩阵
梯度是各个维度上偏导矢量构成的向量和,方向就是该点最大的变化方向。
对于实向量变元$ \mathbf{x} $,实标量函数$ f(\mathbf{x}) $的梯度向量,为$ \mathbf{x} $的列向量(与$ \mathbf{x} $形状相同):
$ \nabla f(\mathbf{x}) = \frac{\partial f}{\partial \mathbf{x}} = \begin{bmatrix} \frac{\partial f}{\partial x_1} \ \frac{\partial f}{\partial x_2} \ \vdots \ \frac{\partial f}{\partial x_n} \end{bmatrix} $
对于矩阵变元$ X $,可以类似地得到$ f(X) $的梯度矩阵:
$ \nabla f(X) = \frac{\partial f}{\partial X} = \begin{bmatrix} \frac{\partial f}{\partial x_{11}} & \frac{\partial f}{\partial x_{12}} & \cdots & \frac{\partial f}{\partial x_{1n}} \ \frac{\partial f}{\partial x_{21}} & \frac{\partial f}{\partial x_{22}} & \cdots & \frac{\partial f}{\partial x_{2n}} \ \vdots & \vdots & \ddots & \vdots \ \frac{\partial f}{\partial x_{m1}} & \frac{\partial f}{\partial x_{m2}} & \cdots & \frac{\partial f}{\partial x_{mn}} \end{bmatrix} $
类似地,$ f(\mathbf{x}) $的二阶偏导构成的矩阵被称为"黑塞矩阵"(Hessian Matrix):
$ H(f) = \nabla^2 f(\mathbf{x}) = \begin{bmatrix} \frac{\partial^2 f}{\partial x_1^2} & \frac{\partial^2 f}{\partial x_1 \partial x_2} & \cdots & \frac{\partial^2 f}{\partial x_1 \partial x_n} \ \frac{\partial^2 f}{\partial x_2 \partial x_1} & \frac{\partial^2 f}{\partial x_2^2} & \cdots & \frac{\partial^2 f}{\partial x_2 \partial x_n} \ \vdots & \vdots & \ddots & \vdots \ \frac{\partial^2 f}{\partial x_n \partial x_1} & \frac{\partial^2 f}{\partial x_n \partial x_2} & \cdots & \frac{\partial^2 f}{\partial x_n^2} \end{bmatrix} $
概率论
概率
概率的概念
概率是对事件发生的可能性的度量。通常将事件A的概率写作$ P(A) $,且$ P(A) \in [0, 1] $。
概率的计算
| 事件 | 概率 |
|---|---|
| A | $ P(A) \in [0, 1] $ |
| 非A | $ P(\bar{A}) = 1 - P(A) $ |
| A和B(联合概率) | $ P(A \cap B) = P(A |
| A或B | $ P(A \cup B) = P(A) + P(B) - P(A \cap B) $;当$ A $、$ B $互斥时:$ P(A \cup B) = P(A) + P(B) $ |
| B的情况下A的概率(条件概率) | $ P(A |
例如:现有一个装有10个球的袋子,其中有6个红球和4个蓝球。从中随机抽取两个球。我们定义以下事件:
- 事件A:第一个抽到的是红球。
- 事件B:两个抽到的球都是红球。
1. 计算联合概率
第一个球是红球的概率:$ P(A) = \frac{6}{10} = \frac{3}{5} $
在第一个球是红球的情况下,两个球都是红球的概率:$ P(B|A) = \frac{5}{9} $
联合概率:$ P(A \cap B) = P(A) \cdot P(B|A) = \frac{6}{10} \cdot \frac{5}{9} = \frac{1}{3} $
- 计算条件概率
条件概率$ P(A|B) $表示在已知两个球都是红球的情况下,第一个球是红球的概率。
两个球都是红球的概率:
$ P(B) = \frac{C_6^2}{C_{10}^2} = \frac{6 \times 5 \div 2}{10 \times 9 \div 2} = \frac{1}{3} $
在两个球都是红球的情况下,第一个球是红球的概率:
$ P(A|B) = \frac{P(A \cap B)}{P(B)} = \frac{1/3}{1/3} = 1 $
条件概率公式 $ P(A|B) = P(A \cap B) / P(B) $ 为什么需要除以 $ P(B) $?
我们可以从以下几个角度逐步拆解:
- 明确条件概率的场景
条件概率 $ P(A|B) $ 描述的是「在事件 $ B $ 已经发生的条件下,事件 $ A $ 发生的概率」。关键在于「$ B $ 发生」这个条件,它把原来的样本空间 $ \Omega $ 缩小到了只包含事件 $ B $ 中的结果。
- 从频率近似概率的角度理解
假设进行了 $ n $ 次重复试验:
- 如果事件 $ B $ 发生了 $ m $ 次,那么 $ P(B) \approx m/n $。
- 如果事件 $ A $ 和 $ B $ 同时发生了 $ k $ 次,那么 $ P(A \cap B) \approx k/n $。
问题是:「在这 $ m $ 次 $ B $ 发生的试验中,$ A $ 也发生了多少次?」这个比例就是 $ k/m $。
进一步推导:$ k/m = (k/n) / (m/n) = P(A \cap B) / P(B) $。
结论:$ P(A|B) $ 本质上是在「缩小后的样本空间」(即 $ B $ 发生的情况)中,$ A $ 所占的比例。除以 $ P(B) $ 是为了进行「样本空间的缩放」,因为 $ P(B) $ 衡量了 $ B $ 在原始空间中的「权重」。
- 从古典概率模型的角度验证
假设样本空间 $ \Omega $ 有 $ N $ 个等可能的基本事件:
- 如果事件 $ B $ 包含 $ M $ 个基本事件,那么 $ P(B) = M/N $。
- 如果事件 $ A \cap B $ 包含 $ K $ 个基本事件,那么 $ P(A \cap B) = K/N $。
当「$ B $ 发生」时,样本空间缩小到 $ B $ 的 $ M $ 个基本事件。在这 $ M $ 个事件中,$ A $ 发生了 $ K $ 次,所以 $ P(A|B) = K/M $。
进一步推导:$ K/M = (K/N) / (M/N) = P(A \cap B) / P(B) $,这与频率角度的理解是一致的。
- 反例:为什么 $ P(A|B) $ 不能直接等于 $ P(A \cap B) $?
用一个具体例子说明:
假设袋子里有 5 个球(编号 1-5),其中 3 个红球(1, 2, 4),2 个蓝球(3, 5)。
- 事件 $ A $:「抽到红球」。
- 事件 $ B $:「抽到的球编号 > 3」。
- $ A \cap B $:「抽到编号 > 3 的红球」(只有球 4),所以 $ P(A \cap B) = 1/5 $。
- $ P(B) $:「抽到编号 > 3 的球」(球 4, 5),所以 $ P(B) = 2/5 $。
如果 $ P(A|B) $ 直接等于 $ P(A \cap B) $,那么 $ P(A|B) = 1/5 $。
但实际上,如果我们已知「球编号 > 3」(即 $ B $ 发生),样本空间就缩小到了球 4 和球 5。在这个缩小后的空间中,只有球 4 是红球,所以实际概率应该是 $ 1/2 $。
使用公式 $ P(A|B) = P(A \cap B) / P(B) = (1/5) / (2/5) = 1/2 $,这与缩小样本空间后的实际概率一致。
总结:为什么要除以 $ P(B) $?
- $ P(A|B) $ 的核心在于「$ B $ 发生后,样本空间缩小到了 $ B $ 对应的结果集合」。
- $ P(B) $ 衡量了 $ B $ 在原始样本空间中的「比例」。除以 $ P(B) $ 就是把「原始样本空间的度量」缩放到「$ B $ 的度量」,从而得到「$ B $ 发生时 $ A $ 的相对比例」。
- 直接使用 $ P(A \cap B) $ 忽略了「$ B $ 发生」对样本空间的限制,给出的是「$ A $ 和 $ B $ 同时发生」的绝对概率,而不是条件概率。
- 简单来说:条件概率求的是「$ A $ 在 $ B $ 中的比例」,所以要用「$ A \cap B $ 在 $ B $ 中的比例」,而 $ P(B) $ 作为 $ B $ 在原始空间中的「权重」,实现了这种「比例缩放」。
概率分布
概率分布,是指用于表述随机变量取值的概率规律。事件的概率表示了一次试验中某一个结果发生的可能性大小。如果试验结果用变量X的取值来表示,则随机试验的概率分布就是随机变量的概率分布,即随机变量的可能取值及取得对应值的概率。
均匀分布
均匀分布也叫矩形分布,它表示在相同长度间隔的分布概率是等可能的。均匀分布由两个参数$ a $和$ b $定义,它们是数轴上的最小值和最大值,通常缩写为$ U(a, b) $。
均匀分布的概率密度函数可写为:
$ f(x) = \begin{cases} \frac{1}{b-a} & a < x < b \ 0 & \text{其他} \end{cases} $
正态分布
正态分布(Normal Distribution)也称高斯分布,是常见的连续概率分布。正态分布在统计学上十分重要,经常用在自然和社会科学来代表一个不明的随机变量。
若随机变量$ X $服从一个平均数为$ \mu $、标准差为$ \sigma $(方差为$ \sigma^2 $)的正态分布,则记为$ X \sim N(\mu, \sigma^2) $。
标准差$ \sigma $的计算公式为:
$ \sigma = \sqrt{\frac{1}{n} \sum_{i=1}^{n} (x_i - \mu)^2} $
其概率密度函数为:
$ f(x) = \frac{1}{\sigma\sqrt{2\pi}} e^{-\frac{(x-\mu)^2}{2\sigma^2}} $
正态分布的期望$ \mu $可解释为位置参数,决定了分布的位置;其方差$ \sigma^2 $可解释为尺度参数,决定了分布的幅度。
正态分布概率密度函数图:
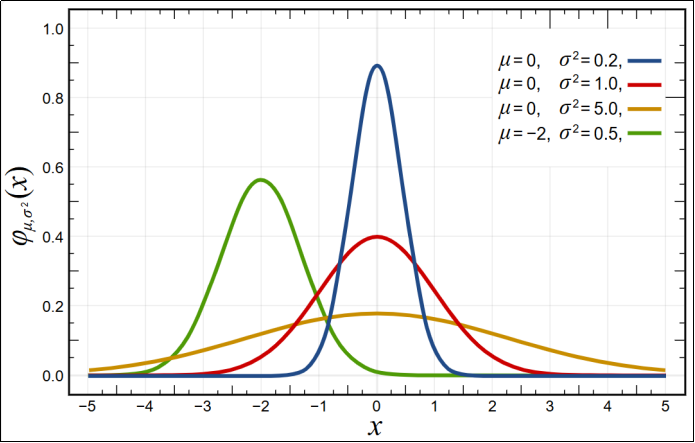
正态分布的概率密度函数曲线呈钟形,因此人们又经常称之为钟形曲线。我们通常所说的标准正态分布是位置参数$ \mu = 0 $,尺度参数$ \sigma = 1 $的正态分布$ N(0, 1) $。
中心极限定理指出,在特定条件下,一个具有有限均值和方差的随机变量的多个样本的平均值本身就是一个随机变量,其分布随着样本数量的增加而收敛于正态分布。因此,许多与独立过程总和有关的物理量,例如测量误差,通常可被近似为正态分布。
在numpy中,提供了各种随机函数,可以用来生成服从特定分布的数据。
贝叶斯定理
贝叶斯定理(Bayes' Theorem)是概率论中的一个核心定理,用于描述在已有条件概率信息的基础上,如何更新或计算事件的概率。它以英国数学家托马斯·贝叶斯的名字命名。贝叶斯定理特别适合处理"逆向概率"问题,即从结果反推原因的概率。
全概率公式
对于复杂事件B,它可能有很多种具体情况,发生概率不容易直接求得。
这些不同的具体情况可以是一组简单事件,记作A1、A2、…、An,发生的概率P(Ai) 已知;如果它们满足两两互不相容、且发生概率之和为 1,就称它们是一个完备事件组。
这样,如果知道了在每个简单事件发生的前提下、复杂事件发生的概率(条件概率 P(B| Ai) ),就可以将它们全部合并起来,求出复杂事件的概率了。
这个公式就被称为"全概率公式"。
$ P(B) = P(B|A_1) \cdot P(A_1) + P(B|A_2) \cdot P(A_2) + \cdots + P(B|A_n) \cdot P(A_n) = \sum_{i=1}^{n} P(B|A_i) \cdot P(A_i) $
贝叶斯公式
贝叶斯定理建立在条件概率的基础上,假设有两事件$ A $和$ B $,贝叶斯定理描述了在已知$ B $发生的情况下,$ A $发生的概率(通常 B 是果,A 是因):
$ P(A|B) = \frac{P(B|A) P(A)}{P(B)} $
$ P(A|B) $:后验概率,$ B $发生的情况下$ A $发生的概率。
$ P(B|A) $:似然概率,$ A $发生的情况下$ B $发生的概率。
$ P(A) $:先验概率,$ A $发生的概率。
$ P(B) $:$ B $发生的概率,通常通过全概率公式计算。
在实际问题中通常$ P(B) $不是直接给出,而是需要通过全概率公式计算。假设样本空间被一组互斥且完备的事件$ A_1, A_2, \ldots, A_n $划分,则:
$ P(A_i|B) = \frac{P(B|A_i) P(A_i)}{\sum_{j=1}^{n} P(B|A_j) P(A_j)} $
例如:某疾病发病率为1%,如果一个人有疾病,检测呈阳性的概率为95%;如果一个人没有疾病,检测呈阳性的概率为5%,现有一人检测结果呈阳性,问他真正患病的概率是多少?
$ P(\text{患病}|\text{阳性}) = \frac{P(\text{阳性}|\text{患病}) P(\text{患病})}{P(\text{阳性})} $
首先计算$ P(\text{阳性}) $:
$ P(\text{阳性}) = P(\text{阳性}|\text{患病}) \cdot P(\text{患病}) + P(\text{阳性}|\text{无疾病}) \cdot P(\text{无疾病}) $
$ = 0.95 \times 0.01 + 0.05 \times 0.99 $
$ = 0.0095 + 0.0495 = 0.059 $
然后计算$ P(\text{患病}|\text{阳性}) $:
$ P(\text{患病}|\text{阳性}) = \frac{0.0095}{0.059} \approx 0.161 $
检测呈阳性的人真正患病的概率为16.1%。
似然函数
基本概念
概率用于在已知一些参数的情况下,预测接下来在观测上所得到的结果。而似然性则是用于在已知某些观测所得到的结果时,对有关事物之性质的参数进行估值。
似然函数是对参数的函数,其定义为在给定参数值的条件下,观察到某个特定数据的概率。换句话说,似然函数是一个关于参数的函数,而不是关于数据的函数。
如果我们有一个参数化的概率模型,其中$ X $是观测数据,$ \theta $是模型参数,似然函数定义为:
$ L(\theta|X) = P(X|\theta) $
这里,$ P(X|\theta) $表示在参数为$ \theta $的情况下,观察到数据$ X $的概率。
设有一组独立同分布的观测数据$ \mathbf{X} = (x_1, x_2, \ldots, x_n) $,并且这些数据服从某个分布(例如正态分布、二项分布等),比如服从参数为$ \theta $的某个分布,那么似然函数可以写作:
$ L(\theta|\mathbf{X}) = P(\mathbf{X}|\theta) = \prod_{i=1}^{n} P(x_i|\theta) $
针对其中存在的乘法,可以使用对数函数将其转化为加法:
$ \ell(\theta|\mathbf{X}) = \log L(\theta|X) = \log \left( \prod_{i=1}^{n} P(x_i|\theta) \right) = \sum_{i=1}^{n} \log P(x_i|\theta) $
要理解似然函数及其公式推导,可以从概率与似然的区别、独立同分布的联合概率、对数转换的意义这三个层面逐步拆解:
一、概率与似然:视角的转换
先明确两个核心概念的区别:
- 概率 (Probability):已知模型的参数(比如抛硬币正面概率 $ p $),预测"观测数据出现的结果"。公式表示为 $ P(X|\theta) $,其中 $ X $ 是观测数据,$ \theta $ 是模型参数。
- 似然 (Likelihood):已知观测数据的结果(比如抛了3次硬币都是正面),反推"模型参数的可能性"。公式表示为 $ L(\theta|X) $,它本质上是把"概率 $ P(X|\theta) $"当作关于参数 $ \theta $ 的函数,重点关注"参数 $ \theta $ 如何影响已知数据 $ X $ 出现的概率"。
二、似然函数的定义(以独立同分布为例)
假设我们有一组独立同分布 (i.i.d.) 的观测数据 $ X = (x_1, x_2, \dots, x_n) $,且每个数据都服从由参数 $ \theta $ 决定的概率分布(比如正态分布、二项分布等)。
- 独立事件的联合概率
根据概率论中"独立事件"的性质:若多个事件相互独立,它们的联合概率等于各自概率的乘积。
对于独立同分布的数据 $ x_1, x_2, \dots, x_n $,每个 $ x_i $ 出现的概率由参数 $ \theta $ 决定(即 $ P(x_i|\theta) $)。因此,所有数据同时出现的联合概率为:
$ P(X|\theta) = P(x_1, x_2, \dots, x_n|\theta) = P(x_1|\theta) \cdot P(x_2|\theta) \dots P(x_n|\theta) $
用连乘符号简化后:
$ P(X|\theta) = \prod_{i=1}^{n} P(x_i|\theta) $
- 似然函数的引入
似然函数 $ L(\theta|X) $ 的定义是:在"观测到数据 $ X $"的条件下,参数 $ \theta $ 对应的"可能性"。而这种"可能性"恰好可以用"已知 $ \theta $ 时 $ X $ 出现的概率 $ P(X|\theta) $"来衡量。因此,似然函数直接定义为:
$ L(\theta|X) = P(X|\theta) = \prod_{i=1}^{n} P(x_i|\theta) $
三、对数转换:从"连乘"到"求和"
似然函数是连乘形式 ($ \prod $),但连乘在实际计算中存在两个问题:
- 数值下溢:若数据量 $ n $ 很大,或多个 $ P(x_i|\theta) $ 是小于1的小数,连乘结果会趋近于0,导致计算误差。
- 求导复杂:若要对似然函数求最大值(如"最大似然估计"),连乘的导数需用"乘积法则",计算繁琐。
因此,我们利用对数的性质 ($ \log(ab) = \log a + \log b $),将"连乘"转换为"求和",简化计算:
$ \log L(\theta|X) = \log \left( \prod_{i=1}^{n} P(x_i|\theta) \right) = \sum_{i=1}^{n} \log P(x_i|\theta) $
极大似然估计
似然函数常用于极大似然估计。我们希望找到使似然函数最大化的参数。这意味着在给定观测数据的情况下,选择最可能生成这些数据的参数值。
例如,掷硬币3次,2次正面1次背面,能否依据此结果逆推出正面的概率;正面概率为0.5的概率为多少、正面概率为0.6的概率为多少;最有可能的正面概率是多少?
我们用$ \theta $代表硬币正面朝上的概率,用$ X $代表2次正面1次背面的结果。
似然函数为:
$ L(\theta|X) = P(X|\theta) = C_3^2 \theta^2 (1-\theta) $
当正面概率为0.5时:
$ P(X|\theta=0.5) = C_3^2 \times 0.5^2 \times (1-0.5) = 0.375 $
当正面概率为0.6时:
$ P(X|\theta=0.6) = C_3^2 \times 0.6^2 \times (1-0.6) = 0.432 $
为了找出极大似然估计,对似然函数取对数并求导,使其等于0:
$ \ell(\theta|X) = \ln L(\theta|X) = \ln(C_3^2 \cdot \theta^2 (1-\theta)) = \ln 3 + 2\ln\theta + \ln(1-\theta) $
$ \frac{d\ell(\theta|X)}{d\theta} = \frac{2}{\theta} - \frac{1}{1-\theta} = 0 $
解得$ \theta = \frac{2}{3} $,意味着当掷硬币3次,出现2次正面1次背面的结果时,硬币正面朝上的概率最有可能为$ \frac{2}{3} $。
推断「硬币正面朝上的概率 $ \theta $」具体流程步骤如下:
(1) 确定概率模型:二项分布
- 每次掷硬币是独立的伯努利试验(只有"正面"或"背面"两种结果),且"正面"的概率固定为 $ \theta $,"背面"概率为 $ 1-\theta $。
- 若进行 $ n $ 次独立试验,"成功(比如正面)$ k $ 次"的概率服从二项分布,公式为:
$ P(X = k|n, \theta) = C_n^k \cdot \theta^k \cdot (1-\theta)^{n-k} $
- 其中 $ C_n^k = \frac{n!}{k!(n-k)!} $ 是"从 $ n $ 次中选 $ k $ 次成功"的组合数。
- 在例子中:$ n=3 $(掷3次),$ k=2 $(2次正面),因此"观测到2正1反"的概率为:
$ P(X = 2|3, \theta) = C_3^2 \cdot \theta^2 \cdot (1-\theta)^{3-2} = 3\theta^2 (1-\theta) $
(2) 似然函数的定义
- 似然函数 $ L(\theta|X) $ 的本质是「给定观测数据 $ X $ 时,参数 $ \theta $ 对应概率的大小」。
- 在例子中,观测数据 $ X $ 是"2次正面1次背面",因此似然函数就是上述二项分布的概率(因为我们假设"观测到 $ X $"时,参数 $ \theta $ 对应的概率就是似然值):
$ L(\theta|X) = P(X|\theta) = 3\theta^2 (1-\theta) $
(3) 回答例子中的问题
"正面概率为0.5的概率为多少、正面概率为0.6的概率为多少?"
- 这里的"概率"其实是「当 $ \theta=0.5 $ 或 $ \theta=0.6 $ 时,观测到"2正1反"的似然值」(即"如果真实 $ \theta $ 是0.5,观测到2正1反的可能性多大?")。
- 计算得:
- 当 $ \theta=0.5 $ 时,$ L(0.5|X) = 3 \times (0.5)^2 \times (1-0.5) = 0.375 $
- 当 $ \theta=0.6 $ 时,$ L(0.6|X) = 3 \times (0.6)^2 \times (1-0.6) = 0.432 $
"最有可能的正面概率是多少?"(即极大似然估计)
- 我们需要找到 $ \theta \in [0,1] $,使得似然函数 $ L(\theta|X) = 3\theta^2(1-\theta) $ 最大。
- 方法:对 $ L(\theta) $ 求导,找极值点。
- 展开 $ L(\theta) = 3\theta^2 - 3\theta^3 $
- 求导:$ L'(\theta) = 6\theta - 9\theta^2 $
- 令导数为0,解方程 $ 6\theta - 9\theta^2 = 0 $,得 $ \theta=0 $ 或 $ \theta=\frac{2}{3} \approx 0.6667 $。
- 验证极大值:当 $ \theta=0 $ 或 $ \theta=1 $ 时,$ L(\theta)=0 $;当 $ \theta=\frac{2}{3} $ 时,$ L(\frac{2}{3}) = 3 \times (\frac{2}{3})^2 \times (1-\frac{2}{3}) = \frac{4}{9} \approx 0.4444 $,是最大值。
- 因此,最有可能的正面概率是 $ \frac{2}{3} $,这就是极大似然估计的结果。
"""
似然函数与极大似然估计可视化
演示:掷硬币3次,2次正面1次背面
"""

import numpy as np
import matplotlib.pyplot as plt
import matplotlib
import platform
import warnings
warnings.filterwarnings('ignore')

# 导入 scipy.special.comb,如果不可用则使用替代方案
try:
    from scipy.special import comb
except ImportError:
    print("警告: scipy 未安装,将使用替代的组合数计算方法")
    def comb(n, k):
        """计算组合数 C(n,k) = n!/(k!(n-k)!)"""
        if k > n or k < 0:
            return 0
        if k == 0 or k == n:
            return 1
        # 使用递推公式避免大数计算
        result = 1
        for i in range(min(k, n-k)):
            result = result * (n - i) // (i + 1)
        return result

# 设置中文字体(改进版)
def setup_chinese_font():
    """设置中文字体,支持多平台"""
    system = platform.system()
    if system == 'Windows':
        fonts = ['SimHei', 'Microsoft YaHei', 'KaiTi', 'FangSong']
    elif system == 'Darwin':  # macOS
        fonts = ['Arial Unicode MS', 'PingFang SC', 'STHeiti', 'Heiti SC']
    else:  # Linux
        fonts = ['WenQuanYi Micro Hei', 'WenQuanYi Zen Hei', 'Noto Sans CJK SC', 'DejaVu Sans']

    # 尝试设置字体
    try:
        plt.rcParams['font.sans-serif'] = fonts + ['DejaVu Sans']
        plt.rcParams['axes.unicode_minus'] = False
        # 测试字体是否可用
        fig_test = plt.figure(figsize=(1, 1))
        ax_test = fig_test.add_subplot(111)
        ax_test.text(0.5, 0.5, '测试', fontsize=10)
        plt.close(fig_test)
    except Exception as e:
        print(f"字体设置警告: {e}")
        plt.rcParams['font.sans-serif'] = ['DejaVu Sans']
        plt.rcParams['axes.unicode_minus'] = False

setup_chinese_font()

# 定义似然函数 L(θ|X) = 3θ²(1-θ)
def likelihood(theta):
    """似然函数:L(θ|X) = 3θ²(1-θ)"""
    return 3 * theta**2 * (1 - theta)

# 定义似然函数的导数 L'(θ) = 6θ - 9θ²
def likelihood_derivative(theta):
    """似然函数的导数:L'(θ) = 6θ - 9θ²"""
    return 6 * theta - 9 * theta**2

# 创建图形
fig = plt.figure(figsize=(16, 10))

# ========== 子图1:似然函数曲线 ==========
ax1 = plt.subplot(2, 2, 1)
theta = np.linspace(0, 1, 1000)
L_theta = likelihood(theta)

# 绘制似然函数曲线
ax1.plot(theta, L_theta, 'b-', linewidth=2.5, label=r'似然函数 $L(\theta|X) = 3\theta^2(1-\theta)$')

# 标注关键点
theta_points = [0.5, 0.6, 2/3]
colors = ['green', 'orange', 'red']
labels = [r'$\theta=0.5$', r'$\theta=0.6$', r'$\hat{\theta}=2/3$ (MLE)']
markers = ['o', 's', 'D']
annotations = [
    (15, 25),   # theta=0.5 的标注位置
    (15, 25),   # theta=0.6 的标注位置
    (15, -50)   # MLE 的标注位置
]

for i, (t, color, label, marker, (xoff, yoff)) in enumerate(zip(theta_points, colors, labels, markers, annotations)):
    L_val = likelihood(t)
    ax1.plot(t, L_val, marker, color=color, markersize=12,
             markeredgecolor='black', markeredgewidth=1.5, zorder=5)
    # 简化标注文本,避免显示问题
    if i < 2:
        annot_text = f'{label}\nL({t:.2f}|X)={L_val:.4f}'
    else:
        annot_text = f'{label}\nL(0.67|X)={L_val:.4f}'

    ax1.annotate(annot_text,
                xy=(t, L_val), xytext=(xoff, yoff),
                textcoords='offset points', fontsize=9,
                bbox=dict(boxstyle='round,pad=0.4', facecolor='yellow', alpha=0.8, edgecolor='black', linewidth=1),
                arrowprops=dict(arrowstyle='->', connectionstyle='arc3,rad=0.2', color='black', lw=1.2))

# 添加最大值线
mle_theta = 2/3
mle_value = likelihood(mle_theta)
ax1.axvline(x=mle_theta, color='red', linestyle='--', linewidth=1.5, alpha=0.5, label='MLE位置')
ax1.axhline(y=mle_value, color='red', linestyle='--', linewidth=1.5, alpha=0.5)

ax1.set_xlabel(r'参数 $\theta$ (正面概率)', fontsize=12)
ax1.set_ylabel(r'似然值 $L(\theta|X)$', fontsize=12)
ax1.set_title('似然函数曲线(观测数据:3次掷币,2正1反)', fontsize=13, fontweight='bold')
ax1.grid(True, alpha=0.3, linestyle='--', linewidth=0.8)
ax1.legend(loc='upper right', fontsize=10, framealpha=0.9)
ax1.set_xlim([0, 1])
ax1.set_ylim([0, 0.5])

# ========== 子图2:似然函数的导数 ==========
ax2 = plt.subplot(2, 2, 2)
L_prime = likelihood_derivative(theta)

# 绘制导数曲线
ax2.plot(theta, L_prime, 'r-', linewidth=2.5, label=r"导数 $L'(\theta) = 6\theta - 9\theta^2$")
ax2.axhline(y=0, color='black', linestyle='-', linewidth=1.2, alpha=0.6)
ax2.axvline(x=0, color='black', linestyle='-', linewidth=1.2, alpha=0.6)

# 标注导数为0的点
zero_points = [0, 2/3]
zero_labels = [r'$\theta=0$', r'$\theta=2/3$']
zero_yoffsets = [25, 25]
for t, label, yoff in zip(zero_points, zero_labels, zero_yoffsets):
    ax2.plot(t, 0, 'ro', markersize=10, markeredgecolor='black', markeredgewidth=1.5, zorder=5)
    ax2.annotate(label,
                xy=(t, 0), xytext=(0, yoff),
                textcoords='offset points', fontsize=10,
                bbox=dict(boxstyle='round,pad=0.4', facecolor='lightblue', alpha=0.8, edgecolor='black', linewidth=1),
                ha='center')

ax2.set_xlabel(r'参数 $\theta$', fontsize=12)
ax2.set_ylabel(r"导数 $L'(\theta)$", fontsize=12)
ax2.set_title('似然函数的导数(用于找极值点)', fontsize=13, fontweight='bold')
ax2.grid(True, alpha=0.3, linestyle='--', linewidth=0.8)
ax2.legend(loc='upper right', fontsize=10, framealpha=0.9)
ax2.set_xlim([0, 1])

# ========== 子图3:不同θ值下的似然值对比 ==========
ax3 = plt.subplot(2, 2, 3)
theta_values = [0.3, 0.4, 0.5, 0.6, 2/3, 0.7, 0.8]
likelihood_values = [likelihood(t) for t in theta_values]
colors_bar = ['blue' if t != 2/3 else 'red' for t in theta_values]

bars = ax3.bar(range(len(theta_values)), likelihood_values, color=colors_bar, alpha=0.7, edgecolor='black', linewidth=1.2)
ax3.set_xticks(range(len(theta_values)))
# 简化标签显示
xtick_labels = []
for t in theta_values:
    if abs(t - 2/3) < 1e-6:
        xtick_labels.append(r'$2/3$')
    else:
        xtick_labels.append(f'${t:.2f}$')
ax3.set_xticklabels(xtick_labels, fontsize=10)
ax3.set_ylabel(r'似然值 $L(\theta|X)$', fontsize=12)
ax3.set_xlabel(r'参数 $\theta$', fontsize=12)
ax3.set_title('不同θ值下的似然值对比', fontsize=13, fontweight='bold')
ax3.grid(True, alpha=0.3, axis='y', linestyle='--', linewidth=0.8)

# 在柱状图上标注数值
for i, (bar, val) in enumerate(zip(bars, likelihood_values)):
    height = bar.get_height()
    ax3.text(bar.get_x() + bar.get_width()/2., height,
            f'{val:.3f}', ha='center', va='bottom', fontsize=9)

# ========== 子图4:二项分布概率分布(辅助理解) ==========
ax4 = plt.subplot(2, 2, 4)
n = 3  # 掷硬币次数
k = 2  # 正面次数
theta_range = np.linspace(0, 1, 100)

# 计算不同θ值下,观测到k次正面的概率(即似然值)
prob_k_heads = [comb(n, k) * (t**k) * ((1-t)**(n-k)) for t in theta_range]

# 简化标签,避免显示问题
label_text = rf'$P(X={k}|n={n}, \theta) = C_{{{n}}}^{{{k}}} \theta^{{{k}}} (1-\theta)^{{{n-k}}}$'
ax4.plot(theta_range, prob_k_heads, 'purple', linewidth=2.5, label=label_text)

# 标注MLE点
ax4.plot(mle_theta, likelihood(mle_theta), 'ro', markersize=12,
         markeredgecolor='black', markeredgewidth=1.5, zorder=5,
         label=rf'MLE: $\hat{{\theta}}={mle_theta:.3f}$')

ax4.set_xlabel(r'参数 $\theta$ (正面概率)', fontsize=12)
ax4.set_ylabel(r'概率 $P(X=k|n, \theta)$', fontsize=12)
ax4.set_title(f'二项分布:$n={n}$次试验,$k={k}$次成功', fontsize=13, fontweight='bold')
ax4.grid(True, alpha=0.3, linestyle='--', linewidth=0.8)
ax4.legend(loc='upper right', fontsize=9, framealpha=0.9)
ax4.set_xlim([0, 1])

plt.tight_layout(pad=2.0)

# 保存图形
try:
    plt.savefig('似然函数可视化.png', dpi=300, bbox_inches='tight', facecolor='white', edgecolor='none')
    print("✓ 图形已保存为 '似然函数可视化.png'")
except Exception as e:
    print(f"保存图形时出错: {e}")
    try:
        plt.savefig('似然函数可视化.png', dpi=200, bbox_inches='tight')
        print("✓ 已使用较低分辨率保存")
    except:
        print("✗ 无法保存图形文件")

# 显示图形
try:
    plt.show()
except Exception as e:
    print(f"显示图形时出错: {e}")
    print("提示:如果无法显示图形窗口,请检查是否在支持图形界面的环境中运行")

# ========== 打印数值结果 ==========
print("\n" + "="*60)
print("数值计算结果")
print("="*60)
print(f"观测数据:3次掷币,2次正面,1次背面")
print(f"似然函数:L(θ|X) = 3θ²(1-θ)")
print(f"\n关键点的似然值:")
print(f"  θ = 0.5 时,L(0.5|X) = {likelihood(0.5):.4f}")
print(f"  θ = 0.6 时,L(0.6|X) = {likelihood(0.6):.4f}")
print(f"  θ = 2/3 时,L(2/3|X) = {likelihood(2/3):.4f} (最大值,MLE)")
print(f"\n极大似然估计:θ̂ = {mle_theta:.4f} ≈ {mle_theta:.2%}")
一起交流
分享你的思考,让讨论更进一步。