
📍 你在这里 AI 基础 · 第 9 篇 / 共 13 篇
第一章 机器学习概述
基本介绍
机器学习主要研究计算机系统对于特定任务的性能,逐步进行改善的算法和统计模型。通过输入海量训练数据对模型进行训练,使模型掌握数据所蕴含的潜在规律,进而对新输入的数据进行准确的分类或预测。
机器学习是一门多领域交叉学科,涉及概率论、统计学、逼近论、凸优化、算法复杂度理论等多门学科。
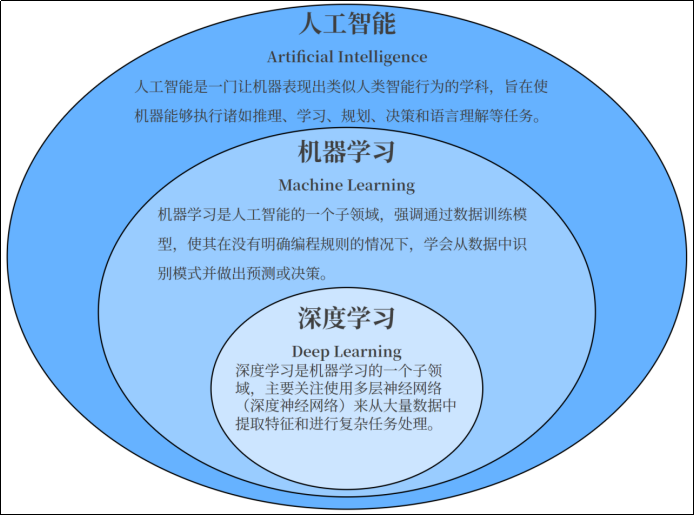
人工智能、机器学习与深度学习
人工智能(AI)是计算机科学的一个广泛领域,目标是让机器具备类人的“智能“,包括自然语言处理(NLP)、计算机视觉、机器人技术、专家系统等等;具体实现手段多种多样,包括规则系统、符号逻辑、统计方法、机器学习等。
机器学习(Machine Learning, ML)是AI的一个子领域,核心是通过数据驱动,让计算机进行学习并改进性能,自动发现规律(模式),并利用这些规律进行预测或决策。
深度学习(Deep Learning,DL)是机器学习的一个子领域,基于多层神经网络处理复杂任务。
发展历史
早期探索:20世纪50-70年代
人工智能研究处于“推理期“,人们认为只要能赋予机器逻辑推理能力,机器就能具有智能。
- 图灵提出“图灵测试“,定义机器智能的基本标准
- 弗兰克·罗森布拉特提出感知机算法,这是最早的人工神经网络模型之一,用于线性分类问题
- 亚瑟·李·塞谬尔提出“机器学习“一词,并设计了一个用于玩跳棋的学习算法
知识驱动与专家系统:20世纪70-80年代
随着研究推进,人们逐渐认识到,仅具有逻辑推理能力是远远实现不了人工智能的。部分人认为,要使机器具有智能,就必须设法使机器拥有知识。计算机硬件逐步发展,人工智能的研究进入以规则为主的“知识驱动“阶段。
- 出现众多专家系统,如MYCIN(用于医疗诊断)
- 引入了决策树(如ID3算法)
- 统计学习理论开始成形,例如贝叶斯定理在机器学习中的应用
数据驱动与统计学习:20世纪80年代-21世纪
专家系统面临“知识工程瓶颈“。机器学习成为一个独立的学科领域,各种机器学习技术百花初绽。基于神经网络的连接主义逐步发展,但其局限性也开始凸显。统计学习登场并占据主流,代表技术是支持向量机。互联网的发展带来了大量数据,统计学方法逐渐成为机器学习的核心。
- 决策树算法得到进一步发展(如C4.5算法)
- 支持向量机(SVM)被提出,成为一种强大的分类工具
- 无监督学习方法开始成熟,例如K-means聚类
- 随机森林和Boosting方法(如AdaBoost)引入,提升了集成学习的性能
深度学习崛起:21世纪初
随着计算能力(特别是GPU的发展)和数据规模的快速增长,深度学习技术得以崛起。深度神经网络主导,突破了图像、语音和文本领域的性能瓶颈。
- 深度信念网络(DBN)被提出,标志着深度学习研究的复兴
- AlexNet在ImageNet图像分类竞赛中获胜,证明了卷积神经网络(CNN)的强大性能
- 生成对抗网络(GAN)被提出,用于生成图像和其他生成任务
- Transformer架构在论文《Attention is All You Need》中提出,彻底改变了自然语言处理领域
大模型与通用人工智能:2020年代
深度学习进入规模化应用阶段,大语言模型和多模态模型的出现推动了机器学习的新高潮。模型参数规模空前,技术以通用性和泛化能力为目标。
- 自然语言处理:如OpenAI的GPT系列模型、Google的BERT
- 多模态模型:如OpenAI的CLIP、DeepMind的Gato
- 自监督学习成为重要方向,降低了对人工标注数据的依赖
- 强化学习和深度学习结合,应用于AlphaGo、AlphaFold等项目
应用领域
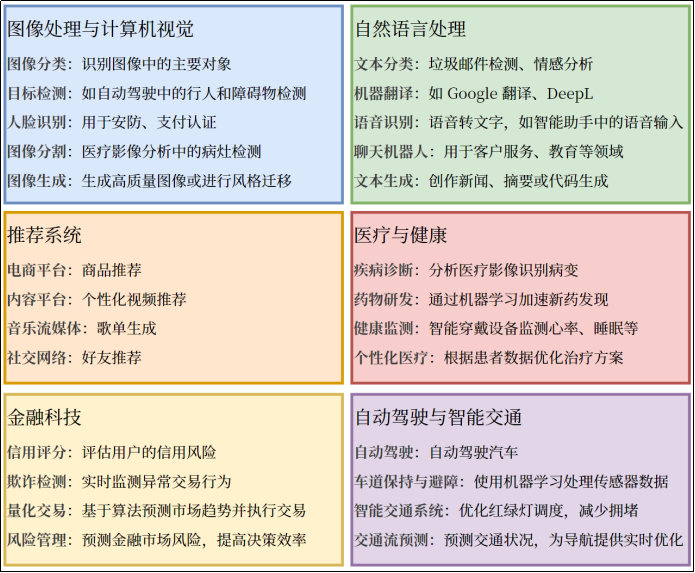
今天,在计算机科学的诸多分支学科领域中,无论是多媒体、图形学,还是网络通信、软件工程,乃至体系结构、芯片设计,都能找到机器学习技术的身影,尤其是在计算机视觉、自然语言处理等计算机应用技术领域,机器学习已成为最重要的技术进步源泉之一,并为许多交叉学科提供了重要的技术支撑。
基本术语
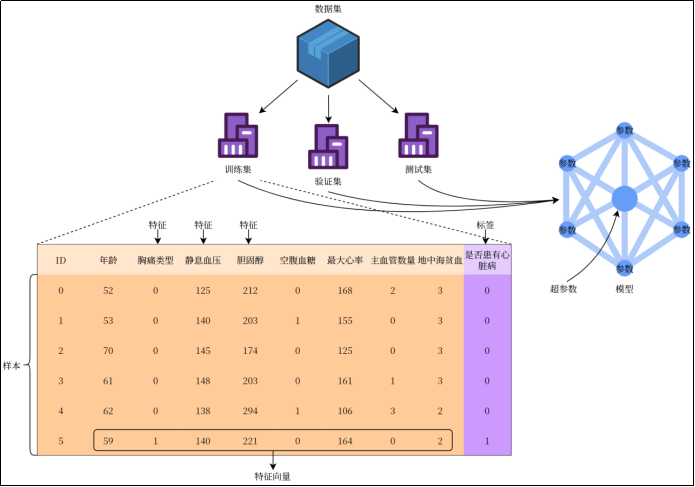
- 数据集(Data Set):多条记录的集合。
- 训练集(Training Set):用于训练模型的数据。
- 验证集(Validation Set):用于调节超参数的数据。
- 测试集(Test Set):用于评估模型性能的数据。
- 样本(Sample):数据集中的一条记录是关于一个事件或对象的描述,称为一个样本。
- 特征(Feature):数据集中一列反映事件或对象在某方面的表现或性质的事项,称为特征或属性。
- 特征向量(Feature Vector):将样本的所有特征表示为向量的形式,输入到模型中。
- 标签(Label):监督学习中每个样本的结果信息,也称作目标值(target)。
- 模型(Model):一个机器学习算法与训练后的参数集合,用于进行预测或分类。
- 参数(Parameter):模型通过训练学习到的值,例如线性回归中的权重和偏置。
- 超参数(Hyper Parameter):由用户设置的参数,不能通过训练自动学习,例如学习率、正则化系数等。
第二章 基本理论
机器学习三要素
机器学习的方法一般主要由三部分构成:模型、策略和算法,可以认为:
机器学习方法 = 模型 + 策略 + 算法
- 模型(model):总结数据的内在规律,用数学语言描述的参数系统
- 策略(strategy):选取最优模型的评价准则
- 算法(algorithm):选取最优模型的具体方法
机器学习方法分类
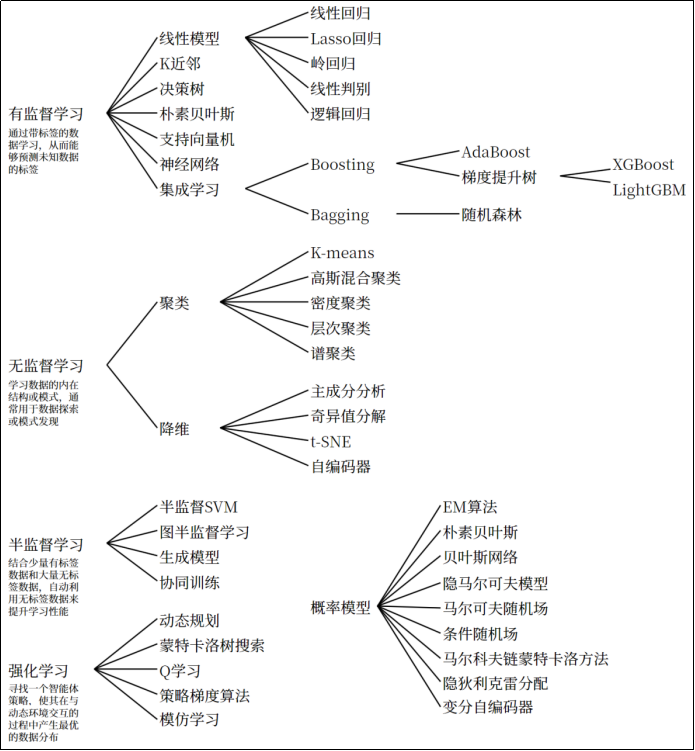
机器学习的方法种类繁多,并不存在一个统一的理论体系能够涵盖所有内容。从不同的角度,可以将机器学习的方法进行不同的分类:
通常分类:按照有无监督,机器学习可以分为 有监督学习、无监督学习 和 半监督学习,除此之外还有 强化学习。
- 有监督学习:使用带有标签(Label)的训练数据,让模型学习“输入(Input)→ 输出(Output)”的映射关系,从而对新的未知数据进行预测。其本质是“从已知答案中学习规律”。
- 无监督学习:使用无标签的训练数据,让模型自动发现数据中的内在结构、模式或分布(如聚类、降维、异常检测)。其本质是“从数据本身寻找规律”。
- 半监督学习:同时使用少量有标签数据和大量无标签数据,让模型在“标签指导”下学习无标签数据的结构,从而提升预测性能。其本质是“用少量标签撬动大量无标签数据”。
- 强化学习:智能体(Agent)通过与环境(Environment)交互,根据环境的奖励信号(Reward) 调整行为策略,最终学会在特定环境下做出最优决策(最大化长期累积奖励)。其本质是“从试错中学习”。
按模型分类:根据模型性质,可以分为概率模型/非概率模型,线性/非线性模型等。
按学习技巧分类:根据算法基于的技巧,可以分为贝叶斯学习、核方法等。
各种类型的机器学习方法可以用下图汇总展示:
建模流程
机器学习是由数据驱动的,核心是利用数据来“训练模型“;模型训练的结果需要用一定的方法来进行评估、优化,最终得到一个成熟的学习模型;最后就可以用这个模型来进行预测和解决问题了。
总结监督学习建模的整体流程如下:
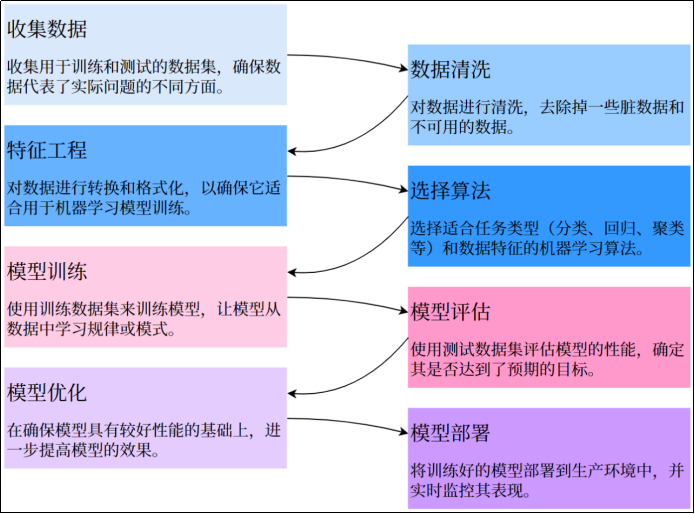
- 收集数据:获取建模“原材料”。
- 收集训练集+测试集,确保数据覆盖实际问题的多元场景(如不同时间、群体、场景下的样本),为后续环节提供有代表性的数据基础。
- 数据清洗:提升数据质量。
- 过滤“脏数据”(如错误值、重复值、缺失值)或完全不可用的无效数据,减少噪声对模型的干扰,保障后续分析可靠性。
- 特征工程:让数据“适配模型”。
- 对清洗后的数据做转换、格式化(如特征缩放、编码、降维、构造新特征等),使数据满足机器学习模型的输入要求(如算法对数值范围、维度、稀疏性的偏好)。
- 选择算法:匹配“任务+数据”选工具。
- 依据任务类型(分类、回归、聚类等)和数据特征(规模、维度、分布、线性可分性等),挑选适配的机器学习算法(如逻辑回归、随机森林、K - means等)。
- 模型训练:让模型“学规律”。
- 用训练数据集输入模型,通过算法迭代优化模型参数,使模型从数据中捕捉规律、模式(如分类任务的决策边界、回归任务的拟合曲线)。
- 模型评估:检验“学习效果”。
- 用未参与训练的测试数据集,通过指标(如准确率、MSE、AUC等)评估模型性能,判断是否达预期(是否过拟合/欠拟合?精度是否满足业务需求?)。
- 模型优化:“打磨”模型性能。
- 若评估不达标,在“模型效果较好”的基础上优化(如调参、换算法、增数据、改进特征工程等),持续提升模型泛化能力与精度。
- 模型部署:让模型“落地生效”。
- 将训练+优化后的模型推至生产环境(如线上服务、业务系统),并实时监控其在真实场景的表现(因实际数据分布可能变化,需持续维护、迭代模型)。
第三章 特征工程
基本介绍
特征工程(Feature Engineering)是机器学习过程中非常重要的一步,指的是通过对原始数据的处理、转换和构造,生成新的特征或选择有效的特征,从而提高模型的性能。简单来说,特征工程是将原始数据转换为可以更好地表示问题的特征形式,帮助模型更好地理解和学习数据中的规律。优秀的特征工程可以显著提高模型的表现;反之,忽视特征工程可能导致模型性能欠佳。
实际上,特征工程是一个迭代过程。特征工程取决于具体情境。它需要大量的数据分析和领域知识。其中的原因在于,特征的有效编码可由所用的模型类型、预测变量与输出之间的关系以及模型要解决的问题来确定。在此基础上,辅以不同类型的数据集(如文本与图像)则可能更适合不同的特征工程技术。因此,要具体说明如何在给定的机器学习算法中最好地实施特征工程可能并非易事。
核心内容
特征选择
特征选择(Feature Selection)是从原始特征中挑选出与目标变量关系最密切的特征,剔除冗余、无关或噪声特征的过程。这样可以减少模型的复杂度、加速训练过程、并减少过拟合的风险。
重要特点:
- 特征选择不会创建新特征,也不会改变数据结构
- 只保留原始特征的一个子集
- 可以显著提高模型的可解释性
对于一个模型来说,有些特征可能很关键,而有些特征可能用处不大。
例如:
- 某个特征取值较接近,变化很小,可能与结果无关。
- 某几个特征相关性较高,可能包含冗余信息。
因此,特征选择 在特征工程中是最基本、也最常见的操作。
特征选择方法分类:
- 过滤法(Filter Method):基于统计测试来评估特征与目标变量之间的关系,选择最相关的特征。这种方法独立于机器学习算法,计算速度快,适合作为初步筛选。
- 方差过滤:删除方差低于阈值的特征(如低方差过滤法)
- 相关系数法:计算特征与目标变量的相关性(如皮尔逊相关系数、斯皮尔曼相关系数)
- 卡方检验:用于分类问题,评估类别特征与目标变量的独立性
- 互信息:衡量特征与目标变量之间的信息量
- F 检验:用于回归问题,评估特征与目标变量的线性关系强度
- 包裹法(Wrapper Method):使用模型来评估特征的重要性,并根据模型的表现进行特征选择。这种方法会尝试不同的特征子集,选择使模型性能最优的特征组合。
- 递归特征消除(RFE, Recursive Feature Elimination):递归地移除最不重要的特征
- 前向选择(Forward Selection):逐步添加特征,直到模型性能不再提升
- 后向消除(Backward Elimination):从全部特征开始,逐步移除最不重要的特征
- 双向搜索(Bidirectional Search):结合前向选择和后向消除
- 嵌入法(Embedded Method):使用模型本身的特征选择机制(如决策树的特征重要性,L1正则化的特征选择)来选择最重要的特征。这种方法在模型训练过程中同时进行特征选择,结合了过滤法和包裹法的优点。
- L1正则化(Lasso):通过L1正则化使部分特征的权重变为0,实现特征选择
- 决策树特征重要性:基于决策树(如随机森林、XGBoost)计算特征重要性
- 弹性网络(Elastic Net):结合L1和L2正则化
- 基于树模型的特征选择:使用树模型(如随机森林、梯度提升树)的特征重要性评分
低方差过滤法
对于特征的选择,可以直接基于方差来判断,这是最简单的。低方差的特征意味着该特征的所有样本值几乎相同,对预测影响极小,可以将其去掉。
from sklearn.feature_selection import VarianceThreshold

# 低方差过滤:删除方差低于 0.01 的特征
var_thresh = VarianceThreshold(threshold=0.01)
X_filtered = var_thresh.fit_transform(X)
相关系数法
通过计算特征与目标变量或特征之间的相关性,筛选出高相关性特征(与目标相关)或剔除冗余特征(特征间高度相关)。
皮尔逊相关系数
皮尔逊相关系数(Pearson Correlation)用于衡量两个变量的线性相关性,取值范围 [-1, 1]。
- 正相关:值接近1,说明特征随目标变量增加而增加。
- 负相关:值接近-1,说明特征随目标变量增加而减少。
- 无关:值接近0,说明特征和目标变量无明显关系。
例如,现有一数据集包括不同渠道广告投放金额与销售额。
使用 pandas.DataFrame.corrwith(method=“pearson“) 计算各个特征与标签间的皮尔逊相关系数:
import pandas as pd

advertising = pd.read_csv("data/advertising.csv")
advertising.drop(advertising.columns[0], axis=1, inplace=True)
advertising.dropna(inplace=True)
X = advertising.drop("Sales", axis=1)
y = advertising["Sales"]

# 计算皮尔逊相关系数
print(X.corrwith(y, method="pearson"))
# TV          0.782224
# Radio       0.576223
# Newspaper   0.228299
# dtype: float64
使用 pandas.DataFrame.corr(method=“pearson“) 计算皮尔逊相关系数矩阵:
import seaborn as sns
import matplotlib.pyplot as plt

# 计算皮尔逊相关系数矩阵
corr_matrix = advertising.corr(method="pearson")

# 可视化热力图
sns.heatmap(corr_matrix, annot=True, cmap="coolwarm", fmt=".2f")
plt.title("Feature Correlation Matrix")
plt.show()
斯皮尔曼相关系数
斯皮尔曼相关系数(Spearman's Rank Correlation Coefficient)的定义是等级变量之间的皮尔逊相关系数。用于衡量两个变量之间的单调关系,即当一个变量增加时,另一个变量是否总是增加或减少(不要求是线性关系)。适用于非线性关系或数据不符合正态分布的情况。
其中:
- $ d_i $ 是两个变量的等级之差
- $ n $ 是样本数
斯皮尔曼相关系数的取值范围为 [-1, 1]:
- $ +1 $:完全正相关(一个变量增加,另一个变量也总是增加)。
- $ -1 $:完全负相关(一个变量增加,另一个变量总是减少)。
- $ 0 $:无相关性。
例如,现有一组每周学习时长与数学考试成绩的数据:
按数值由小到大排出 $ X $、$ Y $ 的等级,并计算等级差:
使用 pandas.DataFrame.corrwith(method=“spearman“) 计算斯皮尔曼相关系数:
import pandas as pd

# 每周学习时长
X = [[5], [8], [10], [12], [15], [3], [7], [9], [14], [6]]
# 数学考试成绩
y = [55, 65, 70, 75, 85, 50, 60, 72, 80, 58]

# 计算斯皮尔曼相关系数
X = pd.DataFrame(X)
y = pd.Series(y)
print(X.corrwith(y, method="spearman"))
# 0.987879
特征转换
特征转换(Feature Transformation)是对数据进行数学或统计处理,使其变得更加适合模型的输入要求。不同的模型对数据分布有不同的假设,特征转换可以帮助数据满足这些假设。
数值特征转换
- 归一化(Normalization):将特征缩放到特定的范围(通常是0到1之间)。适用于对尺度敏感的模型(如KNN、SVM)。公式为:
$ X_{norm} = \frac{X - X_{min}}{X_{max} - X_{min}} $
- 适用场景:
- 对尺度敏感的模型(如KNN、SVM、神经网络)
- 特征具有明确的上下界
- 需要保持特征之间的相对关系
2. 标准化(Standardization / Z-score Normalization):通过减去均值$ \mu $并除以标准差$ \sigma $,使特征的分布具有均值 0,标准差 1。公式为:
$ X_{std} = \frac{X - \mu}{\sigma} $
- 适用场景:
- 线性模型(如逻辑回归、线性回归)
- 特征分布接近正态分布
- 特征没有明确的上下界
3. 对数变换(Log Transformation):对于有偏态的分布(如收入、价格等),对数变换可以将其转化为更接近正态分布的形式。公式为:
$ X_{log} = \log(X + 1) (加1是为了处理0值) $
- 适用场景:
- 右偏分布的数据(长尾分布)
- 特征值范围很大(几个数量级)
- 需要稳定方差的数据
- 多项式转换:将原始特征转换为多项式形式的过程,实现特征空间的扩展,让线性模型能够拟合非线性关系。例如:
# 原始特征
x = [[2], [3]]  # shape: (2, 1)

# degree=2 多项式转换后
# [1, x, x^2]
[[1, 2, 4],
 [1, 3, 9]]     # shape: (2, 3)
- 适用场景:当数据存在非线性关系但又想用线性模型时
类别特征编码
1. 独热编码(One-Hot Encoding):将类别型变量转换为二进制列,每个类别对应一个二进制特征。
- 示例:
原始数据:颜色 = [红, 蓝, 绿, 红]
独热编码:
  颜色_红  颜色_蓝  颜色_绿
    1       0       0
    0       1       0
    0       0       1
    1       0       0
- 适用场景:无序类别特征(如颜色、城市),类别数量较少(< 10个)。
2. 标签编码(Label Encoding):将类别型变量映射为整数(0, 1, 2, ...)。
- 示例:
原始数据:等级 = [低, 中, 高, 中]
标签编码:等级 = [0, 1, 2, 1]
- 适用场景:有序类别特征(如等级:低、中、高),树模型可以直接处理类别特征。
3. 目标编码(Target Encoding / Mean Encoding):将类别变量的每个类别替换为其对应目标变量的平均值或其他统计量。
- 示例:
原始数据:
  城市    销售额
  北京     100
  上海     150
  北京     120
  上海     180

目标编码(使用平均值):
  城市_编码
   110      (北京平均销售额 = (100+120)/2)
   165      (上海平均销售额 = (150+180)/2)
   110
   165
- 适用场景:高基数类别特征(类别数量很多),类别与目标变量有明显关系,需要减少特征维度。
4. 频率编码(Frequency Encoding):将类别变量的每个类别替换为该类别在数据集中的出现频率。
- 适用场景:高基数类别特征,类别频率与目标变量相关,需要减少特征维度。
特征构造
特征构造(Feature Construction)是基于现有的特征创造出新的、更有代表性的特征。通过组合、转换、或者聚合现有的特征,形成能够更好反映数据规律的特征。特征构造是特征工程中最需要创造力和领域知识的部分。
交互特征(Interaction Features)
将两个或多个特征组合起来,形成新的特征。交互特征可以捕获特征之间的非线性关系。
常用方法:
- 乘积特征:$ X_1 \times X_2 $(如年龄 × 收入)
- 和特征:$ X_1 + X_2 $(如身高 + 体重)
- 差特征:$ X_1 - X_2 $(如收入 - 支出)
- 商特征:$ X_1 / X_2 $(如收入 / 年龄,表示收入增长率)
- 多项式特征:$ X_1^2, X_1 \times X_2, X_2^2 $ 等
示例:
# 原始特征
年龄 = 30
收入 = 50000

# 构造的交互特征
年龄_收入 = 30 × 50000 = 1500000
收入_年龄比 = 50000 / 30 = 1666.67
适用场景:
- 线性模型需要捕获非线性关系
- 领域知识表明特征间存在交互作用
- 特征之间存在乘法或除法关系
注意:可能产生大量新特征(维度爆炸);需要领域知识指导,避免构造无意义的特征;对于树模型,通常不需要显式构造交互特征(树模型可以自动学习)。
统计特征(Statistical Features)
从原始特征中提取统计值,捕获数据的分布特征和趋势。
常用统计量:
- 集中趋势:均值、中位数、众数
- 离散程度:标准差、方差、极差、四分位距
- 分布形状:偏度、峰度
- 分位数:25%分位数、75%分位数、90%分位数等
示例:
- 时间序列统计特征:在时间序列数据中,可以从原始数据中提取数据如下:
- 滑动窗口统计:过去N天的平均值、最大值、最小值、标准差
- 趋势特征:增长率、变化率、加速度
- 周期性特征:周期性平均值、周期性最大值
- 分组统计特征:
- 按类别分组后计算统计量(如每个城市的平均收入)
- 按时间窗口分组(如每月的平均销售额)
- 按多个维度分组(如每个城市每个月的平均销售额)
日期和时间特征
从日期时间数据中提取如星期几、月份、年份、季度等特征。
例如,将“2000-01-01“转换为“星期几“、“是否节假日“、“月初或月末“等特征。
特征降维*
特征降维(Feature Dimensionality Reduction)是当数据集的特征数量非常大时,通过数学变换将高维特征映射到低维空间,在保持数据本质信息的情况下减少特征的数量。特征降维可以帮助减少计算复杂度、避免过拟合、提高模型泛化能力,并有助于数据可视化。
线性降维
主成分分析 PCA
主成分分析(PCA, Principal Component Analysis):通过线性变换将原始特征映射到一个新的空间,使得新的特征(主成分)尽可能地保留数据的方差。PCA 是无监督的线性降维方法。
原理:先找到数据方差最大的方向作为第一主成分,再找与第一主成分正交且方差最大的方向作为第二主成分,依此类推,得到所有主成分。
特点:
- 主成分之间相互正交(不相关)
- 主成分按方差大小排序
- 可以通过保留前k个主成分来降维
适用场景:特征数量很多,需要减少维度,特征之间存在线性相关性等。
使用 sklearn.decomposition.PCA 进行主成分分析。参数 n_components 若为小数则表示保留多少比例的信息,为整数则表示保留多少个维度。
import numpy as np
import matplotlib.pyplot as plt
from sklearn.decomposition import PCA
from sklearn.preprocessing import StandardScaler

n_samples = 1000
# 第1个主成分方向
component1 = np.random.normal(0, 1, n_samples)
# 第2个主成分方向
component2 = np.random.normal(0, 0.2, n_samples)
# 第3个方向(噪声,方差较小)
noise = np.random.normal(0, 0.1, n_samples)

# 构造3维数据
X = np.vstack([component1 - component2, component1 + component2, component2 + noise]).T

# 标准化
scaler = StandardScaler()
X_standardized = scaler.fit_transform(X)

# 应用PCA,将3维数据降维到2维
pca = PCA(n_components=2)
X_pca = pca.fit_transform(X_standardized)

# 可视化
# 转换前的3维数据可视化
fig = plt.figure(figsize=(12, 4))
ax1 = fig.add_subplot(121, projection="3d")
ax1.scatter(X[:, 0], X[:, 1], X[:, 2], c="g")
ax1.set_title("Before PCA (3D)")
ax1.set_xlabel("Feature 1")
ax1.set_ylabel("Feature 2")
ax1.set_zlabel("Feature 3")

# 转换后的2维数据可视化
ax2 = fig.add_subplot(122)
ax2.scatter(X_pca[:, 0], X_pca[:, 1], c="b")
ax2.set_title("After PCA (2D)")
ax2.set_xlabel("Principal Component 1")
ax2.set_ylabel("Principal Component 2")
plt.show()
非线性降维
t-SNE
t-SNE(t-Distributed Stochastic Neighbor Embedding,t分布随机近邻嵌入)一种非线性的降维技术,特别适合可视化高维数据。t-SNE 通过保持数据点之间的局部相似性来降维。(t-SNE 可视化:tSNE for the Web)
原理:在高维空间中,相似的点应该靠得近;在低维空间中,保持这种相似性关系;使用t分布来建模低维空间中的相似性。
特点:
- 能够捕获非线性结构
- 适合数据可视化(通常降至2-3维)
适用场景:高维数据的可视化,探索数据的内在结构,数据聚类分析等。
UMAP
UMAP(Uniform Manifold Approximation and Projection)是一种较新的非线性降维方法,结合了流形学习和拓扑数据分析的思想。
特点:
- 比 t-SNE 更快
- 能够更好地保持全局结构
- 可以降至任意维度
基于神经网络降维
自编码器 Auto Encoder
自编码器(Auto Encoder)一种神经网络模型,通过压缩编码器来实现数据的降维。自编码器由编码器和解码器两部分组成,编码器将输入压缩到低维表示,解码器尝试从低维表示重构原始输入。
原理:
- 编码器:$ h = f(X) $,将输入X映射到低维表示h
- 解码器:$ \hat{X} = g(h) $,从低维表示重构输入
- 训练目标:最小化重构误差 $ ||X - \hat{X}||^2 $
特点:
- 能够学习非线性降维
- 可以处理复杂的数据结构
适用场景:复杂非线性数据的降维,特征提取和表示学习,深度学习中的特征工程等。
模型评估和选择
损失函数
对于模型一次预测结果的好坏,需要有一个度量标准。
对于监督学习而言,给定一个输入$ X $,选取的模型就相当于一个"决策函数"$ f $,它可以输出一个预测结果$ f(X) $,而真实的结果(标签)记为$ Y $。$ f(X) $ 和$ Y $之间可能会有偏差,我们就用一个损失函数(loss function)来度量预测偏差的程度,记作 $ L(Y,f(X)) $。
损失函数的特点:
- 损失函数用来衡量模型预测误差的大小;损失函数值越小,模型就越好
- 损失函数是$ f(X) $和$ Y $的非负实值函数
常见的损失函数:
- 0-1损失函数(0-1 Loss Function):当预测值与真实值不相等时,损失为1;相等时,损失为0。
$ L(Y, f(X)) = \begin{cases}
1, & Y \neq f(X) \
0, & Y = f(X)
\end{cases} $
- 平方损失函数(Squared Loss Function):计算预测值与真实值差的平方,对大误差惩罚更重。
$ L(Y, f(X)) = (Y - f(X))^2 $
- 绝对损失函数(Absolute Loss Function):计算预测值与真实值差的绝对值,对异常值不敏感。
$ L(Y, f(X)) = |Y - f(X)| $
- 对数似然损失函数(Log-Likelihood Loss Function):负对数似然,常用于分类问题,其中$ P(Y|X) $是给定输入$ X $时标签$ Y $的条件概率。
$ L(Y, P(Y|X)) = -\log P(Y|X) $
经验误差
给定一个训练数据集,数据个数为$ n $:
$ T = {(x_1, y_1), (x_2, y_2), \ldots, (x_n, y_n)} $
其中,$ (x_i, y_i) $表示第$ i $个样本,$ x_i $为输入特征向量,$ y_i $为对应的真实标签。
根据选取的损失函数,就可以计算出模型$ f(X) $在训练集上的平均误差,称为训练误差,也被称作 经验误差(empirical error) 或 经验风险(empirical risk)。
$ R_{emp}(f) = \frac{1}{n}\sum_{i=1}^{n}L(y_i, f(x_i)) $
类似地,在测试数据集上平均误差,被称为测试误差或者 泛化误差(generalization error)。
$ R_{gen}(f) = E[L(Y, f(X))] $
一般情况下对模型评估的策略,就是考察经验误差;当经验风险最小时,就认为取到了最优的模型。这种策略被称为 经验风险最小化(empirical risk minimization,ERM)。
欠拟合与过拟合
基本概念
拟合(Fitting):指机器学习模型在训练数据上学习到规律并生成预测结果的过程。理想情况下,模型能够准确地捕捉训练数据的模式,并且在未见过的新数据(测试数据)上也有良好的表现;即模型具有良好的 泛化能力。
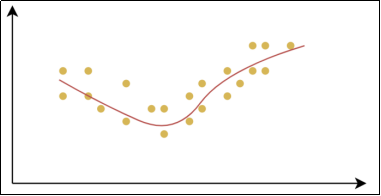
欠拟合(Underfitting):指模型在训练数据上表现不佳,无法很好地捕捉数据中的规律。这样的模型不仅在训练集上表现不好,在测试集上也同样表现差。
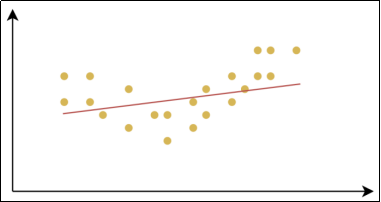
过拟合(Overfitting):指模型在训练数据上表现得很好,但在测试数据或新数据上表现较差的情况。过拟合的模型对训练数据中的噪声或细节过度敏感,把训练样本自身的一些特点当作了所有潜在样本都会具有的一般性质,从而失去了泛化能力。
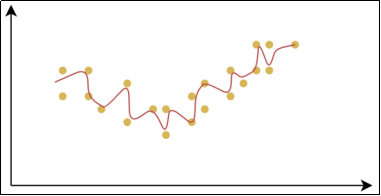
产生欠拟合和过拟合的根本原因,是模型的复杂度过低或过高,从而导致测试误差(泛化误差)偏大。
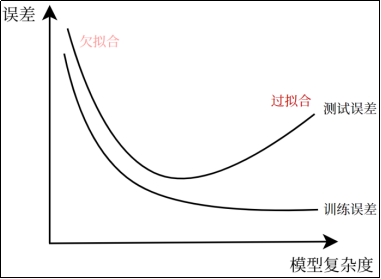
- 欠拟合:模型在训练集和测试集上误差都比较大。模型过于简单,高偏差。
- 过拟合:模型在训练集上误差较小,但在测试集上误差较大。模型过于复杂,高方差。
产生原因与解决办法
欠拟合
产生原因:
- 模型复杂度不足:模型过于简单,无法捕捉数据中的复杂关系。
- 特征不足:输入特征不充分,或者特征选择不恰当,导致模型无法充分学习数据的模式。
- 训练不充分:训练过程中迭代次数太少,模型没有足够的时间学习数据的规律。
- 过强的正则化:正则化项设置过大,强制模型过于简单,导致模型无法充分拟合数据。
解决办法:
- 增加模型复杂度:选择更复杂的模型。
- 增加特征或改进特征工程:添加更多的特征或通过特征工程来创造更有信息量的特征。
- 增加训练时间:增加训练的迭代次数,让模型有更多机会去学习。
- 减少正则化强度:如果使用了正则化,尝试减小正则化的权重,以让模型更灵活。
过拟合
产生原因:
- 模型复杂度过高:模型过于复杂,参数太多。
- 特征过多:特征太多,模型可能会"记住"数据中的噪声,而不是学到真正的规律。
- 训练过长:训练时间过长,导致模型学习到训练数据中的噪声,而非数据的真正规律。
解决办法:
- 减少模型复杂度:降低模型的参数数量、使用简化的模型或降维来减小模型复杂度。
- 增加训练数据:收集更多数据,或通过数据增强来增加训练数据的多样性。
- 使用正则化:引入L1、L2正则化,避免过度拟合训练数据。
- 交叉验证:使用交叉验证技术评估模型在不同数据集上的表现,以减少过拟合的风险。
- 早停:训练时,当模型的验证损失不再下降时,提前停止训练,避免过度拟合训练集。
代码演示
使用多项式在$ x \in [-3, 3] $上拟合$ \sin(x) $,展示欠拟合、恰好拟合和过拟合的情况:
import numpy as np
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression # 线性回归模型
from sklearn.model_selection import train_test_split # 划分训练集和测试集
from sklearn.preprocessing import PolynomialFeatures # 构建多项式特征
from sklearn.metrics import mean_squared_error # 均方损失函数

'''
1. 生成数据
2. 划分训练集和测试集
3. 定义模型(线性回归
4. 训练模型
5. 预测结果,计算误差
'''

# 1. 生成数据
x = np.linspace(-3, 3, 300).reshape(-1, 1)
y = np.sin(x) + np.random.uniform(-0.5, 0.5, 300).reshape(-1, 1)

fig, ax= plt.subplots(1,3, figsize=(15,4))
ax[0].scatter(x, y, c='y')
ax[1].scatter(x, y, c='y')
ax[2].scatter(x, y, c='y')

plt.rcParams['font.sans-serif'] = ['Kaiti']
plt.rcParams['axes.unicode_minus'] = False

# 2. 划分训练集和测试集
trainX, testX, trainY, testY = train_test_split(x, y, test_size=0.2, random_state=42)
# print(trainX)
# print(testY)


# 3. 定义模型(线性回归
model = LinearRegression()
# print(model.copy_X)

# 一、欠拟合
# 4. 训练模型
x_train1 = trainX
x_test1 = testX

model.fit(x_train1,trainY) # 先用训练集的x,y让模型拟合

# 5. 预测结果,计算误差
y_predict1 = model.predict(x_test1) # 再用测试集的x让模型预测结果y'
test_loss1 = mean_squared_error(testY, y_predict1) # 然后使用预测结果y'和测试集真实结果的y计算测试误差
# print("测试误差为:", test_loss1)
train_loss1 = mean_squared_error(trainY, model.predict(x_train1)) # 计算训练误差

# 画出拟合曲线
ax[0].set_title("欠拟合")
ax[0].plot(x, model.predict(x), color="b")
ax[0].text(-3, 1, "测试误差为:%.4f" % test_loss1, ha="center", va="center", fontsize=12, color="r")
ax[0].text(-3, 1.3, "训练误差为:%.4f" % train_loss1, ha="center", va="center", fontsize=12, color="r")
# plt.show()


# 二、恰好拟合
# 特征工程:数据转换
poly5 = PolynomialFeatures(degree=5)  # degree=5 → 生成最高5次的多项式特征

# 用多项式特征转换训练集和测试集
x_train2 = poly5.fit_transform(trainX)  # 对训练集:先“拟合”(学习特征组合规则)再“转换”(生成多项式特征)
x_test2 = poly5.transform(testX)        # 对测试集:只“转换”(用训练集学到的规则生成特征,避免数据泄漏)

# 4. 训练模型
model.fit(x_train2, trainY)

# 5. 预测结果,计算误差
y_predict2 = model.predict(x_test2)
test_loss2 = mean_squared_error(testY, y_predict2)
train_loss2 = mean_squared_error(trainY, model.predict(x_train2))

ax[1].set_title("恰好拟合")
ax[1].plot(x, model.predict(poly5.fit_transform(x)), color="b")
ax[1].text(-3, 1, "测试误差为:%.4f" % test_loss2, ha="center", va="center", fontsize=12, color="r")
ax[1].text(-3, 1.3, "训练误差为:%.4f" % train_loss2, ha="center", va="center", fontsize=12, color="r")


# 三、过拟合
poly30 = PolynomialFeatures(degree=30)
x_train3 = poly30.fit_transform(trainX)
x_test3 = poly30.transform(testX)

model.fit(x_train3, trainY)

y_predict3 = model.predict(x_test3)
test_loss3 = mean_squared_error(testY, y_predict3)
train_loss3 = mean_squared_error(trainY, model.predict(x_train3))

ax[2].set_title("过拟合")
ax[2].plot(x, model.predict(poly30.fit_transform(x)), color="b")
ax[2].text(-3, 1, "测试误差为:%.4f" % test_loss3, ha="center", va="center", fontsize=12, color="r")
ax[2].text(-3, 1.3, "训练误差为:%.4f" % train_loss3, ha="center", va="center", fontsize=12, color="r")


plt.show()
结果分析:
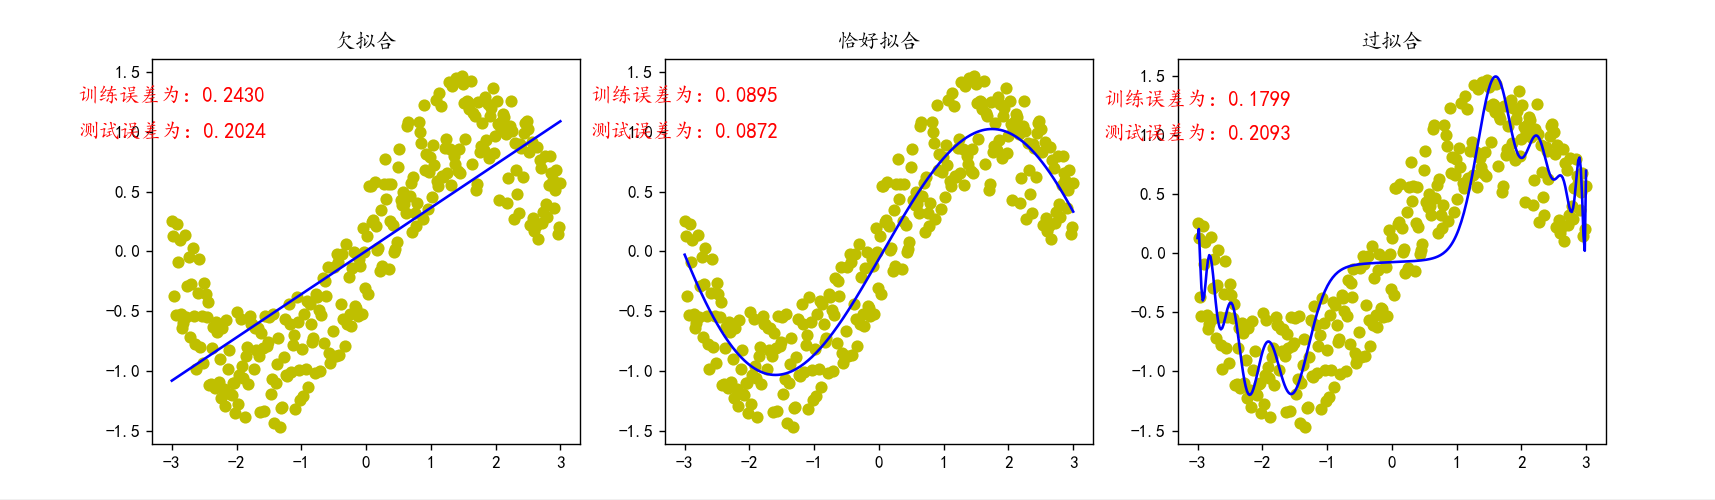
- 当多项式次数较低时,模型过于简单,拟合效果较差(欠拟合)
- 当多项式次数增加后,模型复杂度适中,拟合效果较好,训练误差和测试误差均较低(恰好拟合)
- 当多项式次数继续增加,模型变得过于复杂,过度学习了噪声,导致训练误差较低而测试误差较高(过拟合)
正则化
基本概念
正则化(Regularization)是一种在训练机器学习模型时,在损失函数中添加额外项,来惩罚过大的参数,进而限制模型复杂度、避免过拟合,提高模型泛化能力的技术。
如在平方损失函数中加入正则化项$ \lambda\sum_{i=1}^{k} \omega_i^2
$:
$ Loss = \frac{1}{n}\left(\sum_{i=1}^{n}(f(x_i) - y_i)^2 + \lambda \sum_{i=1}^{k} \omega_i^2\right) $
其中:
- 原损失函数 $ \sum_{i=1}^{n}(f(x_i) - y_i)^2 $ 的目的:更好的拟合数据集
- 正则化项 $ \lambda \sum_{i=1}^{k} \omega_i^2 $ 的目的:减小参数的大小,从而降低模型的复杂度
这里的 $ \lambda $ 是 正则化系数,用来表示惩罚项的权重。正则化系数不属于模型的参数,无法通过训练学习得到,需要在模型训练开始之前手动设置,这种参数被称为“超参数”。
两者相互平衡,在模型的拟合能力(偏差)和复杂度之间找到最佳折中。
L1正则化(Lasso回归)
L1正则化在损失函数中加入参数的绝对值之和:
$ Loss_{L1} = 原Loss + \lambda \sum_{i=1}^{k} |\omega_i| $
其中:
- $ 原Loss $:原始损失函数(如均方误差)
- $ \lambda $:正则化系数
- $ \sum_{i=1}^{k} |\omega_i| $:所有参数绝对值的和
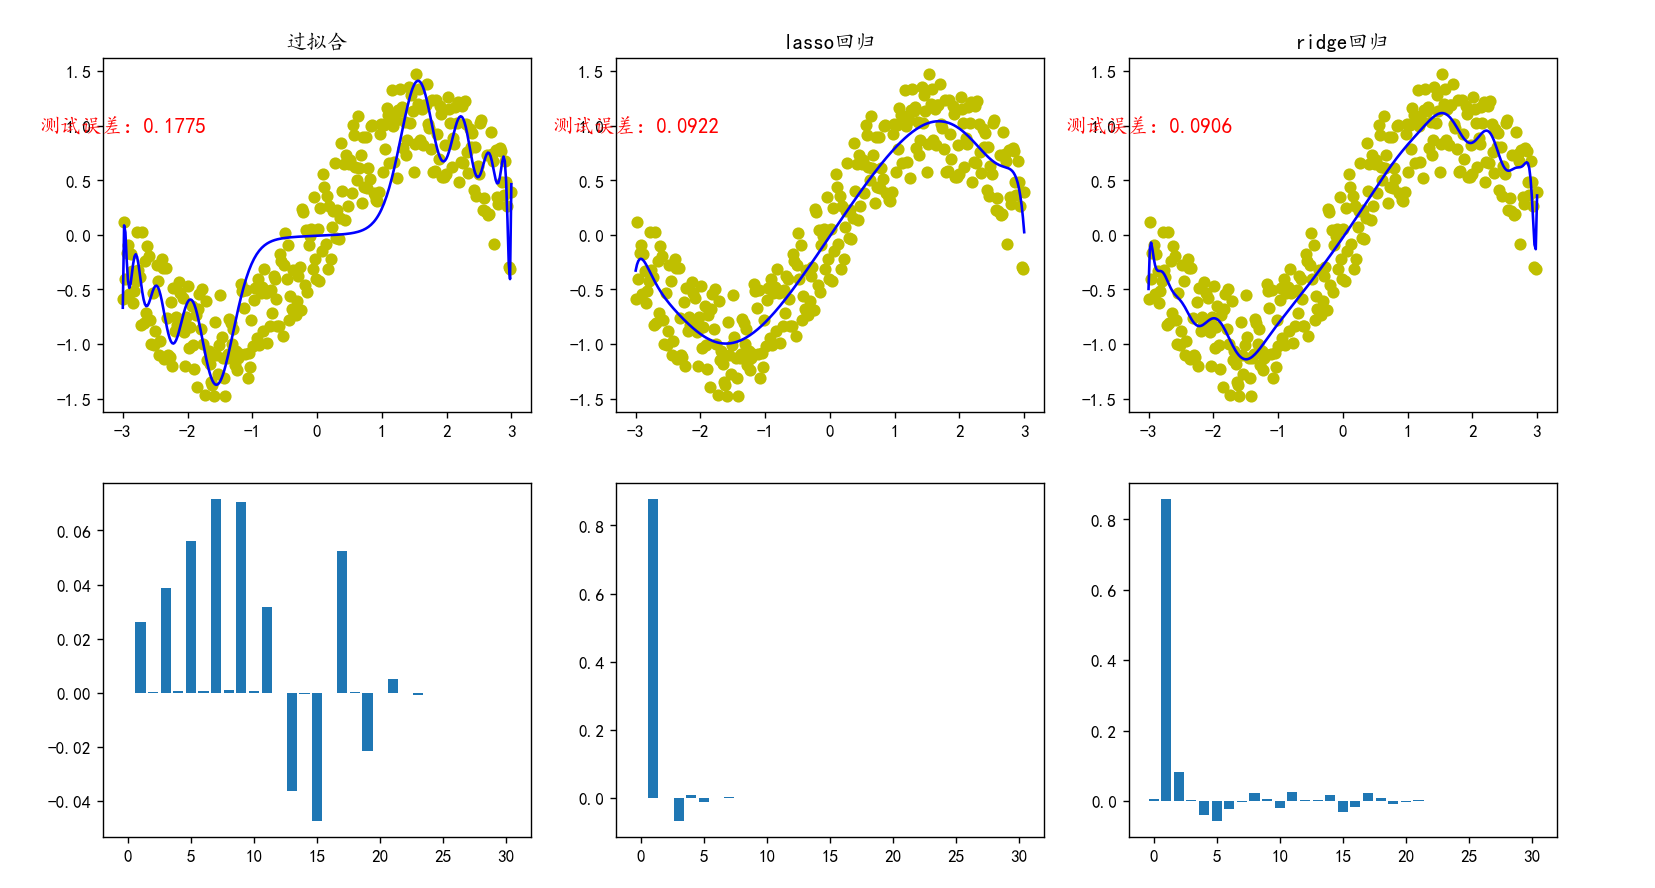
L1正则化通过惩罚模型参数的绝对值,使得部分权重趋近0甚至变为0。这会导致特征选择,即模型会自动"丢弃"一些不重要的特征。L1正则化有助于创建稀疏模型(即许多参数为0)。在解决回归问题时,使用L1正则化也被称为"Lasso回归"。
超参数控制:超参数 $ \lambda $ 控制着正则化的强度。较大的 $ \lambda $ 值意味着强烈的正则化,会使模型更简单,可能导致欠拟合。而较小的 $ \lambda $ 值则会使模型更复杂,可能导致过拟合。
梯度下降法求解的推导过程:
对于L1正则化的均方误差损失函数:
$ Loss_{L1} = \frac{1}{n}\left(\sum_{i=1}^{n}(f(x_i) - y_i)^2 + \lambda \sum_{j=1}^{k} |\omega_j|\right) $
对参数$ \omega_j $的偏导数:
$ \frac{\partial Loss_{L1}}{\partial \omega_j} = \frac{1}{n}\left(2\sum_{i=1}^{n}x_{ij}(f(x_i) - y_i) + \lambda \cdot \text{sign}(\omega_j)\right) $
其中,$ \text{sign}(\omega_j) $为符号函数,定义为:
$ \text{sign}(\omega_j) = \begin{cases}
1, & \omega_j > 0 \
0, & \omega_j = 0 \
-1, & \omega_j < 0
\end{cases} $
参数更新规则:
$ \omega_j \leftarrow \omega_j - \alpha \left(\frac{2}{n}\sum_{i=1}^{n}x_{ij}(f(x_i) - y_i) + \frac{\lambda}{n} \cdot \text{sign}(\omega_j)\right) $
其中,$ \alpha $为学习率。
稀疏性说明:
可见L1正则化项的梯度是一个常数$ \frac{\lambda}{n} $(或$ -\frac{\lambda}{n} $),当$ \omega_j $很小时会直接变成0,导致稀疏性。这是因为L1正则化项的梯度不依赖于参数的大小,只要参数不为0,就会受到恒定的惩罚,从而容易将小参数压缩为0。
L2正则化(Ridge回归,岭回归)
L2正则化在损失函数中加入参数的平方之和:
$ Loss_{L2} = 原Loss + \lambda \sum_{i=1}^{k} \omega_i^2 $
其中:
- $ 原Loss $:原始损失函数(如均方误差)
- $ \lambda $:正则化系数
- $ \sum_{i=1}^{k} \omega_i^2 $:所有参数平方的和
L2正则化通过惩罚模型参数的平方,使得所有参数都变得更小,但不会将参数强行压缩为0。它会使得模型尽量平滑,从而防止过拟合。在解决回归问题时,使用L2正则化也被称为“岭回归”。
ElasticNet 正则化(弹性网络回归)
ElasticNet正则化结合了L1和L2正则化,通过调整两个正则化项的比例来取得平衡,从而同时具备稀疏性和稳定性的优点。
$ Loss_{ElasticNet} = 原Loss + \lambda \left(\alpha \sum_{i=1}^{k} |\omega_i| + \frac{1-\alpha}{2} \sum_{i=1}^{k} \omega_i^2\right) $
其中:
- $ 原Loss $:原始损失函数(如均方误差)
- $ \lambda $:正则化系数,控制正则化的整体强度
- $ \alpha \in [0,1] $:混合参数,决定L1和L2的权重
- 当$ \alpha = 1 $时,退化为L1正则化
- 当$ \alpha = 0 $时,退化为L2正则化
- 当$ 0 < \alpha < 1 $时,同时包含L1和L2正则化项
正则化案例
同样以使用多项式在数据上拟合为例,分别不使用正则化、使用L1正则化、使用L2正则化进行拟合:
import numpy as np
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression,Lasso,Ridge # 线性回归模型
from sklearn.model_selection import train_test_split # 划分训练集和测试集
from sklearn.preprocessing import PolynomialFeatures # 构建多项式特征
from sklearn.metrics import mean_squared_error # 均方损失函数

x = np.linspace(-3, 3, 300).reshape(-1, 1)  # 生成x轴数据点
y = np.sin(x) + np.random.uniform(-0.5, 0.5, 300).reshape(-1, 1)  # 生成带有噪声的sin函数数据

fig, ax= plt.subplots(2,3, figsize=(15,8))  # 创建2行3列的子图
ax[0,0].scatter(x, y, c='y')  # 第一个子图绘制散点图
ax[0,1].scatter(x, y, c='y')  # 第二个子图绘制散点图
ax[0,2].scatter(x, y, c='y')  # 第三个子图绘制散点图

# plt.rcParams['font.sans-serif'] = ['Kaiti']  # 设置中文字体
plt.rcParams['axes.unicode_minus'] = False  # 解决负号显示问题

trainX, testX, trainY, testY = train_test_split(x, y, test_size=0.2, random_state=42)  # 划分训练集和测试集
poly30 = PolynomialFeatures(degree=30)  # 创建30次多项式特征转换器
x_train = poly30.fit_transform(trainX)  # 将训练集转换为30次多项式特征
x_test = poly30.transform(testX)  # 将测试集转换为30次多项式特征

# 过拟合情况下的正则化
# 1. 初始情况
model = LinearRegression()  # 创建线性回归模型
model.fit(x_train, trainY)  # 训练模型

y_predict = model.predict(x_test)  # 使用模型进行预测
test_loss = mean_squared_error(testY, y_predict)  # 计算测试误差

ax[0,0].set_title("过拟合")  # 设置第一个子图标题
ax[0,0].plot(x, model.predict(poly30.fit_transform(x)), color="b")  # 绘制预测曲线
ax[0,0].text(-3, 1, "测试误差:%.4f" % test_loss, ha="center", va="center", fontsize=12, color="r")  # 添加测试误差文本
ax[1,0].bar(np.arange(31), model.coef_.reshape(-1))  # 绘制系数条形图

# 2. L1正则化(Lasso回归)
lasso = Lasso(alpha=0.01)  # 创建Lasso回归模型,正则化强度为0.01
lasso.fit(x_train, trainY)  # 训练Lasso模型

y_predict2 = lasso.predict(x_test)  # Lasso模型预测
test_loss2 = mean_squared_error(testY, y_predict2)  # 计算Lasso预测误差

ax[0,1].set_title("lasso回归")  # 设置第二个子图标题
ax[0,1].plot(x, lasso.predict(poly30.fit_transform(x)), color="b")  # 绘制Lasso预测曲线
ax[0,1].text(-3, 1, "测试误差:%.4f" % test_loss2, ha="center", va="center", fontsize=12, color="r")  # 添加Lasso误差文本
ax[1,1].bar(np.arange(31), lasso.coef_.reshape(-1))  # 绘制Lasso系数条形图

# 3. L2正则化(岭回归)
ridge = Ridge(alpha=1)  # 创建Ridge回归模型,正则化强度为1
ridge.fit(x_train, trainY)  # 训练Ridge模型

y_predict3 = ridge.predict(x_test)  # Ridge模型预测
test_loss3 = mean_squared_error(testY, y_predict3)  # 计算Ridge预测误差

ax[0,2].set_title("ridge回归")  # 设置第三个子图标题
ax[0,2].plot(x, ridge.predict(poly30.fit_transform(x)), color="b")  # 绘制Ridge预测曲线
ax[0,2].text(-3, 1, "测试误差:%.4f" % test_loss3, ha="center", va="center", fontsize=12, color="r")  # 添加Ridge误差文本
ax[1,2].bar(np.arange(31), ridge.coef_.reshape(-1))  # 绘制Ridge系数条形图
plt.show()  # 显示图形
运行结果
交叉验证
交叉验证(Cross-Validation)是一种评估模型泛化能力的方法,通过将数据集划分为多个子集,反复进行训练和验证,以减少因单次数据划分带来的随机性误差。通过交叉验证能更可靠地估计模型在未知数据上的表现,亦能避免因单次数据划分不合理导致的模型过拟合或欠拟合。
简单交叉验证(Hold-Out Validation)
将数据划分为训练集和验证集(如70%训练,30%验证)。结果受单次划分影响较大,可能高估或低估模型性能。
k 折交叉验证(k-Fold Cross-Validation)
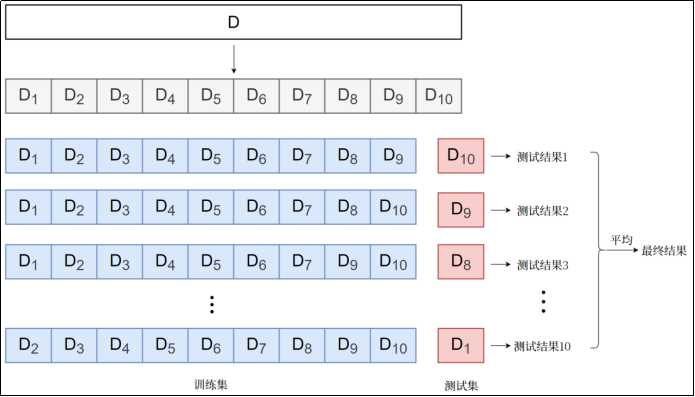
将数据均匀分为$ k $个子集(称为"折"),每次用$ k-1 $折训练,剩余$ 1 $折验证,重复$ k $次后取平均性能。充分利用数据,结果更稳定。
留一交叉验证(Leave-One-Out,LOO)
每次仅留一个样本作为验证集,其余全部用于训练,重复直到所有样本都被验证一次。适用于小数据集,计算成本极高。
模型求解算法
正则化可以有效防止过拟合,增强模型的泛化能力。这时模型的评估策略,就是让结构化的经验风险最小,即增加了正则化项的损失函数最小,称为 结构风险最小化(Structural Risk Minimization,SRM)。
这其实就是求解一个 最优化问题。代入训练集所有数据,要求最小值的目标函数就是模型中参数的函数。
具体求解的算法,可以利用数学公式直接计算解析解,也可以使用迭代算法。
解析法
如果模型损失函数的最小值可以通过数学公式进行严格推导,得到一个解析解,那么就直接得到了最优模型的全部参数。这种方法称作解析法。
特点:
- 适用条件:目标函数必须可导,且导数方程有解析解
- 优点:直接且精确;计算高效
- 缺点:适用条件较为苛刻;特征维度较大时,矩阵求逆计算复杂度极高
应用示例:
- 线性回归问题:可以采用"最小二乘法"求得解析解
损失函数(均方误差):
$ Loss_{MSE} = \frac{1}{n}(X\beta - y)^T(X\beta - y) $
其中:
- $ X $:特征矩阵($ n \times m $,$ n $为样本数,$ m $为特征数)
- $ \beta $:回归系数向量
- $ y $:真实标签向量
损失函数的梯度:
$ \nabla Loss_{MSE} = \frac{2}{n}X^T(X\beta - y) = 0 $
解析解(正规方程):
$ \beta = (X^T X)^{-1} X^T y $
- 线性回归L2正则化(Ridge回归,岭回归)可以得到解析解
损失函数(L2正则化的均方误差):
$ Loss_{L2} = \frac{1}{n}(X\beta - y)^T(X\beta - y) + \frac{1}{n}\lambda \beta^T \beta $
其中:
- $ \lambda $:正则化系数
- $ \beta^T \beta $:参数向量的L2范数的平方
损失函数的梯度:
$ \nabla Loss_{L2} = \frac{2}{n}X^T(X\beta - y) + \frac{2}{n}\lambda \beta = 0 $
解析解:
$ \beta = (X^T X + \lambda I)^{-1} X^T y $
其中,$ I $为单位矩阵。由于加入的对角矩阵$ \lambda I $就像一条"山岭",因此L2正则化也称作"岭回归"。
梯度下降法(重点)
梯度下降法(gradient descent)是一种常用的一阶优化方法,是求解无约束优化问题最简单、最经典的方法之一。梯度下降法是迭代算法,基本思路就是先选取一个适当的初始值,然后沿着梯度方向或者负梯度方向,不停地更新参数,最终取到极小值。
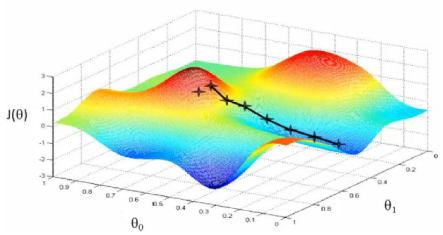
- 梯度方向:函数变化增长最快的方向(变量沿此方向变化时函数增长最快)
- 负梯度方向:函数变化减少最快的方向(变量沿此方向变化时函数减少最快)
因为损失函数是系数的函数,那么如果系数沿着损失函数的负梯度方向变化,此时损失函数减少最快,能够以最快速度下降到极小值。
更新公式:
$ \theta_{t+1} = \theta_t - \alpha \nabla J(\theta_t) $
其中,$ \nabla J(\theta) $ 是参数取值为$ \theta $时损失函数 $ J $ 的梯度;$ \alpha $ 是每次迭代的"步长",被称为"学习率"。学习率也是一个常见的超参数,需要手动设置,选择不当会导致收敛失败。
特点:
- 梯度下降不一定能够找到全局的最优解,有可能是一个局部最优解
- 优点:适用性广;计算简单
- 缺点:收敛速度慢;可能陷入局部最优
分类:
- 批量梯度下降(Batch Gradient Descent,BGD):每次迭代使用全部训练数据计算梯度。
- 优点:稳定收敛。
- 缺点:计算开销大。
- 随机梯度下降(Stochastic Gradient Descent,SGD):每次迭代随机选取一个样本计算梯度。
- 优点:速度快,适合大规模数据。
- 缺点:梯度更新方向不稳定,优化过程震荡较大,可能难以收敛。
- 小批量梯度下降(Mini-batch Gradient Descent,MBGD):每次迭代使用一小批样本(如32、64个)计算梯度。平衡了BGD的稳定性和SGD的速度,是最常用的方法。
梯度下降法计算步骤:
- 初始化参数:随机选择初始参数
- 计算梯度:在当前参数下,计算损失函数的梯度
- 更新参数:沿负梯度方向调整参数
- 重复迭代:直到满足停止条件(如梯度接近零、达到最大迭代次数等)
代码实现
我们以一个单变量函数为例,介绍梯度下降法的代码实现。
问题设定:
设$ f(x) = x^2 $,求$ x $为何值时,$ f(x) = 2 $。
目标函数:
目标函数$ J(x) = (f(x) - 2)^2 = (x^2-2)^2 $,原问题等价于求$ x $为何值时目标函数取得最小值。
使用梯度下降法求解:
- 初始值:$ x = 1 $
- 学习率:$ \alpha = 0.1 $
梯度计算:
$ \frac{dJ(x)}{dx} = 4x^3 - 8x $
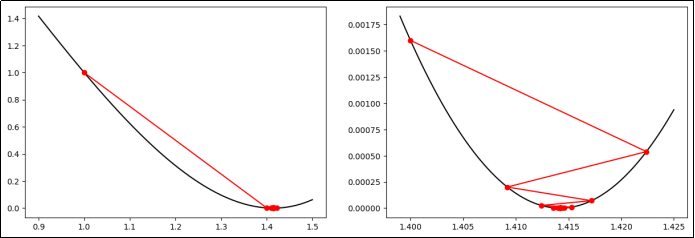
迭代过程示例:
- 第1步:
- $ x_1 = 1 $
- $ J(x_1) = 1 $
- $ J'(x_1) = -4 $
- $ x_2 = x_1 - \alpha \cdot J'(x_1) = 1 - 0.1 \times (-4) = 1.4 $
- 第2步:
- $ x_2 = 1.4 $
- $ J(x_2) = 0.0016 $
- $ J'(x_2) = -0.2240 $
- $ x_3 = x_2 - \alpha \cdot J'(x_2) = 1.4 - 0.1 \times (-0.2240) = 1.4224 $
- 迭代至收敛:
- 经过多次迭代后,$ x_n \approx 1.414213 $(接近$ \sqrt{2} $)
- 此时$ J(x_n) \approx 2.53 \times 10^{-12} $,$ J'(x_n) \approx 8.88 \times 10^{-15} \approx 0 $
示例代码:
def J(x):
    """目标函数"""
    return (x**2 - 2) ** 2

def gradient(x):
    """梯度"""
    return 4 * x**3 - 8 * x

x = 1  # x的初始值
alpha = 0.1  # 学习率
while (j := J(x)) > 1e-30:  # 当目标函数的值小于10的-30次幂时停止计算
    print(f"x={x}\tJ={j}")
    grad = gradient(x)  # 求解梯度
    x = x - alpha * grad  # 更新参数
如图所示:
应用推导
梯度下降法在正则化问题中的应用:
L1正则化(Lasso回归):L1正则化项的梯度是常数$ \frac{\lambda}{n} $,当参数很小时会直接变成0,导致稀疏性。
对于L1正则化的均方误差损失函数:
$ Loss_{L1} = \frac{1}{n}\left(\sum_{i=1}^{n}(f(x_i) - y_i)^2 + \lambda \sum_{j=1}^{k} |\omega_j|\right) $
对参数$ \omega_j $的偏导数:
$ \frac{\partial Loss_{L1}}{\partial \omega_j} = \frac{1}{n}\left(2\sum_{i=1}^{n}x_{ij}(f(x_i) - y_i) + \lambda \cdot \text{sign}(\omega_j)\right) $
其中,$ \text{sign}(\omega_j) $为符号函数,定义为:
$ \text{sign}(\omega_j) = \begin{cases}
1, & \omega_j > 0 \
0, & \omega_j = 0 \
-1, & \omega_j < 0
\end{cases} $
参数更新规则:
$ \omega_j \leftarrow \omega_j - \alpha \left(\frac{2}{n}\sum_{i=1}^{n}x_{ij}(f(x_i) - y_i) + \frac{\lambda}{n} \cdot \text{sign}(\omega_j)\right) $
其中,$ \alpha $为学习率。
稀疏性说明:
可见L1正则化项的梯度是一个常数$ \frac{\lambda}{n} $(或$ -\frac{\lambda}{n} $),当$ \omega_j $很小时会直接变成 0,导致稀疏性。这是因为L1正则化项的梯度不依赖于参数的大小,只要参数不为 0,就会受到恒定的惩罚,从而容易将小参数压缩为0。
L2正则化(Ridge回归):L2 正则化项的梯度是$ \frac{2\lambda}{n}\omega_j $,相当于在每次更新时都对参数进行缩小,但不会直接变为0。对于L2正则化的均方误差损失函数:
$ Loss_{L2} = \frac{1}{n}\left(\sum_{i=1}^{n}(f(x_i) - y_i)^2 + \lambda \sum_{j=1}^{k} \omega_j^2\right) $
对参数$ \omega_j $的偏导数:
$ \frac{\partial Loss_{L2}}{\partial \omega_j} = \frac{1}{n}\left(2\sum_{i=1}^{n}x_{ij}(f(x_i) - y_i) + 2\lambda \omega_j\right) $
参数更新规则:
$ \omega_j \leftarrow \omega_j - \alpha \left(\frac{2}{n}\sum_{i=1}^{n}x_{ij}(f(x_i) - y_i) + \frac{2\lambda}{n} \omega_j\right) $
其中,$ \alpha $为学习率。
常见问题
梯度下降法常见问题:
- 特征缩放:通常需要提前对特征进行缩放(如标准化或归一化),以加快收敛速度。
- 局部极小值、鞍点问题:可能陷入局部极小值(非全局最优解),或遇到鞍点(梯度为零但非极值点)。
解决方案:使用动量(Momentum)、自适应优化器(如Adam)或二阶方法(如牛顿法)。
牛顿法和拟牛顿法(了解)
牛顿法也是求解无约束最优化问题的常用方法,核心思想是利用目标函数的二阶导数信息,通过迭代逐渐逼近极值点。
更新公式:
$ \theta_{k+1} = \theta_k - H^{-1}(\theta_k) \cdot \nabla L(\theta_k) $
其中,$ H^{-1}(\theta_k) $表示损失函数$ L $的黑塞矩阵(Hessian Matrix)的逆在点$ \theta_k $的取值。
说明:
- $ \theta_k $:第$ k $次迭代的参数向量
- $ \theta_{k+1} $:第$ k+1 $次迭代的参数向量
- $ \nabla L(\theta_k) $:损失函数$ L $在$ \theta_k $处的梯度向量(一阶导数)
- $ H(\theta_k) $:损失函数$ L $在$ \theta_k $处的黑塞矩阵(二阶偏导数矩阵)
- $ H^{-1}(\theta_k) $:黑塞矩阵的逆矩阵
特点:
- 优点:收敛速度快;精度高(利用二阶信息)
- 缺点:计算复杂(需要计算和求逆黑塞矩阵);可能发散;对初始值敏感
由于牛顿法中需要计算黑塞矩阵的逆,这一步比较复杂;所以可以考虑用一个n阶正定矩阵来近似代替它,这种方法称为"拟牛顿法"。
牛顿法和拟牛顿法一般用于解决中小规模的凸优化问题。
模型评价指标(重点)
对学习的泛化性能进行评估,不仅需要有效可行的实验估计方法,还需要有衡量模型泛化能力的评价指标,也叫做性能度量(performance measure)。
回归模型评价指标
模型的评价指标用于衡量模型在训练集或测试集上的性能,评估结果反映了模型预测的准确性和泛化能力。
对于回归问题,最常用的性能度量是"均方误差" (Mean Squared Error,MSE)。
平均绝对误差(MAE)
平均绝对误差(MAE)公式:
$ MAE = \frac{1}{n}\sum_{i=1}^{n}|y_i - \hat{y}_i| $
MAE对异常值不敏感,解释直观。适用于数据包含异常值的场景。
均方误差(MSE)
均方误差(MSE)公式:
$ MSE = \frac{1}{n}\sum_{i=1}^{n}(y_i - \hat{y}_i)^2 $
MSE会放大较大误差,对异常值敏感。适用于需要惩罚大误差的场景。
均方根误差(RMSE)
均方根误差(RMSE)公式:
$ RMSE = \sqrt{\frac{1}{n}\sum_{i=1}^{n}(y_i - \hat{y}_i)^2} = \sqrt{MSE} $
与MSE类似,但量纲与目标变量一致。适用于需要直观误差量纲的场景。如果一味地试图降低RMSE,可能会导致模型对异常值也拟合度很高,容易过拟合。
R²(决定系数)
决定系数(R²)公式:
$ R^2 = 1 - \frac{\sum_{i=1}^{n}(y_i - \hat{y}i)^2}{\sum{i=1}^{n}(y_i - \bar{y})^2} $
衡量模型对目标变量的解释能力,越接近1越好,对异常值敏感。
分类模型评价指标
对于分类问题,最常用的指标就是"准确率"(Accuracy),它定义为分类器对测试集正确分类的样本数与总样本数之比。此外还有一系列常用的评价指标。
混淆矩阵
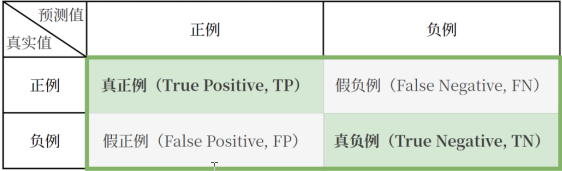
混淆矩阵(Confusion Matrix)是用于评估分类模型性能的工具,展示了模型预测结果与实际标签的对比情况。
对于二分类问题,混淆矩阵是一个2×2矩阵:
| 真实值 \ 预测值 | 预测为正例 | 预测为负例 |
|---|---|---|
| 实际为正例 | $ TP $(真正例) | $ FN $(假负例) |
| 实际为负例 | $ FP $(假正例) | $ TN $(真负例) |
例如,有10个样本。6个是猫,4个是狗。假设以猫为正例,模型预测对了5个猫,2个狗。
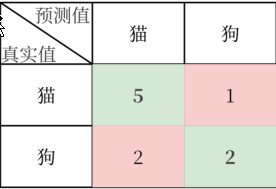
使用sklearn.metrics.confusion_matrix查看混淆矩阵:
import pandas as pd
import seaborn as sns
from sklearn.metrics import confusion_matrix

label = ["猫", "狗"]# 标签
y_true = ["猫", "猫", "猫", "猫", "猫", "猫", "狗", "狗", "狗", "狗"] # 真实值
y_pred1 = ["猫", "猫", "狗", "猫", "猫", "猫", "猫", "猫", "狗", "狗"] # 预测值
matrix1 = confusion_matrix(y_true, y_pred1, labels=label) # 混淆矩阵
print(pd.DataFrame(matrix1, columns=label, index=label))
sns.heatmap(matrix1, annot=True, fmt='d', cmap='Greens')
准确率(Accuracy)
准确率公式:
$ Accuracy = \frac{TP + TN}{TP + TN + FP + FN} $
所有样本中,正确预测的比例。
示例代码:
from sklearn.metrics import accuracy_score

label = ["猫", "狗"]  # 标签
y_true = ["猫", "猫", "猫", "猫", "猫", "猫", "狗", "狗", "狗", "狗"]  # 真实值
y_pred1 = ["猫", "猫", "狗", "猫", "猫", "猫", "猫", "猫", "狗", "狗"]  # 预测值
accuracy = accuracy_score(y_true, y_pred1)
print(accuracy)
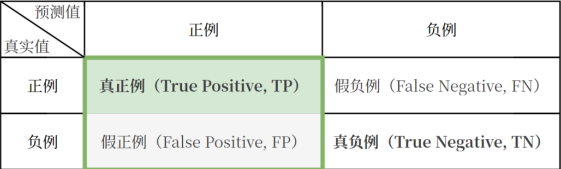
精确率(Precision)
精确率公式:
$ Precision = \frac{TP}{TP + FP} $
预测为正例的样本中实际为正例的比例,也叫查准率。
示例代码:
from sklearn.metrics import precision_score

label = ["猫", "狗"]  # 标签
y_true = ["猫", "猫", "猫", "猫", "猫", "猫", "狗", "狗", "狗", "狗"]  # 真实值
y_pred1 = ["猫", "猫", "狗", "猫", "猫", "猫", "猫", "猫", "狗", "狗"]  # 预测值
precision = precision_score(y_true, y_pred1, pos_label="猫")  # pos_label指定正例
print(precision)
# 上述案例中,精确率=5/(5+2)=0.7143。
召回率(Recall)
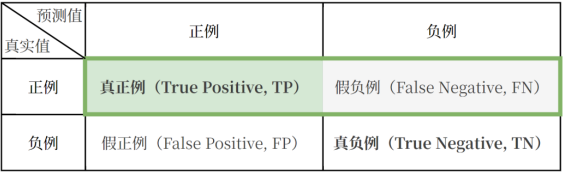
召回率公式:
$ Recall = \frac{TP}{TP + FN} $
实际为正类的样本中预测为正类的比例,也叫查全率。
示例代码:
from sklearn.metrics import recall_score

label = ["猫", "狗"]  # 标签
y_true = ["猫", "猫", "猫", "猫", "猫", "猫", "狗", "狗", "狗", "狗"]  # 真实值
y_pred1 = ["猫", "猫", "狗", "猫", "猫", "猫", "猫", "猫", "狗", "狗"]  # 预测值
recall = recall_score(y_true, y_pred1, pos_label="猫")  # pos_label指定正例
print(recall)
F1分数(F1 Score)
F1分数公式:
$ F1 = \frac{2 \times Precision \times Recall}{Precision + Recall} = \frac{2TP}{2TP + FP + FN} $
精确率和召回率的调和平均。
示例代码:
from sklearn.metrics import f1_score

label = ["猫", "狗"]  # 标签
y_true = ["猫", "猫", "猫", "猫", "猫", "猫", "狗", "狗", "狗", "狗"]  # 真实值
y_pred1 = ["猫", "猫", "狗", "猫", "猫", "猫", "猫", "猫", "狗", "狗"]  # 预测值
f1 = f1_score(y_true, y_pred1, pos_label="猫")  # pos_label指定正例
print(f1)
在混淆矩阵中:
- $ TP = 5 $(真正例)
- $ FP = 2 $(假正例)
- $ FN = 1 $(假负例)
则:
- $ Precision = \frac{TP}{TP + FP} = \frac{5}{5 + 2} = \frac{5}{7} $
- $ Recall = \frac{TP}{TP + FN} = \frac{5}{5 + 1} = \frac{5}{6} $
F1分数计算:
$ F1 = \frac{2 \times \frac{5}{7} \times \frac{5}{6}}{\frac{5}{7} + \frac{5}{6}} = \frac{2 \times \frac{25}{42}}{\frac{30 + 35}{42}} = \frac{\frac{50}{42}}{\frac{65}{42}} = \frac{50}{65} \approx 0.7692 $
说明:
- F1分数是精确率和召回率的调和平均,能够平衡这两个指标
- F1分数的取值范围为$ [0, 1] $,值越大表示模型性能越好
- 当精确率和召回率都较高时,F1分数也会较高
- F1分数特别适用于类别不平衡的数据集
分类报告
在代码中,我们可通过sklearn.metrics.classification_report生成分类任务的评估报告,包括精确率、召回率、F1分数等。
from sklearn.metrics import classification_report
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression

# 生成一个二分类数据集
X, y = make_classification(n_samples=1000, n_features=20, n_classes=2, random_state=100)

# 划分训练集和测试集
x_train, x_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=100)

# 训练一个逻辑回归模型
model = LogisticRegression()
model.fit(x_train, y_train)

# 预测
y_pred = model.predict(x_test)

# 生成分类报告
report = classification_report(y_test, y_pred)
print(report)
ROC 曲线
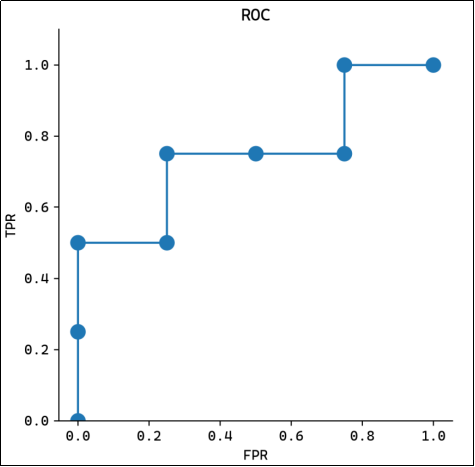
ROC 曲线(Receiver Operating Characteristic Curve,受试者工作特征)是评估二分类模型性能的工具,以假正例率($ FPR $)为横轴,以真正例率($ TPR $)为纵轴,展示不同阈值下模型的表现。绘制ROC曲线时,从高到低调整阈值,计算每个阈值的$ TPR $和$ FPR $并绘制所有阈值的点,形成 ROC 曲线。
- 真正例率(TPR):实际为正例,被预测为正例的比例,即召回率。
$ TPR = \frac{TP}{TP + FN} = Recall $
- 假正例率(FPR):实际为负例,被预测为正例的比例。
$ FPR = \frac{FP}{FP + TN} $
- 阈值(Threshold):根据阈值将概率转换为类别标签。
案例:绘制ROC曲线
假设一个二分类模型的真实标签和模型输出概率如下:
| 样本 | 真实标签 | 模型输出概率 |
|---|---|---|
| 1 | 1 | 0.9 |
| 2 | 0 | 0.4 |
| 3 | 1 | 0.6 |
| 4 | 1 | 0.8 |
| 5 | 0 | 0.2 |
| 6 | 0 | 0.7 |
| 7 | 1 | 0.3 |
| 8 | 0 | 0.5 |
按模型输出概率排序:
| 样本 | 真实标签 | 模型输出概率 |
|---|---|---|
| 1 | 1 | 0.9 |
| 4 | 1 | 0.8 |
| 6 | 0 | 0.7 |
| 3 | 1 | 0.6 |
| 8 | 0 | 0.5 |
| 2 | 0 | 0.4 |
| 7 | 1 | 0.3 |
| 5 | 0 | 0.2 |
调整阈值,计算TPR和FPR:
从数据可知:
- 实际正例总数:$ TP + FN = 4 $(样本1, 3, 4, 7)
- 实际负例总数:$ FP + TN = 4 $(样本2, 5, 6, 8)
注意:当模型输出概率大于阈值时,预测为正例;否则预测为负例。
| 阈值 | 预测为正例的样本(概率>阈值) | TP | FP | FN | TN | TPR | FPR | 点坐标 |
|---|---|---|---|---|---|---|---|---|
| 0.9 | 无(所有概率≤0.9) | 0 | 0 | 4 | 4 | $ \frac{0}{4} = 0 $ | $ \frac{0}{4} = 0 $ | (0, 0) |
| 0.8 | 样本1(0.9) | 1 | 0 | 3 | 4 | $ \frac{1}{4} = 0.25 $ | $ \frac{0}{4} = 0 $ | (0, 0.25) |
| 0.7 | 样本1(0.9)、样本4(0.8) | 2 | 0 | 2 | 4 | $ \frac{2}{4} = 0.5 $ | $ \frac{0}{4} = 0 $ | (0, 0.5) |
| 0.6 | 样本1(0.9)、样本4(0.8)、样本6(0.7) | 2 | 1 | 2 | 3 | $ \frac{2}{4} = 0.5 $ | $ \frac{1}{4} = 0.25 $ | (0.25, 0.5) |
| 0.5 | 样本1(0.9)、样本4(0.8)、样本6(0.7)、样本3(0.6) | 3 | 1 | 1 | 3 | $ \frac{3}{4} = 0.75 $ | $ \frac{1}{4} = 0.25 $ | (0.25, 0.75) |
| 0.4 | 样本1、4、6、3、样本8(0.5) | 3 | 2 | 1 | 2 | $ \frac{3}{4} = 0.75 $ | $ \frac{2}{4} = 0.5 $ | (0.5, 0.75) |
| 0.3 | 样本1、4、6、3、8、样本2(0.4) | 3 | 3 | 1 | 1 | $ \frac{3}{4} = 0.75 $ | $ \frac{3}{4} = 0.75 $ | (0.75, 0.75) |
| 0.2 | 样本1、4、6、3、8、2、样本7(0.3) | 4 | 3 | 0 | 1 | $ \frac{4}{4} = 1 $ | $ \frac{3}{4} = 0.75 $ | (0.75, 1) |
说明:
- 当阈值较高(如0.9)时,只有高概率样本被预测为正例,$ TPR $和$ FPR $都较低
- 随着阈值降低,更多样本被预测为正例,$ TPR $和$ FPR $逐渐增加
- 当阈值很低(如0.2)时,几乎所有样本都被预测为正例,$ TPR $和$ FPR $都接近1
绘制ROC曲线的代码示例:
import numpy as np
import matplotlib.pyplot as plt
from sklearn.metrics import roc_curve, auc

# 示例数据(对应上述案例)
y_true = np.array([1, 0, 1, 1, 0, 0, 1, 0])  # 真实标签
y_scores = np.array([0.9, 0.4, 0.6, 0.8, 0.2, 0.7, 0.3, 0.5])  # 模型输出概率

# 计算FPR和TPR
fpr, tpr, thresholds = roc_curve(y_true, y_scores)

# 计算AUC值
roc_auc = auc(fpr, tpr)

# 绘制ROC曲线
plt.figure(figsize=(8, 6))
plt.plot(fpr, tpr, color='darkorange', lw=2,
         label=f'ROC curve (AUC = {roc_auc:.2f})')
plt.plot([0, 1], [0, 1], color='navy', lw=2, linestyle='--',
         label='Random classifier (AUC = 0.5)')
plt.xlim([0.0, 1.0])
plt.ylim([0.0, 1.05])
plt.xlabel('False Positive Rate (FPR)')
plt.ylabel('True Positive Rate (TPR)')
plt.title('Receiver Operating Characteristic (ROC) Curve')
plt.legend(loc="lower right")
plt.grid(True, alpha=0.3)
plt.show()
根据坐标点绘制ROC曲线:
AUC 值
AUC 值代表ROC曲线下的面积,用于量化模型性能。AUC值越大,模型区分正负类的能力越强,模型性能越好。$ AUC = 0.5 $表示模型接近随机猜测,$ AUC = 1 $代表完美模型。
示例代码:
from sklearn.metrics import roc_auc_score
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression

# 生成一个二分类数据集
X, y = make_classification(n_samples=1000, n_features=20, n_classes=2, random_state=100)

# 划分训练集和测试集
x_train, x_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=100)

# 训练一个逻辑回归模型
model = LogisticRegression()
model.fit(x_train, y_train)

# 预测概率值(取正类的概率)
y_pred_proba = model.predict_proba(x_test)[:, 1]

# 计算AUC
auc_score = roc_auc_score(y_test, y_pred_proba) # 可通过sklearn.metrics.roc_auc_score计算AUC值。
print(auc_score)
第四章 KNN 算法
基本介绍
K近邻(K-Nearest Neighbors,KNN)是一种基于实例的监督学习算法,既可以用于分类问题,也可以用于回归问题。
在了解KNN算法之前,需要先理解什么是分类问题和回归问题:
分类问题(Classification):
- 定义:预测离散的类别标签,输出是有限的类别集合
- 特点:目标变量是离散的、无序的或有序的类别
- 示例:
- 邮件分类:判断邮件是"垃圾邮件"还是"正常邮件"(二分类)
- 图像识别:识别图片中的动物是"猫"、"狗"还是"鸟"(多分类)
- 疾病诊断:判断患者是否患有某种疾病(二分类)
- 输出:类别标签(如:0/1、A/B/C、是/否等)
回归问题(Regression):
- 定义:预测连续的数值,输出是实数
- 特点:目标变量是连续的数值
- 示例:
- 房价预测:预测房屋的价格(如:100万元、150万元等)
- 温度预测:预测明天的气温(如:25.5℃、30.2℃等)
- 股票价格:预测股票的未来价格
- 输出:连续数值(如:25.5、100.3、-2.7等)
KNN 核心思想:算法的基本假设是相似的样本具有相似的标签。对于一个待预测的样本,KNN 算法会在训练集中找到与它最相似的 K 个样本(即 K 个最近邻)。
- 对于分类问题:通过投票机制,选择K个最近邻中出现次数最多的类别作为预测结果
- 对于回归问题:通过计算K个最近邻的平均值作为预测结果
KNN 特点:
- 惰性学习(Lazy Learning):KNN是一种惰性学习算法,在训练阶段不进行任何计算,只是简单地存储训练数据。所有的计算都在预测阶段进行
- 非参数方法:KNN不对数据分布做任何假设,是一种非参数方法
- 基于实例:KNN直接使用训练样本进行预测,不需要学习模型参数
- K 值:K 值的选择对结果影响很大。K 值过小容易过拟合,K 值过大则可能欠拟合。
算法原理
分类问题
分类问题是指预测离散类别标签的问题。在分类问题中,KNN算法的步骤如下:
- 计算距离:对于待预测样本$ x $,计算它与训练集中所有样本的距离
- 选择K个最近邻:根据距离从小到大排序,选择距离最近的K个样本
- 投票决策:统计这K个最近邻中各类别的出现次数,选择出现次数最多的类别作为预测结果
数学表示:
设训练集为$ T = {(x_1, y_1), (x_2, y_2), \ldots, (x_n, y_n)} $,其中$ x_i $为特征向量,$ y_i $为类别标签。
对于待预测样本$ x $,其预测类别为:
$ \hat{y} = \arg\max_{c} \sum_{i=1}^{K} I(y_i = c) $
其中:
- $ K $为最近邻的数量
- $ I(\cdot) $为指示函数,当条件成立时返回1,否则返回0
- $ c $为类别标签
回归问题
回归问题是指预测连续数值的问题。在回归问题中,KNN算法的步骤如下:
- 计算距离:对于待预测样本$ x $,计算它与训练集中所有样本的距离
- 选择K个最近邻:根据距离从小到大排序,选择距离最近的K个样本
- 计算平均值:计算这K个最近邻的标签平均值作为预测结果
数学表示:
对于待预测样本$ x $,其预测值为:
$ \hat{y} = \frac{1}{K}\sum_{i=1}^{K} y_i $
其中,$ y_i $为第$ i $个最近邻的标签值。
加权 KNN
在实际应用中,可以使用加权 KNN,即距离越近的样本权重越大:
加权分类:
$ \hat{y} = \arg\max_{c} \sum_{i=1}^{K} w_i \cdot I(y_i = c) $
加权回归:
$ \hat{y} = \frac{\sum_{i=1}^{K} w_i \cdot y_i}{\sum_{i=1}^{K} w_i} $
其中,权重$ w_i $通常与距离成反比,常用的权重函数有:
- 反距离权重:$ w_i = \frac{1}{d_i} $,其中$ d_i $为距离
- 反距离平方权重:$ w_i = \frac{1}{d_i^2} $,对距离更敏感
- 高斯权重:$ w_i = \exp(-\frac{d_i^2}{\sigma^2}) $,其中$ \sigma $为带宽参数
- 线性权重:$ w_i = 1 - \frac{d_i}{d_{max}} $,其中$ d_{max} $为K个最近邻中的最大距离
权重选择建议:
- 当数据噪声较大时,使用反距离平方权重或高斯权重,可以更好地抑制远距离样本的影响
- 当数据质量较好时,可以使用反距离权重或线性权重
距离度量
欧氏距离(Euclidean Distance)
欧几里得距离(Euclidean Distance)是指连接两点的线段的长度。欧氏距离是最常用的距离度量方法,适用于连续型特征。
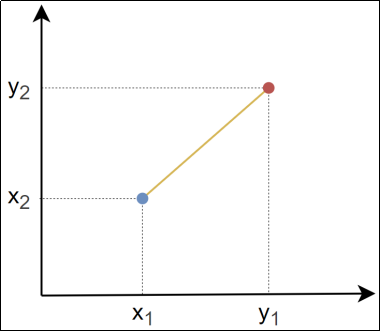
公式:
$ d(x, y) = \sqrt{\sum_{i=1}^{n}(x_i - y_i)^2} $
其中,$ x = (x_1, x_2, \ldots, x_n) $和$ y = (y_1, y_2, \ldots, y_n) $为两个样本的特征向量。
特点:
- 直观易懂,计算简单
- 对特征尺度敏感,需要先进行标准化
曼哈顿距离(Manhattan Distance)
曼哈顿距离(Manhattan Distance)是两点在标准坐标系上的绝对轴距之和。
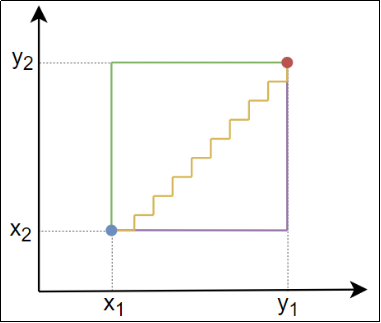
曼哈顿距离得名于纽约曼哈顿的街道布局。由于曼哈顿的街道多为规则的网格状,车辆只能沿水平和垂直方向行驶,无法直接斜穿。因此,两点之间的实际行驶距离是沿街道行走的距离,而非直线距离,也称为城市街区距离。
公式:
$ d(x, y) = \sum_{i=1}^{n}|x_i - y_i| $
特点:
- 适用于高维数据
- 对异常值不敏感
切比雪夫距离(Chebyshev Distance)
切比雪夫距离(Chebyshev Distance)是两点各坐标数值差的最大值。
在国际象棋中,国王可以横向、纵向或斜向移动一格。其从起点到终点的最少步数就等于两点之间的切比雪夫距离,也称为棋盘距离。
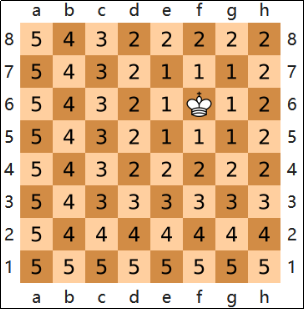
点 $ x(x_{1},\ldots,x_{n}) $ 和 $ y(y_{1},\ldots,y_{n}) $ 之间的切比雪夫距离$ d(x,y)=\max(\left|x_{i}-y_{i}\right|) $。
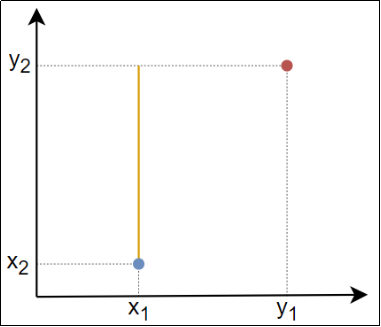
公式:
$ d(x, y) = \max_{i} |x_i - y_i| $
特点:
- 只考虑最大维度上的差异
- 适用于某些特殊场景,如棋盘移动、图像处理
代码示例:
from sklearn.neighbors import KNeighborsClassifier

# 使用切比雪夫距离
knn = KNeighborsClassifier(
    n_neighbors=5,
    metric='chebyshev'
)
闵可夫斯基距离(Minkowski Distance)
闵可夫斯基距离(Minkowski Distance)是一种用于度量多维空间中两点间距离的通用方法,点$ x(x_{1},\dots,x_{n}) $和$ y(y_{1},\dots,y_{n}) $之间的闵可夫斯基距离$ d(x,y)=(\sum_{i=1}^{n}(|x_{i}-y_{i}|)^{p})^{\frac{1}{p}} $。p越小,对多个维度的差异更敏感;p越大,更关注最大维度的差异。
通过调整参数p,闵可夫斯基距离可以退化为以下经典距离:
- 曼哈顿距离:p=1,$ d(x,y)=\sum_{i=1}^{n}|x_{i}-y_{i}| $。
- 欧氏距离:p=2,$ d(x,y)=\sqrt{\sum_{i=1}^{n}(x_{i}-y_{i})^{2}} $。
- 切比雪夫距离:p=∞,$ d(x,y)=\max(|x_{i}-y_{i}|) $。
K 值选择
K值的选择对KNN算法的性能有重要影响:
- K 值过小(K=1),模型复杂度高,容易过拟合。对噪声敏感,预测结果不稳定。决策边界复杂,容易产生误分类。
- 适用场景:数据量很大且噪声较少,需要捕捉局部细节。
- K 值过大,模型复杂度低,可能欠拟合。预测结果稳定,但可能忽略局部特征。决策边界平滑,但可能过于简单
- 适用场景:数据量较小,数据噪声较大。
最优K值选择常用方法:
- 交叉验证:使用交叉验证评估不同K值的性能,选择性能最好的K值
- 经验法则:通常选择$ K = \sqrt{n} $,其中$ n $为训练样本数
- 奇数选择:对于二分类问题,通常选择奇数K值,避免平票情况
K 值选择的详细步骤:
- 确定 K 值范围:通常从1开始,到$ \sqrt{n} $或$ n/2 $,但不超过训练样本数
- 交叉验证评估:对每个K值使用k折交叉验证评估性能
- 绘制性能曲线:绘制K值与性能指标的关系曲线
- 选择最优K值:选择性能最好且稳定的K值(避免选择性能曲线上的局部最优)
代码示例:
import numpy as np
import matplotlib.pyplot as plt
from sklearn.neighbors import KNeighborsClassifier
from sklearn.model_selection import cross_val_score
from sklearn.datasets import load_iris

# 加载数据
iris = load_iris()
X, y = iris.data, iris.target

# 测试不同的K值
k_range = range(1, 31)
k_scores = []
k_stds = []

for k in k_range:
    knn = KNeighborsClassifier(n_neighbors=k)
    scores = cross_val_score(knn, X, y, cv=10, scoring='accuracy')
    k_scores.append(scores.mean())
    k_stds.append(scores.std())

# 绘制结果
plt.figure(figsize=(12, 5))

# 子图1:准确率曲线
plt.subplot(1, 2, 1)
plt.plot(k_range, k_scores, marker='o')
plt.fill_between(k_range,
                 np.array(k_scores) - np.array(k_stds),
                 np.array(k_scores) + np.array(k_stds),
                 alpha=0.2)
plt.xlabel('K值')
plt.ylabel('交叉验证准确率')
plt.title('K值对KNN算法性能的影响')
plt.grid(True)

# 子图2:标准差曲线(稳定性)
plt.subplot(1, 2, 2)
plt.plot(k_range, k_stds, marker='s', color='red')
plt.xlabel('K值')
plt.ylabel('准确率标准差')
plt.title('K值对模型稳定性的影响')
plt.grid(True)

plt.tight_layout()
plt.show()

# 找到最优K值(考虑准确率和稳定性)
optimal_k = k_range[np.argmax(k_scores)]
print(f"最优K值: {optimal_k}")
print(f"最优准确率: {max(k_scores):.4f} ± {k_stds[optimal_k-1]:.4f}")
注意:
- 考虑数据量:数据量大时可以适当增大K值
- 考虑类别数:多分类问题可能需要更大的K值
- 考虑数据分布:数据分布不均匀时,需要调整K值
归一化和标准化
归一化
定义:将数据按比例缩放到固定范围(如 $ [0,1] $ 或 $ [-1,1] $)。
- 单特征缩放至 $ [0,1] $:
$ x' = \frac{x - x_{\text{min}}}{x_{\text{max}} - x_{\text{min}}} $
- 单特征缩放至 $ [-1,1] $:
$ x' = 2 \times \frac{x - x_{\text{min}}}{x_{\text{max}} - x_{\text{min}}} - 1 $
目的
- 消除量纲差异:不同特征的单位或量纲可能差异巨大(例如身高以米为单位,体重以千克为单位),归一化可消除这种差异,避免模型被大范围特征主导。
- 加速模型收敛:对于梯度下降等优化算法,归一化后特征处于相近的尺度,优化路径更平滑,收敛速度更快。
- 适配特定模型需求:某些模型(如神经网络、K近邻、SVM)对输入数据的范围敏感,归一化能显著提升其性能。
适用场景:归一化不改变原始分布形状,但对异常值比较敏感。当数据分布有明显边界(如图像像素值、文本词频),或模型对输入范围敏感时可以优先考虑归一化。
API 使用:
from sklearn.preprocessing import MinMaxScaler

X = [[2, 1], [3, 1], [1, 4], [2, 6]]
# 归一化,区间设置为(-1,1)
X = MinMaxScaler(feature_range=(-1, 1)).fit_transform(X)
print(X)
标准化
定义:将数据调整为均值 $ \boldsymbol{\mu}=0 $、标准差 $ \boldsymbol{\sigma}=1 $ 的标准正态分布。
公式:
$ x' = \frac{x - \mu}{\sigma} $
**其中: **
- 均值 $ \mu = \frac{\sum_{i=1}^{n} x_i}{n} $**(样本平均值); **
- 标准差 $ \sigma = \sqrt{\frac{\sum_{i=1}^{n} (x_i - \mu)^2}{n}} $(样本标准差)。
目的
- 适应数据分布:将数据转换为均值为0、标准差为1的分布,适合假设数据服从正态分布的模型(如线性回归、逻辑回归)。
- 稳定模型训练:标准化后的数据对异常值的敏感度较低(相比归一化),鲁棒性更强。
- 统一特征尺度:与归一化类似,标准化也能消除量纲差异,但更关注数据的统计分布而非固定范围。
适用场景:大多数场景下标准化更通用,尤其是数据分布未知或存在轻微异常值时。
API 使用:
from sklearn.preprocessing import StandardScaler

X = [[2, 1], [3, 1], [1, 4], [2, 6]]
# 标准化
X = StandardScaler().fit_transform(X)
print(X)
超参数调优
基本介绍
网格搜索(Grid Search)是一种系统化的超参数调优方法,通过遍历预定义的超参数组合,找到使模型性能最优的参数配置。通过自动化调参避免手动试错,提高效率。
网格搜索通常嵌套交叉验证,与交叉验证结合以提高调参的可靠性:
- 外层循环:遍历参数网格中的每个参数组合
- 内层循环:对每个参数组合使用交叉验证评估模型性能
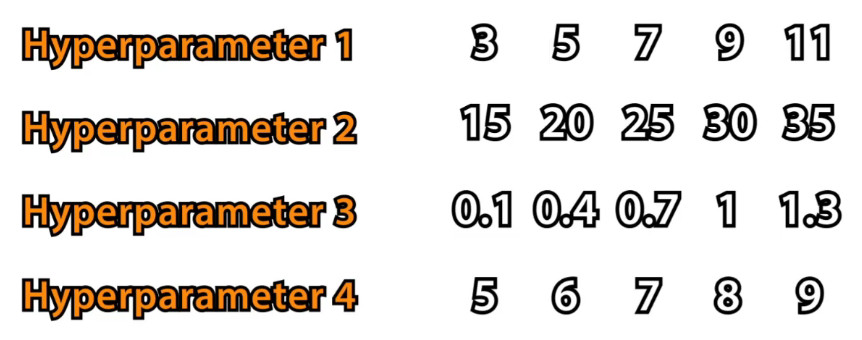
KNN算法的主要超参数:
n_neighbors:K值,最近邻的数量weights:权重函数,可选'uniform'(均匀权重)或'distance'(距离权重)metric:距离度量方法,如'euclidean'、'manhattan'、'minkowski'等p:闵可夫斯基距离的参数,当p=2时为欧氏距离,p=1时为曼哈顿距离algorithm:用于计算最近邻的算法,如'auto'、'kd_tree'、'ball_tree'、'brute'
实现步骤:
- 确定超参数及候选范围 根据模型类型,选择需要优化的超参数,并人为设定每组超参数的候选 取值(如[0.1,1,10])。
- 构建超参数网格 对所有超参数的候选值进行笛卡尔积组合,形成待验证的参数网格 (例如2个超参数各有3个候选值,可生成3×3=9组组合)。
- 交叉验证评估 对网格中的每组超参数,使用交叉验证(如5折交叉验证)训练模型 并计算验证集上的性能指标(如准确率、F1分数、MSE等)
- 选择最优超参数 统计所有组合的交叉验证结果,选取性能最优的一组超参数作为最终结果。
案例演示:
from sklearn.neighbors import KNeighborsClassifier
from sklearn.model_selection import GridSearchCV
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
import pandas as pd

# 加载数据
iris = load_iris()
X, y = iris.data, iris.target

# 划分训练集和测试集
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, random_state=42
)

# 创建KNN分类器
knn = KNeighborsClassifier()

# 定义参数网格,K值设置为1到20
param_grid = {
    "n_neighbors": list(range(1, 21)),
    "weights": ["uniform", "distance"],
    "metric": ["euclidean", "manhattan", "minkowski"]
}

# 使用GridSearchCV进行网格搜索和交叉验证
# GridSearchCV(estimator=模型, param_grid=网格搜索参数, cv=k折交叉验证)
knn = GridSearchCV(
    estimator=knn,           # 要调优的模型
    param_grid=param_grid,   # 参数网格
    cv=10,                   # 10折交叉验证
    scoring='accuracy',       # 评估指标
    n_jobs=-1,               # 使用所有CPU核心并行计算
    verbose=1                # 显示详细进度
)

# 模型训练(会自动进行网格搜索和交叉验证)
knn.fit(X_train, y_train)

# 查看所有交叉验证结果
print("所有交叉验证结果:")
results_df = pd.DataFrame(knn.cv_results_)
print(results_df[['param_n_neighbors', 'param_weights', 'param_metric',
                  'mean_test_score', 'std_test_score', 'rank_test_score']].head(10))

# 查看最佳参数
print(f"\n最佳参数: {knn.best_params_}")
print(f"最佳交叉验证得分: {knn.best_score_:.4f}")
print(f"最佳参数组合的排名: {knn.best_index_}")

# 使用最佳模型进行评估
best_knn = knn.best_estimator_
test_score = best_knn.score(X_test, y_test)
print(f"\n测试集得分: {test_score:.4f}")

# 使用最佳模型进行预测
y_pred = best_knn.predict(X_test)
print(f"预测准确率: {accuracy_score(y_test, y_pred):.4f}")
GridSearchCV 主要参数说明:
estimator:要调优的模型对象param_grid:参数字典或字典列表,定义要搜索的参数空间cv:交叉验证折数,可以是整数(如10表示10折)或交叉验证对象scoring:评估指标,如'accuracy'、'f1'、'roc_auc'等n_jobs:并行任务数,-1表示使用所有CPU核心verbose:详细程度,0(不输出)到3(最详细)refit:是否使用最佳参数在整个训练集上重新训练,默认为Truereturn_train_score:是否返回训练集得分,默认为False
GridSearchCV 主要属性:
best_params_:最佳参数组合best_score_:最佳交叉验证得分best_estimator_:使用最佳参数训练的模型best_index_:最佳参数组合在cv_results_中的索引cv_results_:所有参数组合的详细交叉验证结果
示例一:只调优 K 值
如果只需要调优K值,可以使用更简单的参数网格:
from sklearn.neighbors import KNeighborsClassifier
from sklearn.model_selection import GridSearchCV
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
import pandas as pd

# 加载数据
iris = load_iris()
X, y = iris.data, iris.target

# 划分训练集和测试集
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, random_state=42
)

# 创建KNN分类器
knn = KNeighborsClassifier()

# 网格搜索参数,K值设置为1到10
param_grid = {"n_neighbors": list(range(1, 11))}

# GridSearchCV(estimator=模型, param_grid=网格搜索参数, cv=k折交叉验证)
knn = GridSearchCV(estimator=knn, param_grid=param_grid, cv=10)

# 模型训练
knn.fit(X_train, y_train)

# 查看结果
print(pd.DataFrame(knn.cv_results_))  # 所有交叉验证结果
print(knn.best_estimator_)  # 最佳模型
print(knn.best_score_)  # 最佳得分

# 使用最佳模型进行评估
knn = knn.best_estimator_
print(knn.score(X_test, y_test))
示例二:多参数组合
同时调优多个超参数:
from sklearn.neighbors import KNeighborsClassifier
from sklearn.model_selection import GridSearchCV
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler

# 加载数据
iris = load_iris()
X, y = iris.data, iris.target

# 数据标准化
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)

# 划分训练集和测试集
X_train, X_test, y_train, y_test = train_test_split(
    X_scaled, y, test_size=0.3, random_state=42
)

# 创建KNN分类器
knn = KNeighborsClassifier()

# 定义参数网格,包含多个超参数
param_grid = {
    "n_neighbors": [3, 5, 7, 9, 11, 15, 20],
    "weights": ["uniform", "distance"],
    "metric": ["euclidean", "manhattan"],
    "p": [1, 2]  # 仅当metric='minkowski'时有效
}

# 使用GridSearchCV进行网格搜索
knn = GridSearchCV(
    estimator=knn,
    param_grid=param_grid,
    cv=10,
    scoring='accuracy',
    n_jobs=-1,
    verbose=1
)

# 模型训练
knn.fit(X_train, y_train)

# 查看最佳参数
print("最佳参数组合:")
for param, value in knn.best_params_.items():
    print(f"  {param}: {value}")
print(f"\n最佳交叉验证得分: {knn.best_score_:.4f}")

# 使用最佳模型进行预测和评估
best_knn = knn.best_estimator_
y_pred = best_knn.predict(X_test)
print(f"测试集准确率: {best_knn.score(X_test, y_test):.4f}")
参数网格组合数量计算:
- 如果参数网格有$ n_1, n_2, \ldots, n_k $个候选值,则总共有$ n_1 \times n_2 \times \ldots \times n_k $种组合
- 例如:K值7个、权重2个、距离度量2个,共$ 7 \times 2 \times 2 = 28 $种组合
- 每种组合都要进行10折交叉验证,总共需要$ 28 \times 10 = 280 $次模型训练
结果分析
# 将交叉验证结果转换为DataFrame便于分析
results_df = pd.DataFrame(knn.cv_results_)

# 查看不同K值的表现
k_scores = results_df.groupby('param_n_neighbors')['mean_test_score'].mean()
print("不同K值的平均得分:")
print(k_scores)

# 查看不同权重策略的表现
weight_scores = results_df.groupby('param_weights')['mean_test_score'].mean()
print("\n不同权重策略的平均得分:")
print(weight_scores)

# 查看不同距离度量的表现
metric_scores = results_df.groupby('param_metric')['mean_test_score'].mean()
print("\n不同距离度量的平均得分:")
print(metric_scores)

# 找出前5个最佳参数组合
top5 = results_df.nlargest(5, 'mean_test_score')
print("\n前5个最佳参数组合:")
print(top5[['param_n_neighbors', 'param_weights', 'param_metric',
            'mean_test_score', 'std_test_score']])
局限性分析
尽管网格搜索逻辑清晰、易于实现,但它存在显著的计算瓶颈。尤其在复杂模型和大数据场景下更为明显:
- 计算成本高:当参数组合数量很大时,计算时间会很长。
- 参数空间离散:只能搜索预定义的参数值,可能错过最优值。
- 维度灾难:当超参数数量很多时,参数空间会急剧增大。
例如,若涉及五个超参数且每个有六个选项,则需训练模型 65 即 6776 次,计算开销极为庞大。
替代方案:
- 随机搜索(RandomizedSearchCV):随机采样参数组合,计算成本更低
- 贝叶斯优化:使用贝叶斯方法智能搜索参数空间
- 遗传算法:使用进化算法优化参数
随机搜索方法不再穷举所有可能的组合,而是为每个超参数设定取值范围,并根据预设的模型训练次数,从这些范围内随机采样数值进行组合实验。相比网格搜索,随机搜索在处理大量超参数和复杂模型时更具优势,因为它避免了对无效组合的全面评估,从而节省计算资源。
代码示例:
from sklearn.model_selection import RandomizedSearchCV
from scipy.stats import randint

# 定义参数分布(而不是参数列表)
param_dist = {
    "n_neighbors": randint(1, 31),  # 1到30的随机整数
    "weights": ["uniform", "distance"],
    "metric": ["euclidean", "manhattan", "minkowski"]
}

# 使用随机搜索
knn = RandomizedSearchCV(
    estimator=knn,
    param_distributions=param_dist,
    n_iter=50,  # 随机尝试50个参数组合
    cv=10,
    scoring='accuracy',
    n_jobs=-1,
    random_state=42
)

knn.fit(X_train, y_train)
print(f"最佳参数: {knn.best_params_}")
print(f"最佳得分: {knn.best_score_:.4f}")
随机搜索是找到更优超参数(hyperparameters)的更高效方式。
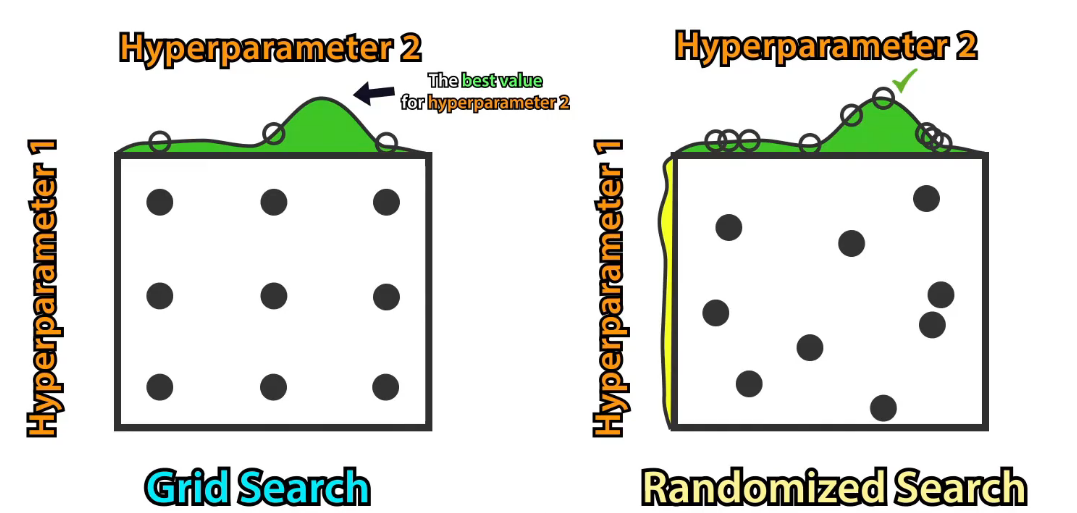
虽然引入了随机性,可能导致结果不稳定或耗时波动,但在超参数较多、搜索空间较大的场景下,更有可能快速逼近较优解。其成功依赖于两个关键因素:一是随机抽样是否幸运地覆盖到最优区域,二是预设的参数区间是否包含了理想组合。
经验表明,当超参数少且模型简单时,网格搜索更可靠;而当参数多、模型复杂时,随机搜索通常更高效。
代码实现
sklearn 实现 KNN 分类
基本使用:
from sklearn.neighbors import KNeighborsClassifier
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score

# 加载数据
iris = load_iris()
X, y = iris.data, iris.target

# 划分训练集和测试集
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, random_state=42
)

# 创建KNN分类器
knn = KNeighborsClassifier(n_neighbors=5)

# 训练模型
knn.fit(X_train, y_train)

# 预测
y_pred = knn.predict(X_test)

# 评估
accuracy = accuracy_score(y_test, y_pred)
print(f"准确率: {accuracy:.4f}")
参数说明:
n_neighbors:K值,默认值为5weights:权重函数,可选值:'uniform':所有最近邻权重相等(默认)'distance':权重与距离成反比- 自定义函数
algorithm:用于计算最近邻的算法,可选值:'auto':自动选择(默认)'ball_tree':使用Ball Tree'kd_tree':使用KD Tree'brute':暴力搜索
metric:距离度量方法,默认值为'minkowski'(即欧氏距离)p:闵可夫斯基距离的参数,当p=2时为欧氏距离,p=1时为曼哈顿距离
sklearn 实现 KNN 回归
from sklearn.neighbors import KNeighborsRegressor
from sklearn.datasets import make_regression
from sklearn.model_selection import train_test_split
from sklearn.metrics import mean_squared_error

# 生成回归数据
X, y = make_regression(n_samples=100, n_features=1, noise=10, random_state=42)

# 划分训练集和测试集
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, random_state=42
)

# 创建KNN回归器
knn_reg = KNeighborsRegressor(n_neighbors=5)

# 训练模型
knn_reg.fit(X_train, y_train)

# 预测
y_pred = knn_reg.predict(X_test)

# 评估
mse = mean_squared_error(y_test, y_pred)
print(f"均方误差: {mse:.4f}")
手动实现 KNN
import numpy as np
from collections import Counter

class KNN:
    def __init__(self, k=5, distance_metric='euclidean'):
        """
        初始化KNN分类器

        参数:
            k: 最近邻数量
            distance_metric: 距离度量方法,可选'euclidean'或'manhattan'
        """
        self.k = k
        self.distance_metric = distance_metric
        self.X_train = None
        self.y_train = None

    def fit(self, X, y):
        """
        训练模型(KNN只需存储数据)

        参数:
            X: 训练特征
            y: 训练标签
        """
        self.X_train = X
        self.y_train = y

    def _calculate_distance(self, x1, x2):
        """
        计算两个样本之间的距离

        参数:
            x1: 样本1
            x2: 样本2

        返回:
            距离值
        """
        if self.distance_metric == 'euclidean':
            return np.sqrt(np.sum((x1 - x2) ** 2))
        elif self.distance_metric == 'manhattan':
            return np.sum(np.abs(x1 - x2))
        else:
            raise ValueError(f"不支持的距离度量方法: {self.distance_metric}")

    def _get_k_nearest_neighbors(self, x):
        """
        获取K个最近邻

        参数:
            x: 待预测样本

        返回:
            K个最近邻的索引
        """
        distances = []
        for i, x_train in enumerate(self.X_train):
            dist = self._calculate_distance(x, x_train)
            distances.append((i, dist))

        # 按距离排序,选择前K个
        distances.sort(key=lambda x: x[1])
        k_nearest_indices = [idx for idx, _ in distances[:self.k]]
        return k_nearest_indices

    def predict(self, X):
        """
        预测

        参数:
            X: 待预测样本

        返回:
            预测结果
        """
        predictions = []
        for x in X:
            # 获取K个最近邻
            k_nearest_indices = self._get_k_nearest_neighbors(x)

            # 获取K个最近邻的标签
            k_nearest_labels = [self.y_train[i] for i in k_nearest_indices]

            # 投票决策(选择出现次数最多的标签)
            most_common = Counter(k_nearest_labels).most_common(1)
            predictions.append(most_common[0][0])

        return np.array(predictions)

# 使用示例
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score

# 加载数据
iris = load_iris()
X, y = iris.data, iris.target

# 划分训练集和测试集
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, random_state=42
)

# 创建并训练模型
knn = KNN(k=5, distance_metric='euclidean')
knn.fit(X_train, y_train)

# 预测
y_pred = knn.predict(X_test)

# 评估
accuracy = accuracy_score(y_test, y_pred)
print(f"准确率: {accuracy:.4f}")
案例:心脏病检测
- 准备数据集
Heart Disease 数据集Heart Disease Dataset。
(原文档附带的附件请到语雀源文档查看)
- 年龄:连续值
- 性别:0-女,1-男
- 胸痛类型:0-典型心绞痛,1-非典型心绞痛,2-非心绞痛,3-无症状
- 静息血压:连续值,单位mmHg
- 胆固醇:连续值,单位mg/dl
- 空腹血糖:1-大于120mg/dl,0-小于等于120mg/dl
- 静息心电图结果:0-正常,1-ST-T异常,2-可能左心室肥大
- 最大心率:连续值
- 运动性心绞痛:1-有,0-无
- 运动后的ST下降:连续值
- 峰值ST段的斜率:0-向上,1-水平,2-向下
- 主血管数量:0到3
- 地中海贫血:一种先天性贫血,0-正常,1-固定缺陷,2-可逆缺陷
- 是否患有心脏病:标签,0-否,1-是
- 加载数据集
import pandas as pd

# 加载数据集
heart_disease = pd.read_csv("heart_disease.csv")
# 处理缺失值
heart_disease.dropna()
heart_disease.info()
heart_disease.head()
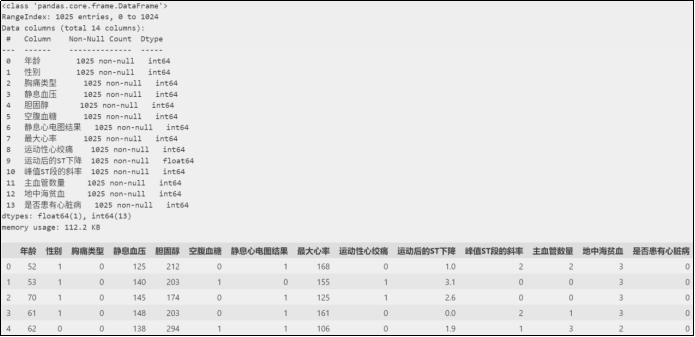
- 划分数据集
from sklearn.model_selection import train_test_split

# 划分特征和标签
X = heart_disease.drop("是否患有心脏病", axis=1)  # 特征
y = heart_disease["是否患有心脏病"]  # 标签
# 将数据集按7:3划分为训练数据与测试数据
x_train, x_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=100)
- 特征工程
数据集中包含多种类型的特征:
- 类别型特征(需要特殊处理)
- 胸痛类型:4种分类(名义变量)
- 静息心电图结果:3种分类(名义变量)
- 峰值ST段的斜率:3种分类(有序变量)
- 地中海贫血:4种分类(名义变量)
- 数值型特征(可直接标准化):年龄、静息血压、胆固醇、最大心率、运动后的ST下降、主血管数量
- 二元特征(保持原样):性别、空腹血糖、运动性心绞痛
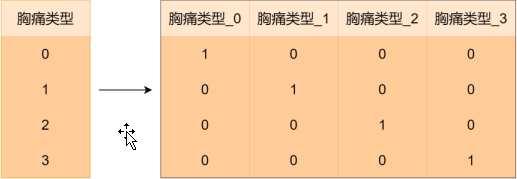
特征转换:对于类别型特征,直接使用整数编码的类别特征会被算法视为有序数值,导致错误的距离计算(例如:会认为胸痛类型=1 和 胸痛类型=2 之间的差异比 胸痛类型=1和 胸痛类型=3 之间差异更小,而实际上它们都是类别)。使用 独热编码(One-Hot Encoding)可将类别特征转换为二元向量,消除虚假的顺序关系。
from sklearn.preprocessing import StandardScaler, OneHotEncoder
from sklearn.compose import ColumnTransformer

# 数值型特征
numerical_features = ["年龄", "静息血压", "胆固醇", "最大心率", "运动后的ST下降", "主血管数量"]
# 类别型特征
categorical_features = ["胸痛类型", "静息心电图结果", "峰值ST段的斜率", "地中海贫血"]
# 二元特征
binary_features = ["性别", "空腹血糖", "运动性心绞痛"]
# 创建列转换器
preprocessor = ColumnTransformer(
    transformers=[
        # 对数值型特征进行标准化
        ("num", StandardScaler(), numerical_features),
        # 对类别型特征进行独热编码,使用drop="first"避免多重共线性
        ("cat", OneHotEncoder(drop="first"), categorical_features),
        # 二元特征不进行处理
        ("binary", "passthrough", binary_features),
    ]
)
# 执行特征转换
x_train = preprocessor.fit_transform(x_train)  # 计算训练集的统计信息并进行转换
x_test = preprocessor.transform(x_test)  # 使用训练集计算的信息对测试集进行转换
避免多重共线性:
多重共线性(Multicollinearity)是指特征之间存在高度线性相关关系的现象。
例如特征胸痛类型包含4个类别(0、1、2、3),若直接进行独热编码会生成4个新列(胸痛类型_0、胸痛类型_1、胸痛类型_2、胸痛类型_3),此时这4列满足

这种完全线性相关关系会导致特征矩阵的列之间存在完美共线性。
当特征矩阵存在多重共线性时,模型参数估计会变得不稳定(矩阵不可逆或接近奇异),导致系数估计值方差增大、模型可解释性下降、过拟合等问题。
drop="first"是独热编码中的一个参数,它的核心目的是避免多重共线性。在独热编码时设置drop="first",会删除每个类别特征的第1列,从而打破完全共线性。
比如特征胸痛类型会生成3列(胸痛类型_1、胸痛类型_2、胸痛类型_3),此时

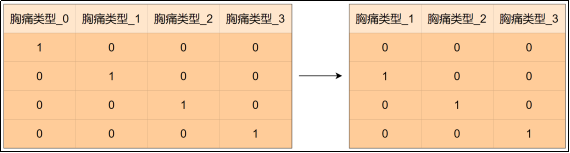
虽然KNN不直接受多重共线性影响(不像线性模型),但使用 drop="first" 也能够减少冗余特征,提升计算效率。
- 模型训练和评估
from sklearn.neighbors import KNeighborsClassifier

# 使用K近邻分类模型,K=3
knn = KNeighborsClassifier(n_neighbors=3)
# 模型训练
knn.fit(x_train, y_train)
# 模型评估,计算准确率
knn.score(x_test, y_test)
- 超参数调优:对模型训练与评估部分进行修改,使用
sklearn.model_selection.GridSearchCV进行交叉验证和网格搜索。
from sklearn.neighbors import KNeighborsClassifier
from sklearn.model_selection import GridSearchCV

knn = KNeighborsClassifier()
# 网格搜索参数,K值设置为1到10
param_grid = {"n_neighbors": list(range(1, 10))}
# GridSearchCV(estimator=模型, param_grid=网格搜索参数, cv=k折交叉验证)
knn = GridSearchCV(estimator=knn, param_grid=param_grid, cv=10)

# 模型训练
knn.fit(x_train, y_train)
print(pd.DataFrame(knn.cv_results_))  # 所有交叉验证结果
print(knn.best_estimator_)  # 最佳模型
print(knn.best_score_)  # 最佳得分
# 使用最佳模型进行评估
knn = knn.best_estimator_
print(knn.score(x_test, y_test))
- 模型的保存
可以使用 Python 的 joblib 库保存训练好的模型:
import joblib

joblib.dump(knn, "knn_heart_disease")
加载先前保存的模型:
# 加载模型
knn_loaded = joblib.load("knn_heart_disease")
# 预测
y_pred = knn_loaded.predict(x_test[10:11])
# 打印真实值与预测值
print(y_test.iloc[10], y_pred)
第五章 线性回归
基本介绍
线性回归(Linear Regression)是一种用于建模两个或多个变量之间线性关系的统计方法。它通过拟合一条直线(或超平面)来描述自变量(输入特征)与因变量(输出目标)之间的关联,并可用于预测或分析变量间的影响关系。
假设因变量$ y $与自变量$ x $之间的关系可以用如下线性方程表示:
$ y = \beta_0 + \beta_1 x_1 + \beta_2 x_2 + \cdots + \beta_m x_m $
其中:
- $ \beta_0 $:截距,模型在自变量全为0时的基准值
- $ \beta_1, \beta_2, \ldots, \beta_m $:自变量的系数,表示每个自变量对因变量的影响程度
通过估计这些系数,使模型预测值尽可能接近真实值。
一元与多元:
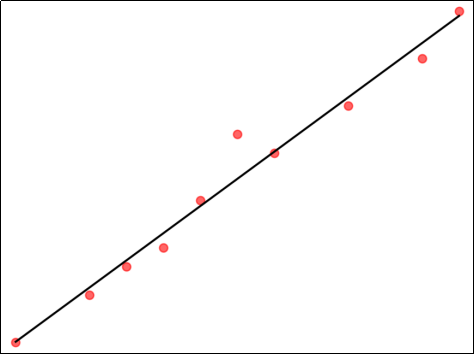
一元线性回归:仅有一个自变量:$ y = \beta_0 + \beta_1 x $
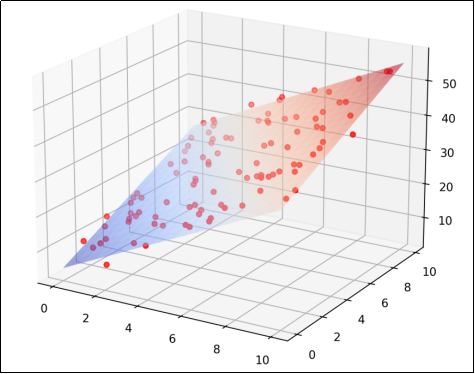
多元线性回归:包含多个自变量:$ y = \beta_0 + \beta_1 x_1 + \beta_2 x_2 + \cdots + \beta_m x_m $
线性回归应用场景:
- GDP 预测:用历史数据(如投资、消费、出口)建立回归模型,预测GDP 增长趋势。
- 广告效果评估:量化不同渠道广告投入对销售额的影响,优化预算分配。
- 药物剂量研究:分析药物剂量与患者生理指标(如血压、血糖)之间的关系。
- 产品质量控制:通过生产参数(温度、压力、原料配比)预测产品性能(如强度、耐久)。
- 政策效果评估:分析最低工资政策对就业率的影响,或环保法规对污染排放的抑制作用。
- 气候变化建模:用工业排放量、森林覆盖率等变量预测全球气温变化趋势。
API 使用:
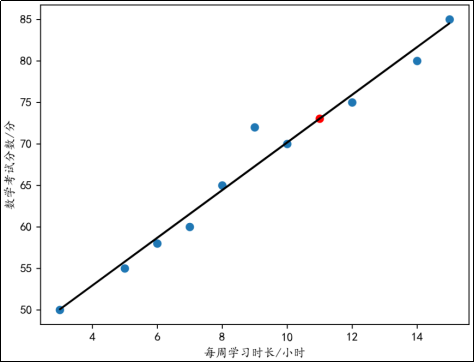
例如,某中学教师想研究学生每周学习时间(小时)与数学考试成绩(0-100分)之间的关系,并预测学生成绩。
from sklearn.linear_model import LinearRegression

# 自变量,每周学习时长
X = [[5], [8], [10], [12], [15], [3], [7], [9], [14], [6]]
# 因变量,数学考试成绩
y = [55, 65, 70, 75, 85, 50, 60, 72, 80, 58]
# 实例化线性回归模型
model = LinearRegression()
# 模型训练
model.fit(X, y)
# 系数,每周每学习1小时,成绩会增加多少分
print(model.coef_)
# 截距
print(model.intercept_)
# 预测,每周学习11小时,成绩可能是多少分
print(model.predict([[11]]))
模型训练结果:
线性回归求解
损失函数
模型的预测值与真实值之间存在误差,需要用一个损失函数来度量。
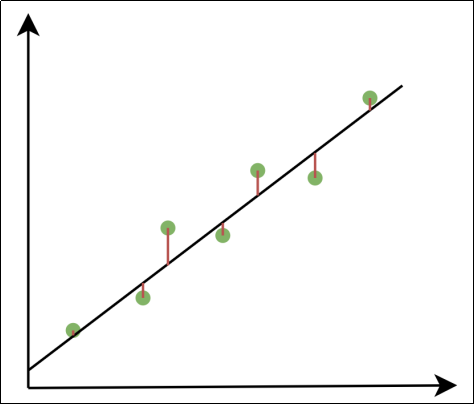
损失函数用于衡量模型预测值与真实值之间的误差,并通过最小化损失函数来优化模型参数。当损失函数最小时,得到的自变量系数就是最优解。
均方误差(MSE)
均方误差(Mean Squared Error,MSE)是回归任务中最常用的损失函数:
$ Loss_{MSE} = \frac{1}{n}\sum_{i=1}^{n}(y_i - \hat{y}i)^2 = \frac{1}{n}\sum{i=1}^{n}(y_i - f(x_i))^2 $
其中:
- $ n $:样本个数
- $ y_i $:第$ i $个样本的真实值
- $ \hat{y}_i = f(x_i) $:第$ i $个样本的预测值
均方误差对应了欧氏距离。基于均方误差最小化来进行模型求解的方法称为“最小二乘法”。在线性回归中,最小二乘法就是试图找到一条直线(或超平面),使所有样本到直线(或超平面)上的欧氏距离之和最小。
矩阵形式:
$ Loss_{MSE} = \frac{1}{n}(X\beta - y)^T(X\beta - y) $
其中:
- $ X $:特征矩阵($ n \times (m+1) $,含常数项列)
- $ \beta $:回归系数向量(含截距$ \beta_0 $)
- $ y $:真实标签向量
均方误差的特点:
- 对大误差敏感(平方项会放大较大误差)
- 是凸函数,存在全局唯一最小值
- 若误差服从正态分布,MSE 对应极大似然估计
误差服从正态分布时,均方误差与极大似然估计的关系:
假设因变量 $ y $ 与自变量 $ \boldsymbol{x} $ 的关系为:
$ y_i = \boldsymbol{\beta}^T \boldsymbol{x}_i + \epsilon_i $
其中 $ \epsilon_i $ 为误差项。当误差独立且具有相同分布,并且都服从正态分布时,单个误差的概率密度为:
$ p(\epsilon_i) = \frac{1}{\sqrt{2\pi\sigma^2}} \exp\left(-\frac{\epsilon_i^2}{2\sigma^2}\right) $
将 $ \epsilon_i = y_i - \boldsymbol{\beta}^T \boldsymbol{x}_i $ 代入,得到在给定 $ \boldsymbol{x}_i $ 和 $ \boldsymbol{\beta} $ 下 $ y_i $ 的条件概率:
$ p(y_i|\boldsymbol{x}_i; \boldsymbol{\beta}) = \frac{1}{\sqrt{2\pi\sigma^2}} \exp\left(-\frac{(y_i - \boldsymbol{\beta}^T \boldsymbol{x}_i)^2}{2\sigma^2}\right) $
似然函数(所有样本的联合概率):
$ L(\boldsymbol{\beta}) = \prod_{i=1}^{n} p(y_i|\boldsymbol{x}i; \boldsymbol{\beta}) = \prod{i=1}^{n} \frac{1}{\sqrt{2\pi\sigma^2}} \exp\left(-\frac{(y_i - \boldsymbol{\beta}^T \boldsymbol{x}_i)^2}{2\sigma^2}\right) $
对数似然函数(取对数将乘积化为求和,便于求极值):
$ \ln L(\boldsymbol{\beta}) = \ln \prod_{i=1}^{n} \frac{1}{\sqrt{2\pi\sigma^2}} \exp\left(-\frac{(y_i - \boldsymbol{\beta}^T \boldsymbol{x}_i)^2}{2\sigma^2}\right) $
$ = -n \ln \sqrt{2\pi\sigma^2} - \frac{1}{2\sigma^2} \sum_{i=1}^{n} (y_i - \boldsymbol{\beta}^T \boldsymbol{x}_i)^2 $
为使似然函数最大,需求解 $ \frac{1}{2\sigma^2}\sum_{i=1}^{n}(y_i - \boldsymbol{\beta}^T \boldsymbol{x}i)^2 = \frac{1}{2\sigma^2}\sum{i=1}^{n}(y_i - f(\boldsymbol{x}_i))^2 $ 的最小值,发现其与均方误差直接相关。即最大化对数似然函数等价于最小化均方误差。
平均绝对误差(MAE)
公式:
$ MAE = \frac{1}{n} \sum_{i=1}^{n} |f(\boldsymbol{x}_i) - y_i| $
平均绝对误差受异常值影响较小,但对小误差的惩罚较弱。适用于数据中存在显著异常值的场景(如金融风险预测)。
一元线性回归解析解
最小二乘法:在均方误差最小化意义下求线性回归的解析解。
推导过程:
对于一元线性回归,有:
$ f(x_i) = \beta_0 + \beta_1 x_i $
均方误差为:
$ MSE = \frac{1}{n} \sum_{i=1}^{n} (\beta_0 + \beta_1 x_i - y_i)^2 $
对 $ \beta_0 $ 求偏导:
$ \frac{\partial MSE}{\partial \beta_0} = \frac{\partial}{\partial \beta_0} \frac{1}{n} \sum_{i=1}^{n} (\beta_0 + \beta_1 x_i - y_i)^2 = \frac{2}{n} \sum_{i=1}^{n} (\beta_0 + \beta_1 x_i - y_i) $
令偏导等于 0:
$ \frac{2}{n} \sum_{i=1}^{n} (\beta_0 + \beta_1 x_i - y_i) = 0 \quad \Rightarrow \quad \sum_{i=1}^{n} (\beta_0 + \beta_1 x_i - y_i) = 0 $
即 $ n\beta_0 + \beta_1 \sum x_i - \sum y_i = 0 $,解得:
$ \beta_0 = \frac{1}{n} \sum_{i=1}^{n} (y_i - \beta_1 x_i) = \bar{y} - \beta_1 \bar{x} $
其中 $ \bar{x} = \frac{1}{n}\sum_{i=1}^{n}x_i $,$ \bar{y} = \frac{1}{n}\sum_{i=1}^{n}y_i $。
对 $ \beta_1 $ 求偏导:
$ \frac{\partial MSE}{\partial \beta_1} = \frac{2}{n} \sum_{i=1}^{n} (\beta_0 + \beta_1 x_i - y_i) x_i $
将 $ \beta_0 = \bar{y} - \beta_1 \bar{x} $ 代入:
$ \frac{\partial MSE}{\partial \beta_1} = \frac{2}{n} \sum_{i=1}^{n} \big((\bar{y} - \beta_1 \bar{x}) + \beta_1 x_i - y_i\big) x_i = \frac{2}{n} \sum_{i=1}^{n} \big(\beta_1 (x_i^2 - x_i\bar{x}) + x_i(\bar{y} - y_i)\big) $
令偏导等于 0,整理得:
$ \beta_1 \sum_{i=1}^{n} (x_i^2 - x_i \bar{x}) = \sum_{i=1}^{n} x_i (y_i - \bar{y}) $
即 $ \beta_1 \sum_{i=1}^{n} x_i (x_i - \bar{x}) = \sum_{i=1}^{n} x_i (y_i - \bar{y}) $。将分子分母中的 $ x_i $ 写成 $ (x_i - \bar{x} + \bar{x}) $,利用 $ \sum_{i=1}^{n} (y_i - \bar{y}) = 0 $ 和 $ \sum_{i=1}^{n} (x_i - \bar{x}) = 0 $,可得:
$ \beta_1 = \frac{\sum_{i=1}^{n} (x_i - \bar{x})(y_i - \bar{y})}{\sum_{i=1}^{n} (x_i - \bar{x})^2} $
也可写成 $ \beta_1 = \frac{Cov(x,y)}{Var(x)} $。
综上,一元线性回归解析解为:
$ \beta_1 = \frac{\sum_{i=1}^{n} (x_i - \bar{x})(y_i - \bar{y})}{\sum_{i=1}^{n} (x_i - \bar{x})^2}, \qquad \beta_0 = \bar{y} - \beta_1 \bar{x} $
解析法数值例题(正规方程法 / 一元情形)
以先前描述学生每周学习时间(小时)与数学考试成绩(0–100 分)为例,用解析公式直接计算 $ \beta $。
# 自变量,每周学习时长
X = [[5], [8], [10], [12], [15], [3], [7], [9], [14], [6]]
# 因变量,数学考试成绩
y = [55, 65, 70, 75, 85, 50, 60, 72, 80, 58]
可算得 $ \bar{x} = 8.9 $,$ \bar{y} = 67 $。
$ \beta_1 = \frac{\sum_{i=1}^{n} (x_i - \bar{x})(y_i - \bar{y})}{\sum_{i=1}^{n} (x_i - \bar{x})^2} = \frac{(5-8.9)(55-67) + (8-8.9)(65-67) + \cdots}{(5-8.9)^2 + (8-8.9)^2 + \cdots} = 2.8707 $
$ \beta_0 = \bar{y} - \beta_1 \bar{x} = 67 - 2.8707 \times 8.9 = 41.4507 $
解得:
$ \beta = \begin{pmatrix} \beta_0 \ \beta_1 \end{pmatrix} = \begin{pmatrix} 41.4507 \ 2.8707 \end{pmatrix} $
正规方程法(解析法)
正规方程法(Normal Equation)是基于最小二乘的解析解法:将均方误差写成矩阵形式,对 $ \beta $ 求偏导并令其为零,通过解矩阵方程直接得到参数。
损失函数从求和形式到矩阵形式:
$ MSE = \frac{1}{n} \sum_{i=1}^{n} (f(x_i) - y_i)^2 = \frac{1}{n} \sum_{i=1}^{n} \big((\beta_0 + \beta_1 x_{i1} + \beta_2 x_{i2} + \cdots + \beta_m x_{im}) - y_i\big)^2 $
用向量表示每个样本的预测:$ f(x_i) = \boldsymbol{\beta}^T \boldsymbol{x}_i $,则:
$ MSE = \frac{1}{n} \sum_{i=1}^{n} (\boldsymbol{\beta}^T \boldsymbol{x}_i - y_i)^2 = \frac{1}{n} |X\beta - y|_2^2 = \frac{1}{n} (X\beta - y)^T (X\beta - y) $
矩阵与向量的定义:
- $ X $(设计矩阵 / 特征矩阵):$ n \times (m+1) $ 矩阵,包含一个全 1 的列(对应截距 $ \beta_0 $):
$ X = \begin{pmatrix} 1 & x_{11} & x_{12} & \cdots & x_{1m} \ 1 & x_{21} & x_{22} & \cdots & x_{2m} \ \vdots & \vdots & \vdots & \ddots & \vdots \ 1 & x_{n1} & x_{n2} & \cdots & x_{nm} \end{pmatrix} $
- $ \beta $(参数向量):$ (m+1) \times 1 $,包含截距项 $ \beta_0 $:
$ \beta = \begin{pmatrix} \beta_0 \ \beta_1 \ \vdots \ \beta_m \end{pmatrix} $
- $ y $(因变量向量):$ n \times 1 $ 的标签向量。
对 $ \beta $ 求偏导:
$ \frac{\partial MSE}{\partial \beta} = \frac{\partial \left( \frac{1}{n}(X\beta - y)^T (X\beta - y) \right)}{\partial \beta} = \frac{2}{n} X^T (X\beta - y) $
当 $ X^T X $ 为满秩矩阵或正定矩阵时,令偏导等于 0:
$ \frac{2}{n} X^T (X\beta - y) = 0 \quad \Rightarrow \quad X^T X \beta = X^T y $
解析解(正规方程):
$ \beta = (X^T X)^{-1} X^T y $
API 使用:
# fit_intercept: 是否计算偏置
model = sklearn.linear_model.LinearRegression(fit_intercept=True)
model.fit([[0, 3], [1, 2], [2, 1]], [0, 1, 2])
# coef_: 系数
print(model.coef_)
# intercept_: 偏置
print(model.intercept_)
适用场景:正规方程法适用于特征数量较少的情况。当特征数量较大时,计算逆矩阵的复杂度会显著增加,此时梯度下降法更为适用。
梯度下降法
当特征较多或$ X^T X $不可逆时,常用梯度下降法迭代求解。
更新公式:
$ \beta_{t+1} = \beta_t - \alpha \nabla L(\beta_t) $
其中:
- $ \alpha $:学习率(步长)
- $ \nabla L(\beta_t) = \frac{2}{n}X^T(X\beta_t - y) $:损失函数在$ \beta_t $处的梯度
线性回归的梯度:
设$ L(\beta) = \frac{1}{n}\sum_{i=1}^{n}(x_i^T\beta - y_i)^2 $,则:
$ \frac{\partial L}{\partial \beta} = \frac{2}{n}X^T(X\beta - y) $
参数更新:
$ \beta \leftarrow \beta - \alpha \cdot \frac{2}{n}X^T(X\beta - y) $
计算步骤:
- 初始化参数:给定初始$ \beta $(如零向量或随机小值)
- 计算梯度:$ \nabla L(\beta) = \frac{2}{n}X^T(X\beta - y) $
- 更新参数:$ \beta \leftarrow \beta - \alpha \nabla L(\beta) $
- 重复 2–3 步,直到梯度足够小或达到最大迭代次数
以前述学生每周学习时间(小时)与数学考试成绩(0–100 分)为例。自变量(每周学习时长)与因变量(数学成绩)为:
# 自变量, 每周学习时长
X_raw = [5, 8, 10, 12, 15, 3, 7, 9, 14, 6]
# 因变量, 数学考试成绩
y = [55, 65, 70, 75, 85, 50, 60, 72, 80, 58]
求 $ \beta = [\beta_0 \ \beta_1]^T $ 使得损失函数 $ J(\beta) = \frac{1}{n} \sum_{i=1}^{n} (f(x_i) - y_i)^2 $ 最小,需要先求出损失函数相对 $ \beta $ 的梯度。
数据与设计矩阵:
$ \boldsymbol{x} $ 添加一列 1 后得到设计矩阵($ n \times 2 $ 的转置形式):
$ X = \begin{bmatrix} 1 & 1 & 1 & 1 & 1 & 1 & 1 & 1 & 1 & 1 \ 5 & 8 & 10 & 12 & 15 & 3 & 7 & 9 & 14 & 6 \end{bmatrix}^T $
则损失函数可写为 $ J(\beta) = \frac{1}{n} |X\beta - y|_2^2 $。梯度为:
$ \nabla J(\beta) = \frac{2}{n} X^T (X\beta - y) $
梯度下降迭代: 取 $ \beta $ 初始值 $ [1 \ 1]^T $,学习率 $ \alpha = 0.01 $。
| 迭代 | $ \beta $ | $ J(\beta) $ | $ \nabla J(\beta) $ |
|---|---|---|---|
| 1 | $ \begin{bmatrix} 1 \ 1 \end{bmatrix} $ | 3311.3 | $ \begin{bmatrix} -114.2 \ -1067.6 \end{bmatrix} $ |
| 2 | $ \beta_2 = \beta_1 - \alpha \nabla J(\beta_1) = \begin{bmatrix} 2.142 \ 11.676 \end{bmatrix} $ | 2589.97 | $ \begin{bmatrix} 78.12 \ 936.33 \end{bmatrix} $ |
| 3 | $ \beta_3 = \beta_2 - \alpha \nabla J(\beta_2) = \begin{bmatrix} 1.361 \ 2.313 \end{bmatrix} $ | … | … |
| … | … | … | … |
| $ n $ | $ \beta_n \approx \begin{bmatrix} 41.4507 \ 2.8707 \end{bmatrix} $ | $ J(\beta_n) \approx 2.981 $ | $ \nabla J(\beta_n) \approx \begin{bmatrix} -2.34 \times 10^{-12} \ 1.18 \times 10^{-13} \end{bmatrix} $ |
迭代收敛后,梯度接近 0,得到与解析解一致的 $ \beta_0 \approx 41.45 $、$ \beta_1 \approx 2.87 $。
示例代码:
import numpy as np
import matplotlib.pyplot as plt

# 定义损失函数
def J(beta):
    return np.sum((y - X.dot(beta)) ** 2) / n


# 定义梯度函数
def gradient(beta):
    return X.T.dot(X.dot(beta) - y) / n * 2


# 1. 定义数据
X = np.array([[5], [8], [10], [12], [15], [3], [7], [9], [14], [6]])  # 自变量,每周学习时长
y = np.array([[55], [65], [70], [75], [85], [50], [60], [72], [80], [58]])  # 因变量,数学考试成绩
n = X.shape[0]

# 2. 处理数据,X增加一列1
X = np.hstack((np.ones((n, 1)), X))  # 加一列 1 是为了能拟合带截距的直线,而不是强制过原点的直线

# 3. 初始化参数及超参数
beta = np.array([[1], [1]])
alpha = 0.01
i = 10000
beta1 = []
beta2 = []

# 4. 计算梯度
while (np.abs(grad := gradient(beta)) > 1e-10).any() and (i := i - 1) >= 0:

    # 5. 更新参数
    beta = beta - alpha * grad

    beta1.append(beta[0][0])
    beta2.append(beta[1][0])
    if i % 1000 == 0:
        print('第%d次迭代,损失为%f' % (i, J(beta)))
# 6. 输出结果
print(i)
plt.plot(beta1, beta2)
plt.show()
模型训练结果:
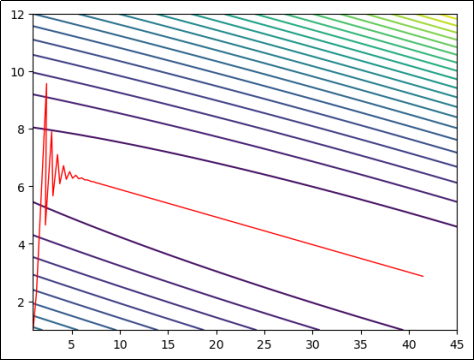
学习率的选择:
- 学习率过大:可能发散或不稳定
- 学习率过小:收敛慢
- 自适应学习率:高级优化器(如Adam、Adagrad)动态调整学习率以提升性能
常用策略:固定小学习率、衰减学习率或使用自适应优化器。
API 使用:
import numpy as np
from sklearn.linear_model import SGDRegressor

# 1. 定义数据
X = np.array([[5], [8], [10], [12], [15], [3], [7], [9], [14], [6]])  # 自变量,每周学习时长
y = np.array([[55], [65], [70], [75], [85], [50], [60], [72], [80], [58]])  # 因变量,数学考试成绩
n = X.shape[0]

# 2. 定义模型
model = SGDRegressor(
    loss='squared_loss', # 损失函数--最小二乘损失函数
    penalty='l2', # 正则化项--L2正则化
    max_iter=100000, # 迭代次数
    eta0=0.01, # 学习率
    learning_rate='constant', # 固定学习率--每次迭代时学习率不变
    tol=1e-8 # 停止条件

)

model.fit(X, y)
print(model.coef_)
print(model.intercept_)
案例:广告投放效果预测
Advertising 数据集:Advertising dataset。
(原文档附带的附件请到语雀源文档查看)
字段含义:
- ID:序号
- TV:电视广告投放金额,单位千元
- Radio:广播广告投放金额,单位千元
- Newspaper:报纸广告投放金额,单位千元
- Sales:销售额,单位百万元
代码实现线性回归预测广告投放效果:
import pandas as pd
from sklearn.preprocessing import StandardScaler # 标准化
from sklearn.model_selection import train_test_split # 划分数据集
from sklearn.linear_model import LinearRegression, SGDRegressor # 线性回归-正规方程,线性回归-随机梯度下降
from sklearn.metrics import mean_squared_error # 均方误差

# 用 TV、Radio、Newspaper 三种广告渠道的投入金额预测 Sales(销售额)

# 加载数据集
advertising = pd.read_csv("advertising.csv")
advertising.drop(advertising.columns[0], axis=1, inplace=True)
advertising.dropna(inplace=True)
advertising.info()
print(advertising.head())

# 划分训练集与测试集
X = advertising.drop("Sales", axis=1)
y = advertising["Sales"]
x_train, x_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=0)

# 标准化
preprocessor = StandardScaler()
x_train = preprocessor.fit_transform(x_train) # 计算训练集的均值和标准差,并标准化训练集
x_test = preprocessor.transform(x_test) # 使用训练集的均值和标准差对测试集标准化

# 使用正规方程法拟合线性回归模型
normal_equation = LinearRegression()
normal_equation.fit(x_train, y_train)
print("正规方程法解得模型系数:", normal_equation.coef_)
print("正规方程法解得模型偏置:", normal_equation.intercept_)

# 使用随机梯度下降法拟合线性回归模型
gradient_descent = SGDRegressor()
gradient_descent.fit(x_train, y_train)
print("随机梯度下降法解得模型系数:", gradient_descent.coef_)
print("随机梯度下降法解得模型偏置:", gradient_descent.intercept_)

# 使用均方误差评估模型
print("正规方程法均方误差:", mean_squared_error(y_test, normal_equation.predict(x_test)))
print("随机梯度下降法均方误差:", mean_squared_error(y_test, gradient_descent.predict(x_test)))
第六章 逻辑回归
基本介绍
逻辑回归(Logistic Regression)是一种用于二分类的线性模型。虽然名字中有“回归”,但逻辑回归解决的是分类问题:根据输入特征预测样本属于正类($ y=1 $)或负类($ y=0 $)的概率,再根据概率或阈值得到类别标签。
逻辑回归通过将线性回归的输出映射到 $ [0,1] $ 区间,来表示某个类别的概率。
常用的映射函数是 sigmoid 函数:
$ f(x) = \frac{1}{1+e^{-x}} $
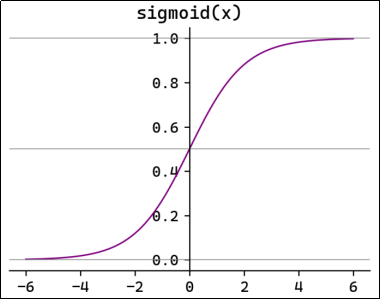
其导数为 $ f'(x) = f(x)(1-f(x)) $。
为什么用 Sigmoid?
线性回归的预测 $ z = \beta^T \boldsymbol{x} $ 是实数,无界,不能直接表示概率(概率需在 $ [0,1] $)。因此对 $ z $ 做单调、有界的变换,使其落在 $ (0,1) $,常用Sigmoid 函数:
$ \sigma(z) = \frac{1}{1 + e^{-z}} = \frac{e^z}{1 + e^z} $
性质:
- $ z \to +\infty $ 时 $ \sigma(z) \to 1 $,$ z \to -\infty $ 时 $ \sigma(z) \to 0 $,$ z=0 $ 时 $ \sigma(0) = \frac{1}{2} $
- 导数:$ \sigma'(z) = \sigma(z)(1 - \sigma(z)) $
导数推导:
$ \frac{d}{dz}\sigma(z) = \frac{d}{dz}\frac{1}{1+e^{-z}} = \frac{e^{-z}}{(1+e^{-z})^2} = \sigma(z) \cdot (1 - \sigma(z)) $
逻辑回归结果可表示为:
$ P(y=1|x) = \frac{1}{1+e^{-(\beta_0+\beta_1x_1+\beta_2x_2+\dots+\beta_nx_n)}} $
其中 $ \beta_0+\beta_1x_1+\beta_2x_2+\dots+\beta_nx_n $ 为线性回归输出结果,$ P(y=1|x) $ 表示输出为 1 类的概率。根据逻辑回归结果和阈值来确认最终预测结果,若逻辑回归结果大于阈值则输出为 1 类,反之输出为 0 类。
计算示例:
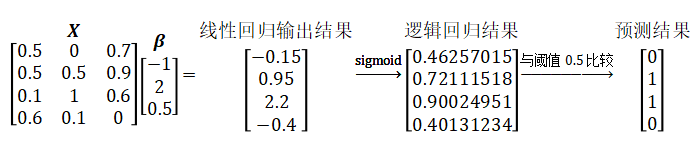
与线性回归的区别:
- 任务:线性回归做回归(预测连续值),逻辑回归做分类(预测类别或概率)。
- 输出:线性回归输出 $ y = \beta^T \boldsymbol{x} $,范围为全体实数;逻辑回归输出 $ P(y=1|\boldsymbol{x}) = \sigma(\beta^T \boldsymbol{x}) $,范围为 $ (0,1) $。
- 损失函数:线性回归常用均方误差(MSE);逻辑回归常用交叉熵 / 对数似然损失。
逻辑回归应用场景:
- 信用评分: 预测客户是否会违约(违约/不违约)。
- 欺诈检测: 预测某笔交易是否是欺诈行为。
- 垃圾邮件检测: 预测一封邮件是否是垃圾邮件(垃圾邮件/非垃圾邮件)。
- 广告点击预测: 预测用户是否会点击某个广告(点击/不点击)。
- 图像分类: 将图像分类为不同的类别(如猫、狗、鸟等)。
- 情感分析: 将文本分类为正面、负面或中性情感。
- 产品质量分类: 预测产品是否合格。
- 医学诊断: 预测患者是否患有某种疾病(患病/未患病)。
- 蛋白质功能预测: 基于蛋白质序列和结构特征预测其功能类别。
损失函数
逻辑回归的损失函数通常使用对数损失(Log Loss),也称为二元交叉熵损失(Binary Cross-Entropy Loss),用于衡量模型输出的概率分布与真实标签之间的差距。逻辑回归的损失函数来源于极大似然估计(MLE)。
$ P(Y|X;\beta) $ 表示给定输入特征 $ x $ 和模型参数 $ \beta $ 时,因变量 $ y $ 发生的概率:
$ P(y=1|x;\beta) = \frac{1}{1+e^{-\beta^Tx}} $
$ P(y=0|x;\beta) = 1 - P(y=1|x;\beta) = 1 - \frac{1}{1+e^{-\beta^Tx}} $
整合 $ P(y|x;\beta) $:
$ P(y|x;\beta) = P(y=1|x;\beta)^y (1-P(y=1|x;\beta))^{1-y} $
$ y $ 与 $ 1-y $ 的次方存在的意义
利用 $ y $ 仅取 0 或 1 的离散特性,同一式子在两种取值下自动对应正确概率:
- 当 $ y=1 $ 时:第一项指数为 $ y=1 $,第二项指数为 $ 1-y=0 $。约定 $ 0^0=1 $,则第二项为 $ (1-p)^0=1 $,式子即为 $ P(y=1 \mid \boldsymbol{x} ; \boldsymbol{\beta}) $。
- 当 $ y=0 $ 时:第一项指数为 $ y=0 $,即 $ p^0=1 $;第二项指数为 $ 1-y=1 $,式子即为 $ 1 - P(y=1 \mid \boldsymbol{x} ; \boldsymbol{\beta}) = P(y=0 \mid \boldsymbol{x} ; \boldsymbol{\beta}) $。
似然函数 $ L(\beta) $ 表示已知 $ y $ 的结果,此时模型参数为 $ \beta $ 的概率:
- 对于 1 个样本:
$ L(\beta) = P(y|x;\beta) = P(y=1|x;\beta)^y (1-P(y=1|x;\beta))^{1-y} $
- 对于 n 个样本:
$ L(\beta) = \prod_{i=1}^n P(y_i|x_i;\beta) = \prod_{i=1}^n P(y_i=1|x_i;\beta)^{y_i} (1-P(y_i=1|x_i;\beta))^{1-y_i} $
取对数似然:
$ \log L(\beta) = \sum_{i=1}^n \left[ y_i \log P(y_i=1|x_i;\beta) + (1-y_i) \log (1-P(y_i=1|x_i;\beta)) \right] $
拟合的过程就是求解似然函数的最大值,为了方便优化,令损失函数为负的平均对数似然:
$ Loss = -\frac{1}{n} \log L(\beta) = -\frac{1}{n} \sum_{i=1}^n \left[ y_i \log P(y_i=1|x_i;\beta) + (1-y_i) \log (1-P(y_i=1|x_i;\beta)) \right] $
通过求解损失函数的最小值来优化模型。
损失梯度:
$ Loss = -\frac{1}{n} \sum_{i=1}^n \left[ y_i \log P(y_i=1|x_i;\beta) + (1-y_i) \log (1-P(y_i=1|x_i;\beta)) \right] = -\frac{1}{n} [y^T \log p + (1-y)^T \log (1-p)] $
其中:
- $ y = [y_1, y_2, \dots, y_n]^T $
- $ p = [P(y_1=1|x_1;\beta), P(y_2=1|x_2;\beta), \dots, P(y_n=1|x_n;\beta)]^T = [\frac{1}{1+e^{-\beta^Tx_1}}, \dots, \frac{1}{1+e^{-\beta^Tx_n}}]^T = \frac{1}{1+e^{-X\beta}} $
则梯度为:
$ \nabla Loss = \frac{\partial Loss}{\partial p} \cdot \frac{\partial p}{\partial \beta}
(链式过程:\beta会影响概率p,p会影响似然结果) $
$ = \frac{\partial [-\frac{1}{n} (y^T \log p + (1-y)^T \log (1-p))]}{\partial p} \cdot \frac{\partial (\frac{1}{1+e^{-X\beta}})}{\partial \beta} $
$ = -\frac{1}{n} (\frac{y}{p} - \frac{1-y}{1-p}) \cdot p \odot (1-p) \cdot X^T $
$ = \frac{1}{n} X^T (p-y) $
$ = \frac{1}{n} X^T (\frac{1}{1+e^{-X\beta}} - y) $
其中 $ \odot $ 表示 Hadamard 乘积(逐项乘积)。
API 使用
scikit-learn 中的 LogisticRegression 类用于实现逻辑回归。它支持二分类和多分类任务,并提供了多种优化算法和正则化选项。
相关参数说明:
# solver: 优化算法
#   lbfgs: 拟牛顿法(默认),仅支持 L2 正则化
#   newton-cg: 牛顿法,仅支持 L2 正则化
#   liblinear: 坐标下降法,适用于小数据集,支持 L1 和 L2 正则化
#   sag: 随机平均梯度下降,适用于大规模数据集,仅支持 L2 正则化
#   saga: 改进的随机梯度下降,适用于大规模数据,支持 L1、L2 和 ElasticNet 正则化
# penalty: 正则化类型,可选 l1、l2 和 elasticnet
# C: 正则化强度,C 越小,正则化强度越大
# class_weight: 类别权重,balanced 表示自动平衡类别权重,让模型在训练时更关注少数类,从而减少类别不平衡带来的偏差

model = sklearn.linear_model.LogisticRegression(solver="lbfgs", penalty="l2", C=1, class_weight="balanced")
案例:心脏病预测
数据集:Heart Disease Dataset。包含以下特征 :
- 年龄:连续值
- 性别:0-女,1-男
- 胸痛类型:0-典型心绞痛,1-非典型心绞痛,2-非心绞痛,3-无症状
- 静息血压:连续值,单位 mmHg
- 胆固醇:连续值,单位 mg/dl
- 空腹血糖:1-大于 120mg/dl,0-小于等于 120mg/dl
- 静息心电图结果:0-正常,1-ST-T 异常,2-可能左心室肥大
- 最大心率:连续值
- 运动性心绞痛:1-有,0-无
- 运动后的 ST 下降:连续值
- 峰值 ST 段的斜率:0-向上,1-水平,2-向下
- 主血管数量:0 到 3
- 地中海贫血:一种先天性贫血,0-正常,1-固定缺陷,2-可逆缺陷
- 是否患有心脏病:标签,0-否,1-是
代码实现:
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler, OneHotEncoder
from sklearn.compose import ColumnTransformer
from sklearn.linear_model import LogisticRegression

# 加载数据集
heart_disease = pd.read_csv("data/heart_disease.csv") [cite: 1224]
heart_disease.dropna() [cite: 1225]

# 划分为训练集与测试集
X = heart_disease.drop("是否患有心脏病", axis=1)  # 特征 [cite: 1227]
y = heart_disease["是否患有心脏病"]  # 标签 [cite: 1228]
x_train, x_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=100) [cite: 1229]

# 特征工程 [cite: 1230]
# 数值型特征
numerical_features = ["年龄", "静息血压", "胆固醇", "最大心率", "运动后的ST下降", "主血管数量"] [cite: 1232]
# 类别型特征
categorical_features = ["胸痛类型", "静息心电图结果", "峰值ST段的斜率", "地中海贫血"] [cite: 1234]
# 二元特征
binary_features = ["性别", "空腹血糖", "运动性心绞痛"] [cite: 1236]

# 创建列转换器
preprocessor = ColumnTransformer(
    transformers=[
        # 对数值型特征进行标准化
        ("num", StandardScaler(), numerical_features), [cite: 1241]
        # 对类别型特征进行独热编码,使用 drop="first" 避免多重共线性
        ("cat", OneHotEncoder(drop="first"), categorical_features), [cite: 1243]
        # 二元特征不进行处理
        ("binary", "passthrough", binary_features), [cite: 1245]
    ]
) [cite: 1238]

# 执行特征转换
x_train = preprocessor.fit_transform(x_train)  # 计算训练集的统计信息并进行转换 [cite: 1249]
x_test = preprocessor.transform(x_test)  # 使用训练集计算的信息对测试集进行转换 [cite: 1250]

# 模型训练
model = LogisticRegression() [cite: 1252]
model.fit(x_train, y_train) [cite: 1253]

# 模型评估,计算准确率
model.score(x_test, y_test) [cite: 1255]
多分类任务
逻辑回归通常用于二分类问题,但可以通过一对多(One-vs-Rest,OvR)以及Softmax 回归(Multinomial Logistic Regression,多项逻辑回归)来扩展到多分类任务。
一对多 (OVR - One-vs-Rest)
若有 C 个类别,则训练 C 个二分类逻辑回归分类器。每个分类器将一个类别作为正例,所有其他类别作为反例。预测时,计算 C 个分类器的输出概率,选取概率最高的类别。
对于类别 c 的概率公式:
$ P(y = c|x; \beta) = \frac{1}{1 + e^{-(\beta^T x)}} $
损失函数 (Loss Function):
$ Loss = -\frac{1}{n} \sum_{i=1}^{n} (y_i \log P(y_i = c|x_i; \beta) + (1 - y_i) \log(1 - P(y_i = c|x_i; \beta))) $
优缺点:
- 优点: 简单易于实现,适用于类别数量较少的情况。
- 缺点: 每个类别训练 1 个分类器,当类别数量较多时,训练时间较长。
API 使用:
from sklearn.linear_model import LogisticRegression

model = LogisticRegression(multi_class="ovr")
# 或
from sklearn.multiclass import OneVsRestClassifier

model = OneVsRestClassifier(LogisticRegression())
Softmax 回归 (多项逻辑回归)
直接扩展逻辑回归到多分类问题,使用 Softmax 函数将模型输出转化为概率分布。
只需训练 1 个逻辑回归模型。预测时用 1 个模型计算所有类别的概率,选择最大值。若有 C 个类别,模型将输出 C 个分数。
对于类别 c 的概率公式:
$ P(y = c|x) = \frac{e^{\beta_c^T x}}{\sum_{j=1}^{C} e^{\beta_j^T x}} $
损失函数 (Loss Function):
$ Loss = -\frac{1}{n} \sum_{i=1}^{n} \sum_{c=1}^{C} I(y_i = c) \log P(y_i = c|x_i) $
其中 I(y_i = c) 为示性函数,当 y_i = c 时值为 1,反之值为 0。
优缺点:
- 优点: 只训练 1 个模型,计算高效,分类一致性更好。
- 缺点: 计算 Softmax 需要对所有类别求指数,计算量较高。
API 使用:
from sklearn.linear_model import LogisticRegression

model = LogisticRegression(multi_class="multinomial")
# 对于多分类问题,LogisticRegression 会自动使用 multinomial,因此 multi_class
# 参数可省略
model = LogisticRegression()
案例:手写数字识别
Digit Recognizer 数据集:Digit Recognizer。
(原文档附带的附件请到语雀源文档查看)
文件中包含手绘数字(从 0 到 9)的灰度图像,每张图像为 28×28 像素,共 784 像素。每个像素有一个 0 到 255 的值表示该像素的亮度。
文件第 1 列为标签,之后 784 列分别为 784 个像素的亮度值。
第 x*28+y 个像素表示图像第 x 行第 y 列的像素。
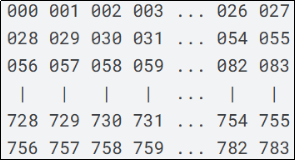
数据查看:
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import MinMaxScaler
from sklearn.linear_model import LogisticRegression

# 加载数据集
digit = pd.read_csv("/train.csv")
plt.imshow(digit.iloc[10, 1:].values.reshape(28, 28), cmap="gray")
plt.show()
逻辑回归实现手写数字识别:
import numpy as np
import matplotlib.pyplot as plt
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import MinMaxScaler
from sklearn.linear_model import LogisticRegression

# 1. 加载数据集
dataset = pd.read_csv('train.csv')

# 2. 划分数据集
X = dataset.drop('label',axis=1)  # 提取除'label'列外的所有特征列作为自变量X
y = dataset['label']  # 提取'label'列作为目标变量y
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)  # 将数据按8:2比例划分为训练集和测试集,随机种子设为42确保结果可重现

# 3. 特征工程:归一化
scaler = MinMaxScaler()  # 创建MinMaxScaler归一化对象,将特征缩放到[0,1]区间
X_train = scaler.fit_transform(X_train)  # 对训练集进行归一化拟合和转换
X_test = scaler.transform(X_test)  # 使用训练集的归一化参数对测试集进行转换

# 4. 定义和训练模型
model = LogisticRegression()
model.fit(X_train, y_train)

# 5. 模型评估
print(model.score(X_test, y_test))
第七章 感知机
基本介绍
感知机(Perceptron)是二分类模型,接收多个信号,输出一个信号。感知机的信号只有 0、1 两种取值。
下图是一个接收两个输入信号的感知机的例子:
- $ x_1 $、$ x_2 $ 是输入信号
- $ y $ 是输出信号
- $ w_1 $、$ w_2 $ 是权重
- ○ 称为神经元或节点
输入信号被送往神经元时,会分别乘以固定的权重。神经元会计算传送过来的信号的总和,只有当这个总和超过某个界限值时才会输出 1,也称之为神经元被激活。这里将界限值称之为阈值$ θ
$。
$ y = \begin{cases} 0, & w_1 x_1 + w_2 x_2\leq 0 \ 1, & w_1 x_1 + w_2 x_2 > 0 \end{cases} $
感知机的多个输入信号都有各自的权重,这些权重发挥着控制各个信号的重要性的作用,权重越大,对应信号的重要性越高。
简单逻辑电路
与门
尝试使用感知机解决简单的问题,如实现逻辑电路中的与门(AND gate)。与门是具有两个输入和一个输出的门电路,仅在两个输入均为 1 时输出 1,其他时候输出 0。这种输入信号和输出信号对应表称为真值表。
使用感知机表示与门需要确定能满足上述真值表的 $ w_1 $、$ w_2 $、$ \theta $ 的值,满足条件的参数有无数个,例如:$ (w_1,\, w_2,\, \theta) = (0.5,\, 0.5,\, 0.7) $
与非门
与非门(NAND gate)颠倒了与门的输出,仅当 $ x_1 $ 与 $ x_2 $ 同时为 1 时输出 0,其他时候输出 1。
要表示与非门,满足条件的参数也有无数个,例如:$ (w_1,\, w_2,\, \theta) = (-0.5,\, -0.5,\, -0.7) $
实际上,只要把实现与门的参数值的符号取反即可。
或门
或门(OR gate):只要有一个输入信号为 1,输出就为 1。
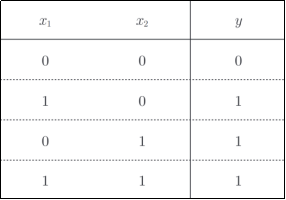
满足条件的参数例如:$ (w_1,\, w_2,\, \theta) = (0.5,\, 0.5,\, 0.2) $
感知机的实现
简单实现
实现与门:定义函数 AND 接受 $ x_1 $ 和 $ x_2 $,在函数内部初始化参数。当输入的加权总和超过阈值时返回 1,否则返回 0。
def AND(x1, x2):
    w1, w2, theta = 0.5, 0.5, 0.7
    res = x1 * w1 + x2 * w2
    if res <= theta:
        return 0
    elif res > theta:
        return 1

print(AND(0, 0))  # 0
print(AND(1, 0))  # 0
print(AND(0, 1))  # 0
print(AND(1, 1))  # 1
可以以同样的方式实现与非门和或门,不过在此之前先做一些修改。
导入权重和偏置
考虑到以后的事情,我们将其修改为另外一种实现形式。将阈值 $ \theta $ 换为偏置 $ b $,表示感知机行为的式子变为如下形式:
$ y = \begin{cases} 0, & w_1 x_1 + w_2 x_2 + b \leq 0 \ 1, & w_1 x_1 + w_2 x_2 + b > 0 \end{cases} $
其中 $ b $ 为偏置,$ w_1,\, w_2 $ 为权重。下面使用 Numpy 按上述形式分别实现与门、与非门和或门。
与门:
import numpy as np

def AND(x1, x2):
    x = np.array([x1, x2])
    w = np.array([0.5, 0.5])
    b = -0.7
    tmp = np.sum(w * x) + b
    if tmp <= 0:
        return 0
    else:
        return 1

print(AND(0, 0))  # 0
print(AND(1, 0))  # 0
print(AND(0, 1))  # 0
print(AND(1, 1))  # 1
偏置与权重的作用是不同的:权重是控制输入信号的重要性的参数,而偏置是调整神经元被激活的容易程度的参数。
与非门和或门:
import numpy as np

def NAND(x1, x2):
    x = np.array([x1, x2])
    w = np.array([-0.5, -0.5])
    b = 0.7
    tmp = np.sum(w * x) + b
    if tmp <= 0:
        return 0
    else:
        return 1

print(NAND(0, 0))  # 1
print(NAND(1, 0))  # 1
print(NAND(0, 1))  # 1
print(NAND(1, 1))  # 0

def OR(x1, x2):
    x = np.array([x1, x2])
    w = np.array([0.5, 0.5])
    b = -0.2
    tmp = np.sum(w * x) + b
    if tmp <= 0:
        return 0
    else:
        return 1

print(OR(0, 0))  # 0
print(OR(1, 0))  # 1
print(OR(0, 1))  # 1
print(OR(1, 1))  # 1
与门、与非门、或门是具有相同构造的感知机,区别仅在于权重参数的值。因此在与非门和或门的实现中,仅设置权重和偏置的值这一点和与门的实现不同。
感知机的局限
现在来考虑一下异或门(XOR gate)。异或门仅当 $ x_1 $ 或 $ x_2 $ 中的一方为 1 时才会输出 1。
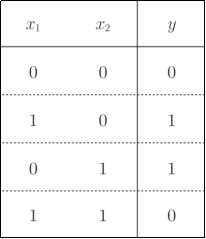
之前的感知机是无法实现这个异或门的,具体原因如下。
感知机表示或门的式子如下:
$ y = \begin{cases} 0, & w_1 x_1 + w_2 x_2 + b \leq 0 \ 1, & w_1 x_1 + w_2 x_2 + b > 0 \end{cases} $
上式表示感知机会生成由直线划分的两个空间,其中一个空间输出 1,另一个空间输出 0。
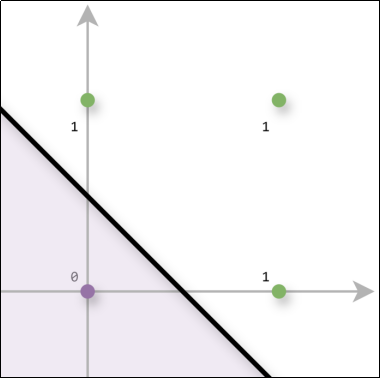
如果要实现异或门,是无法使用一条直线将 0 和 1 分开的。
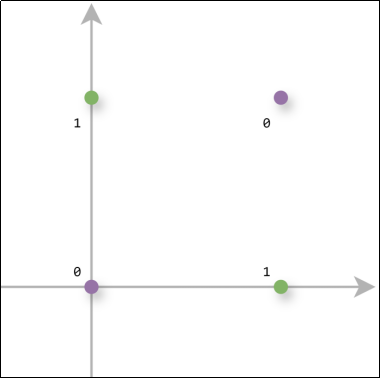
但如果将“直线”这个限制条件去掉就可以了。
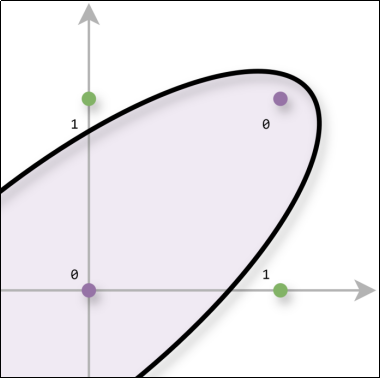
感知机的局限性就在于它只能表示由一条直线划分的空间,而由曲线划分的空间无法用(单层)感知机表示。由曲线划分的空间称为非线性空间,由直线划分的空间称为线性空间。
多层感知机
我们先来考虑一下如何使用与门、与非门和或门来组合出异或门。
与门、与非门、或门用符号表示:
将其组合可构成异或门:
真值表如下:
使用之前实现的与门、与非门和或门代码来实现异或门:
import numpy as np

def AND(x1, x2):
    x = np.array([x1, x2])
    w = np.array([0.5, 0.5])
    b = -0.7
    tmp = np.sum(w * x) + b
    if tmp <= 0:
        return 0
    else:
        return 1

def NAND(x1, x2):
    x = np.array([x1, x2])
    w = np.array([-0.5, -0.5])
    b = 0.7
    tmp = np.sum(w * x) + b
    if tmp <= 0:
        return 0
    else:
        return 1

def OR(x1, x2):
    x = np.array([x1, x2])
    w = np.array([0.5, 0.5])
    b = -0.2
    tmp = np.sum(w * x) + b
    if tmp <= 0:
        return 0
    else:
        return 1

def XOR(x1, x2):
    s1 = NAND(x1, x2)
    s2 = OR(x1, x2)
    y = AND(s1, s2)
    return y

print(XOR(0, 0))  # 0
print(XOR(1, 0))  # 1
print(XOR(0, 1))  # 1
print(XOR(1, 1))  # 0
用感知机的表示方法来表示这个异或门,可以得到一种多层感知机结构:
- 第 0 层的两个神经元接收输入信号,并将信号发送给第 1 层的神经元。
- 第 1 层的神经元将信号发送给第 2 层的神经元。
- 第 2 层的神经元输出结果。
通过叠加层,感知机能进行更加灵活的表示。
第八章 其他监督学习算法
朴素贝叶斯法
基本介绍
朴素贝叶斯(naive Bayes)法是一种基于概率的机器学习算法。它基于贝叶斯定理,并假设特征之间相互独立(这就是「朴素」的来源)。朴素贝叶斯法实现简单,学习与预测的效率都很高,是一种常用方法,在许多场景下表现得非常好,如文本分类(垃圾邮件检测)、情感分析等。
朴素贝叶斯法的核心是贝叶斯定理:
$ P(Y|X) = \frac{P(X|Y) P(Y)}{P(X)} $
含义:后验概率 = 似然 × 先验 / 证据。在观察到特征 $ X $ 后,用该式更新类别 $ Y $ 的概率,是贝叶斯分类的核心。
- $ P(Y|X) $:后验概率,给定特征 $ X $ 时类 $ Y $ 的概率。
- $ P(X|Y) $:条件概率,类 $ Y $ 包含特征 $ X $ 的概率(似然)。
- $ P(Y) $:先验概率,类 $ Y $ 的概率。
- $ P(X) $:特征 $ X $ 的概率(证据)。
例如,判断一封邮件是不是垃圾邮件($ Y= $ 垃圾邮件,$ X= $ 邮件内包含「免费」这个词):
- $ P(Y|X) $:邮件包含「免费」时是垃圾邮件的概率。
- $ P(X|Y) $:垃圾邮件中包含「免费」的概率。
- $ P(Y) $:邮件是垃圾邮件的概率。
- $ P(X) $:邮件包含「免费」的概率。
朴素贝叶斯假设所有特征相互独立,这使得我们无需考虑特征之间复杂的依赖关系,极大简化了条件概率的计算:
$ P(X|Y) = P(x_1,x_2,\ldots,x_n|Y) = \prod_{j=1}^{n} P(x_j|Y) $
朴素假设下,类 $ Y $ 条件下各特征相互独立,联合概率等于各特征条件概率的乘积,从而避免估计高维联合分布。
极大似然估计
在朴素贝叶斯法中,学习意味着估计先验概率和条件概率。可以应用极大似然估计法估计相应的概率。
先验概率 $ P(Y=c_k) $($ c_k $ 为第 $ k $ 个类)的极大似然估计:
$ P(Y=c_k) = \frac{\sum_{i=1}^{N} I(y_i = c_k)}{N} $
含义:类 $ c_k $ 的先验概率用训练集中属于该类样本数占总数 $ N $ 的比例来估计(极大似然)。
条件概率 $ P(X^{(j)}=a_{jl}|Y=c_k) $($ Y $ 为类 $ c_k $ 时第 $ j $ 个特征取值为 $ a_{jl} $)的极大似然估计:
$ P(X^{(j)}=a_{jl}|Y=c_k) = \frac{\sum_{i=1}^{N} I(x_i^{(j)}=a_{jl},\, y_i=c_k)}{\sum_{i=1}^{N} I(y_i=c_k)} $
含义:在类 $ c_k $ 中,第 $ j $ 个特征取值为 $ a_{jl} $ 的条件概率 = 该类中满足该取值的样本数 / 该类总样本数(极大似然)。
其中 $ I(\cdot) $ 为示性函数,取值为 1 或 0。
贝叶斯估计
使用极大似然估计可能会出现所要估计的概率值为 0 的情况,这会影响到后验概率的计算结果,使分类产生偏差。解决方法是改用贝叶斯估计。
先验概率的贝叶斯估计:
$ P_\lambda(Y=c_k) = \frac{\sum_{i=1}^{N} I(y_i=c_k) + \lambda}{N + K\lambda} $
含义:先验的贝叶斯估计在分子、分母加入平滑项 $ \lambda $,避免概率为 0;$ \lambda=1 $ 时为拉普拉斯平滑,$ K $ 为类别数。
条件概率的贝叶斯估计:
$ P_\lambda(X^{(j)}=a_{jl}|Y=c_k) = \frac{\sum_{i=1}^{N} I(x_i^{(j)}=a_{jl},\, y_i=c_k) + \lambda}{\sum_{i=1}^{N} I(y_i=c_k) + S_j \lambda} $
含义:条件概率的贝叶斯估计在分子、分母各加 $ \lambda $,避免某特征取值在某类中未出现导致概率为 0;$ S_j $ 为第 $ j $ 个特征的可能取值个数。
式中,当 $ \lambda=0 $ 时就是极大似然估计,常取 $ \lambda=1 $,这时称为拉普拉斯平滑($ K $ 为类别数,$ S_j $ 为第 $ j $ 个特征的可能取值个数)。
学习与分类过程
学习时,计算先验概率:
$ P(Y=c_k) = \frac{\sum_{i=1}^{N} I(y_i=c_k)}{N}, \quad k=1,2,\ldots,K $
含义:学习阶段对每个类别 $ c_k $ 用训练集统计其先验概率(该类样本数 / 总样本数)。
和条件概率:
$ P(X^{(j)}=a_{jl}|Y=c_k) = \frac{\sum_{i=1}^{N} I(x_i^{(j)}=a_{jl},\, y_i=c_k)}{\sum_{i=1}^{N} I(y_i=c_k)} $
含义:学习阶段对每个类、每个特征的每个取值统计条件概率(类内该取值样本数 / 类内样本数)。
分类时,根据给定的实例 $ \boldsymbol{x}=(x^{(1)},x^{(2)},\ldots,x^{(n)})^T $ 计算后验概率:
$ P(Y=c_k|X=\boldsymbol{x}) = \frac{P(X=\boldsymbol{x}|Y=c_k)P(Y=c_k)}{\sum_{k} P(X=\boldsymbol{x}|Y=c_k)P(Y=c_k)} = \frac{\prod_{j} P(X^{(j)}=x^{(j)}|Y=c_k)\, P(Y=c_k)}{\sum_{k} \prod_{j} P(X^{(j)}=x^{(j)}|Y=c_k)\, P(Y=c_k)} $
含义:给定实例 $ \boldsymbol{x} $ 属于类 $ c_k $ 的后验概率;第二式由贝叶斯公式与朴素假设(特征条件独立)将 $ P(X=\boldsymbol{x}|Y=c_k) $ 写成各 $ P(X^{(j)}=x^{(j)}|Y=c_k) $ 的乘积。
并确定实例属于哪一个类别:
$ y = \arg\max_{c_k} P(Y=c_k) \prod_{j=1}^{n} P(X^{(j)}=x^{(j)}|Y=c_k) $
含义:分类决策:选择使后验概率(先验 × 各特征条件概率的乘积)最大的类别 $ c_k $ 作为预测标签。
决策树
基本介绍
决策树(Decision Tree)是一种基于树形结构的算法,根据一系列条件判断逐步划分数据,缩小范围,最终得出预测结果。决策树由 4 部分组成:
- 根节点:树的起点,包含所有数据。
- 内部节点:表示特征上的判断条件。
- 分支:根据判断条件分出的路径。
- 叶节点:最终分类或回归的结果。
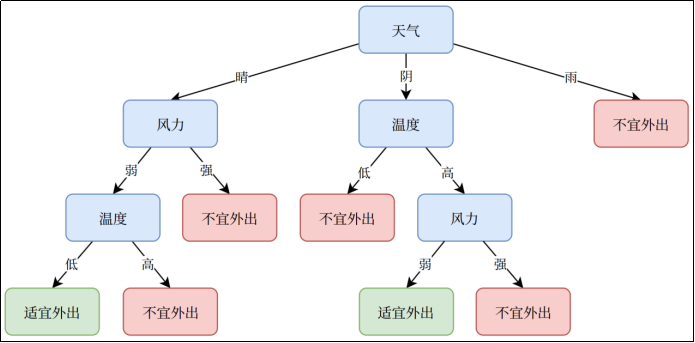
决策树适用于需要规则化、可解释性和快速决策的场景,尤其在数据特征明确、样本量适中的情况下表现良好。在复杂任务中,它常作为基础模型,与集成学习结合(如随机森林、梯度提升树)以提升性能。
决策树工作过程
决策树的学习通常包括 3 个步骤:特征选择、决策树的生成和决策树的剪枝。
如果特征数量很多,可以在决策树学习之前对特征进行选择,只留下对训练数据有足够分类能力的特征。
学习时通常是递归地选择最优特征,并根据该特征对训练数据进行划分,使得对各个子数据集有一个最好的分类。
- 首先构建根结点,将所有训练数据都放在根结点。
- 选择一个最优特征,按照这一特征将训练数据集划分成子集,使得各个子集有一个在当前条件下最好的分类。
- 如果这些子集已经能够被基本正确分类,那么构建叶结点,并将这些子集分到所对应的叶结点中去;如果还有子集不能被基本正确分类,那么就对这些子集选择新的最优特征,继续对其进行划分并构建相应的结点。
- 如此递归直至所有训练数据子集被基本正确分类,或者没有合适的特征为止。
最后每个子集都被分到叶结点上,即都有了明确的类,这就生成了一棵决策树。决策树的每次划分都相当于在特征空间中引入一个超平面将当前空间一分为二。
以上方法生成的决策树可能对训练数据有很好的分类能力,但对未知的测试数据却未必,即可能发生过拟合现象。因此需要对已生成的树自下而上进行剪枝,将树变得更简单,从而使它具有更好的泛化能力。具体地,就是去掉过于细分的叶结点,使其回退到父结点或更高的结点,然后将父结点或更高的结点改为新的叶结点。
决策树的生成只考虑局部最优,决策树的剪枝则考虑全局最优。
特征选择与决策树生成
特征选择在于选取对训练数据具有分类能力的特征,这样可以提高决策树学习的效率。如果利用一个特征进行分类的结果与随机分类的结果没有很大差别,则称这个特征是没有分类能力的,经验上扔掉这样的特征对决策树学习的精度影响不大。通常特征选择的准则是信息增益或信息增益率。
常见的决策树生成算法:
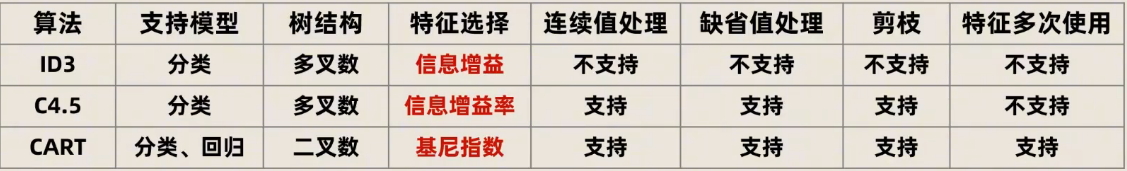
信息熵
信息熵(Entropy)是表示随机变量不确定性的度量。设 $ X $ 是一个取有限个值的离散随机变量,其概率分布为:
$ P(X=x_i)=p_i, \quad i=1,2,\ldots,n $
随机变量 $ X $ 的熵定义为:
$ H(X) = -\sum_{i=1}^{n} p_i \log p_i $
含义:信息熵度量随机变量 $ X $ 的不确定性;分布越均匀熵越大,越集中熵越小,单位为比特($ \log_2 $)或奈特($ \ln $)。
若 $ p_i=0 $,则定义 $ 0\log 0 = 0 $。通常式中对数以 2 或 $ e $ 为底。
在 $ P(X=x_i)=p_i,\ i=1,2,\ldots,n $ 的情况下,假设 $ X $ 的概率分布为 $ p_i \geq 0,\ \sum_{i=1}^{n} p_i = 1 $,则 $ X $ 的信息熵为:
$ H(X) = -\sum_{i=1}^{n} p_i \log p_i $
熵只依赖于 $ X $ 的分布,与 $ X $ 的取值无关。熵越大,随机变量的不确定性就越大。
设有随机变量 $ (X,Y) $,其联合概率分布为:
$ P(X=x_i,\, Y=y_j)=p_{ij}, \quad i=1,2,\ldots,n;\ j=1,2,\ldots,m $
含义:$ (X,Y) $ 的联合分布;$ p_{ij} $ 为 $ X=x_i $ 且 $ Y=y_j $ 的概率。
条件熵表示在已知随机变量 $ X $ 的条件下随机变量 $ Y $ 的不确定性:
$ H(Y|X) = \sum_{i=1}^{n} P(X=x_i) H(Y|X=x_i) = -\sum_{i=1}^{n} \sum_{j=1}^{m} p_{ij} \log \frac{p_{ij}}{p_i} $
含义:在已知 $ X $ 的条件下 $ Y $ 的平均不确定性;对 $ X $ 的每个取值先算 $ Y $ 的熵再按 $ P(X) $ 加权平均。
其中 $ p_i = P(X=x_i) $。
信息增益与 ID3
决策树学习应用信息增益(Information Gain)准则选择特征。给定训练集 $ D $ 和特征 $ A $,熵 $ H(D) $ 表示对数据集 $ D $ 进行分类的不确定性,条件熵 $ H(D|A) $ 表示在特征 $ A $ 给定条件下对数据集 $ D $ 进行分类的不确定性。两者之差即信息增益:
$ g(D,A) = H(D) - H(D|A) $
含义:用特征 $ A $ 划分后,分类不确定性的减少量;信息增益越大,该特征对分类越有用,ID3 据此选特征。
表示由于特征 $ A $ 而使得对数据集 $ D $ 的分类的不确定性减少的程度。对数据集 $ D $ 而言,信息增益依赖于特征 $ A $,不同的特征具有不同的信息增益,信息增益大的特征具有更强的分类能力。在进行特征选择时,对训练数据集计算每个特征的信息增益,并比较它们的大小,选择信息增益最大的特征。
假设:
- 训练数据集 $ D $ 有 $ |D| $ 个样本;
- 特征 $ A $ 有 $ n $ 个不同的取值 $ {a_1,a_2,\ldots,a_n} $,根据特征 $ A $ 将 $ D $ 划分为 $ n $ 个子集 $ D_1,D_2,\ldots,D_n $,$ |D_i| $ 为 $ D_i $ 的样本个数;
- 有 $ K $ 个类 $ C_k $,每个类 $ C_k $ 的样本数为 $ |C_k| $;
- 子集 $ D_i $ 中属于类 $ C_k $ 的样本的集合为 $ D_{ik} $,$ |D_{ik}| $ 为 $ D_{ik} $ 的样本个数。
信息增益计算方法如下:
- 计算数据集 $ D $ 的熵:
$ H(D) = -\sum_{k=1}^{K} \frac{|C_k|}{|D|} \log_2 \frac{|C_k|}{|D|} $
含义:数据集 $ D $ 按类别分布的信息熵;$ |C_k|/|D| $ 为类 $ C_k $ 在 $ D $ 中的比例,熵越大类别越均衡、越难分。
- 计算特征 $ A $ 对数据集 $ D $ 的条件熵:
$ H(D|A) = \sum_{i=1}^{n} \frac{|D_i|}{|D|} H(D_i) = -\sum_{i=1}^{n} \frac{|D_i|}{|D|} \sum_{k=1}^{K} \frac{|D_{ik}|}{|D_i|} \log_2 \frac{|D_{ik}|}{|D_i|} $
含义:在特征 $ A $ 取值已知后,$ D $ 按 $ A $ 划分成 $ D_1,\ldots,D_n $,条件熵为各子集熵按样本比例 $ |D_i|/|D| $ 的加权平均。
- 计算信息增益:
$ g(D,A) = H(D) - H(D|A) $
含义:信息增益 = 划分前熵 − 划分后条件熵,选使 $ g(D,A) $ 最大的特征 $ A $ 作为当前节点划分依据。
ID3 算法在决策树各个节点上应用信息增益选择特征,递归地构建决策树。具体方法是:从根节点开始,计算所有可能的信息增益,选择信息增益最大的特征作为节点特征,由该特征的不同取值建立子节点,再依次对子节点进行上述操作,直到所有特征信息增益均很小或无特征可选为止,最终生成一棵决策树。
信息增益率与 C4.5
使用信息增益划分训练数据集的特征,会倾向于选择取值较多的特征。而使用信息增益率(Information Gain Ratio)可以对这一问题进行校正,这是特征选择的另一个准则。
特征 $ A $ 对训练数据集 $ D $ 的信息增益率定义为信息增益与训练数据集 $ D $ 关于特征 $ A $ 的值的熵之比:
$ g_R(D,A) = \frac{g(D,A)}{H_A(D)}, \quad H_A(D) = -\sum_{i=1}^{n} \frac{|D_i|}{|D|} \log_2 \frac{|D_i|}{|D|} $
含义:信息增益率 = 信息增益 / 特征 $ A $ 的熵;$ H_A(D) $ 为按 $ A $ 取值划分的熵,可抑制取值很多的特征被过度偏好,C4.5 用其选特征。
其中 $ n $ 是特征 $ A $ 的取值个数。
C4.5 算法与 ID3 算法相似,但对其进行了改进,使用信息增益率来选择特征。
基尼指数与 CART
基尼指数表示集合的不确定性,基尼指数越大样本集合的不确定性也越大,这与信息熵相似。
有 $ K $ 个类,样本属于第 $ k $ 类的概率为 $ p_k $,则概率分布的基尼指数:
$ \operatorname{Gini}(p) = \sum_{k=1}^{K} p_k(1-p_k) = 1 - \sum_{k=1}^{K} p_k^2 $
含义:概率分布 $ p $ 的基尼指数,与熵类似地度量不确定性;基尼越大越不纯,CART 分类树用其选划分特征与切分点。
对于给定的样本集合 $ D $,其基尼指数:
$ \operatorname{Gini}(D) = 1 - \sum_{k=1}^{K} \left( \frac{|C_k|}{|D|} \right)^2 $
含义:样本集 $ D $ 的基尼指数,用类别比例 $ |C_k|/|D| $ 代入上式;$ D $ 越纯(某一类占主导)基尼越小。
这里 $ C_k $ 是 $ D $ 中属于第 $ k $ 类的样本子集,$ K $ 是类的个数。
如果样本集合 $ D $ 根据特征 $ A $ 是否取某一可能值 $ a $ 被划分为两个子集 $ D_1 $ 和 $ D_2 $,则在特征 $ A $ 的条件下,集合 $ D $ 的基尼指数:
$ \operatorname{Gini}(D,A) = \frac{|D_1|}{|D|} \operatorname{Gini}(D_1) + \frac{|D_2|}{|D|} \operatorname{Gini}(D_2) $
含义:按特征 $ A $ 的某切分点将 $ D $ 分为 $ D_1 $、$ D_2 $ 后,加权基尼指数;CART 选使 $ \operatorname{Gini}(D,A) $ 最小的特征与切分点。
CART 决策树是一棵二叉树,根据基尼指数生成决策树:
对训练数据集 $ D $ 的每个特征 $ A $ 的每一个可能的取值 $ a $,计算 $ A=a $ 时的基尼指数,选择基尼指数最小的特征及其对应的切分点作为最优特征与最优切分点,并生成两个子节点,将训练数据集依特征分配到两个子节点中。重复上述过程,直到节点中样本数小于阈值、或样本集的基尼指数小于阈值、或没有更多特征。
CART 回归树
一棵回归树对应着输入空间(特征空间)的划分,以及在划分上的输出值。
在训练数据集所在的空间中,递归地将每个区域划分为两个子区域并决定每个子区域上的输出值,构建二叉决策树。每次划分的目标是找到一个特征 $ j $ 和该特征的一个切分点 $ s $,使得划分后的误差最小。在对输入空间进行划分时,将特征 $ j $ 和它的取值 $ s $(通常是连续特征取值的中间点)作为切分变量和切分点,定义两个区域:
$ R_1(j,s) = { x | x^{(j)} \leq s }, \quad R_2(j,s) = { x | x^{(j)} > s } $
含义:按第 $ j $ 个特征与切分点 $ s $ 将输入空间划分为两个区域:$ x^{(j)}\leq s $ 与 $ x^{(j)}>s $,CART 回归树每次分裂即产生这样两个子区域。
然后寻找最优切分变量 $ j $ 和最优切分点 $ s $。具体地,使用平方误差作为损失函数,求解:
$ \min_{j,s} \left[ \min_{c_1} \sum_{x_i \in R_1(j,s)} (y_i - c_1)^2 + \min_{c_2} \sum_{x_i \in R_2(j,s)} (y_i - c_2)^2 \right] $
含义:在划分 $ (j,s) $ 下,两区域内的最优输出 $ c_1 $、$ c_2 $ 为各自样本 $ y $ 的均值;外层对 $ (j,s) $ 寻优,使两区域平方误差之和最小(最小二乘回归树)。
解出最优切分变量 $ j $ 和最优切分点 $ s $ 后,使用其划分两个区域。重复上述过程直到满足停止条件为止。最终叶节点的输出值为该区域内所有样本目标值的均值:
$ \hat{c}m = \frac{1}{N_m} \sum{x_i \in R_m} y_i $
含义:叶节点(区域 $ R_m $)的输出取该区域内所有样本目标值 $ y_i $ 的均值,使该区域上的平方误差最小。
其中 $ R_m $ 为第 $ m $ 个区域,$ N_m $ 为 $ R_m $ 上样本个数。由此生成一棵回归树,这样的回归树称之为最小二乘回归树。
决策树的剪枝
决策树出现过拟合的原因在于学习时过多地考虑如何提高对训练数据的正确分类,从而构建出过于复杂的决策树。为了避免过拟合,可以对已生成的决策树进行剪枝,从决策树上裁掉一些子树或叶节点,并将其根节点或父节点作为新的叶节点,从而简化模型。
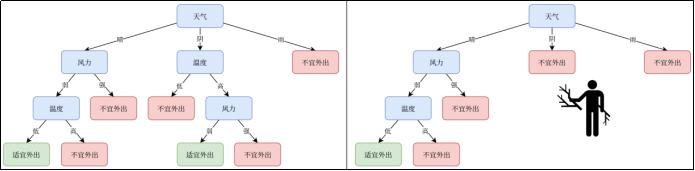
决策树的剪枝通常分为预剪枝(Pre-Pruning)和后剪枝(Post-Pruning)。
- 预剪枝:在决策树生成过程中,通过设置一些限制条件提前停止树的生长,避免过度分裂。常见的停止条件有:限制最大树深度、限制每个节点最小样本数、限制最小的误差减少量、限制最大叶节点数量等。但过于严格的停止条件可能导致欠拟合,并且可能难以确定最佳阈值,需要多次尝试。
- 后剪枝:在决策树完全生成之后,基于某种评估准则从底部向上逐步判断是否移除分支。常见的后剪枝方法有代价复杂度剪枝(Cost-Complexity Pruning,CCP)和减少误差剪枝(Reduced Error Pruning,REP)等。
支持向量机
基本介绍
支持向量机(Support Vector Machines,SVM)是一种二分类模型。其核心目标是寻找一个间隔最大且分类正确的超平面将不同类别的数据点分隔开。
这个超平面在二维空间中是一条直线,在三维空间中是一个平面,在更高维空间中则是一个超平面。
间隔最大代表该超平面与最近的数据点之间的距离最大,这使得支持向量机有较强的泛化能力。
支持向量机学习方法包括由简至繁的模型:线性可分支持向量机、线性支持向量机以及非线性支持向量机。
线性可分支持向量机(硬间隔)
当训练样本线性可分时,可以通过最大化硬间隔来学习线性可分支持向量机。硬间隔是指超平面能够将不同类的样本完全划分开。距离超平面最近的几个样本点称为支持向量,它们直接决定超平面的位置和方向,只要支持向量不变,超平面就不会变。
在样本空间中,超平面可表示为:
$ \boldsymbol{w}^T \boldsymbol{x} + b = 0 $
其中 $ \boldsymbol{w} $ 为法向量,决定了超平面的方向;$ b $ 为位移项,决定了超平面与原点之间的距离,将空间分为正负两类。将超平面记为 $ (\boldsymbol{w}, b) $。
相应的分类函数称为线性可分支持向量机:
$ f(\boldsymbol{x}) = \operatorname{sign}(\boldsymbol{w}^T \boldsymbol{x} + b) $
含义:线性可分 SVM 的分类函数:$ \boldsymbol{w}^T \boldsymbol{x} + b > 0 $ 判为正类(+1),否则为负类(-1)。
间隔与最大间隔:设 $ \boldsymbol{x}' $ 为超平面上一点,$ \boldsymbol{w}^T \boldsymbol{x}' + b = 0 $。样本空间中任一点 $ \boldsymbol{x} $ 到超平面 $ (\boldsymbol{w}, b) $ 的距离为:
$ r = \left| \frac{\boldsymbol{w}^T}{|\boldsymbol{w}|} (\boldsymbol{x} - \boldsymbol{x}') \right| = \frac{|\boldsymbol{w}^T \boldsymbol{x} + b|}{|\boldsymbol{w}|} $
含义:第一式表示距离 = 向量 $ (\boldsymbol{x} - \boldsymbol{x}') $ 在单位法向量 $ \boldsymbol{w}/|\boldsymbol{w}| $ 方向上的投影长度;由 $ \boldsymbol{w}^T \boldsymbol{x}' + b = 0 $ 得 $ \boldsymbol{w}^T(\boldsymbol{x}-\boldsymbol{x}') = \boldsymbol{w}^T \boldsymbol{x} + b $,故化简为第二式,即常用的点到超平面距离公式。
记每个样本点 $ \boldsymbol{x}_i $ 的类别为 $ y_i \in {-1,+1} $,该样本点的函数间隔 $ \hat{\gamma}_i = y_i(\boldsymbol{w}^T \boldsymbol{x}_i + b) $,表示分类预测的正确性及确信度。若超平面 $ (\boldsymbol{w}, b) $ 能将样本正确分类,则有:
$ \begin{cases}
\boldsymbol{w}^T \boldsymbol{x}_i + b > 0, & y_i = +1 \
\boldsymbol{w}^T \boldsymbol{x}_i + b < 0, & y_i = -1
\end{cases} $
含义:正确分类时,预测值 $ \boldsymbol{w}^T \boldsymbol{x}_i + b $ 的符号与真实标签 $ y_i $ 一致:正类样本在超平面正侧,负类在负侧。
缩放性质:对 $ \boldsymbol{w} $、$ b $ 进行缩放变换 $ \boldsymbol{w} \to \lambda\boldsymbol{w} $,$ b \to \lambda b $($ \lambda > 0 $)时,超平面 $ \boldsymbol{w}^T \boldsymbol{x} + b = 0 $ 不变,几何间隔 $ r_i $ 也不变,但函数间隔 $ \hat{\gamma}_i = y_i(\boldsymbol{w}^T \boldsymbol{x}_i + b) $ 会随 $ \boldsymbol{w} $、$ b $ 的缩放而改变。也就是说,可以通过缩放 $ \boldsymbol{w} $ 和 $ b $ 任意缩放函数间隔 $ \hat{\gamma}_i $,而不改变几何间隔 $ r_i $。
因此可令支持向量到超平面的函数间隔为$ \hat{\gamma}_i $= 1,此时支持向量到超平面的几何距离为 $ \gamma = 1/|\boldsymbol{w}| $。两个异类支持向量到超平面的距离之和为 $ 2/|\boldsymbol{w}| $,被称为“间隔”。
欲找到具有最大间隔的超平面,即求在约束 $ y_i(\boldsymbol{w}^T \boldsymbol{x}_i + b) \geq 1 $ 下最大化 $ 2/|\boldsymbol{w}| $,等价于:
$ \min_{\boldsymbol{w},b} \frac{1}{2} |\boldsymbol{w}|^2 \quad \text{s.t.} \quad y_i(\boldsymbol{w}^T \boldsymbol{x}_i + b) \geq 1,\ i=1,2,\ldots,N $
含义:硬间隔 SVM 的优化目标:在保证所有样本正确分类(函数间隔 ≥ 1)的前提下,最小化 $ |\boldsymbol{w}|^2/2 $,等价于最大化几何间隔 $ 2/|\boldsymbol{w}| $。s.t. 为 Subject to,意为约束。
对上式使用拉格朗日乘子法得到其对偶问题,从对偶问题中解出拉格朗日乘子,进而解出 $ \boldsymbol{w}, b $,即可得到具有最大间隔的超平面。
线性支持向量机(软间隔)
现实中训练样本往往线性不可分,无法找出一个超平面将所有样本点完全正确划分。通常训练数据中会有一些特异点,若去掉这些特异点,剩下大部分样本点是线性可分的。这时可以放宽条件,允许某些样本分错,为此引入软间隔。
线性不可分意味着某些样本点不能满足约束 $ y_i(\boldsymbol{w}^T \boldsymbol{x}_i + b) \geq 1 $。对每个样本点引进一个松弛变量 $ \xi_i \geq 0 $,使得函数间隔加上松弛变量 $ \geq 1 $,即约束条件变为:
$ y_i(\boldsymbol{w}^T \boldsymbol{x}_i + b) \geq 1 - \xi_i $
含义:软间隔约束:允许样本“越过”间隔边界,$ \xi_i \geq 0 $ 为松弛变量;$ \xi_i>0 $ 表示该样本不满足硬间隔或被误分。
同时在目标函数中引入对误分类的惩罚:
$ \frac{1}{2}|\boldsymbol{w}|^2 + C \sum_{i=1}^{N} \xi_i $
含义:软间隔目标 = 间隔正则($ |\boldsymbol{w}|^2/2 $)+ 对松弛的惩罚($ C\sum \xi_i $);$ C $ 越大越不容忍误分类,越接近硬间隔。
这里 $ C > 0 $ 为惩罚系数,值越大对误分类的惩罚越大。
线性不可分的线性支持向量机的学习问题可表示为:
$ \min_{\boldsymbol{w},b,\xi} \frac{1}{2} |\boldsymbol{w}|^2 + C \sum_{i=1}^{N} \xi_i \quad \text{s.t.} \quad y_i(\boldsymbol{w}^T \boldsymbol{x}_i + b) \geq 1 - \xi_i,\ \xi_i \geq 0,\ i=1,\ldots,N $
含义:软间隔 SVM 的完整优化问题:在允许松弛 $ \xi_i $ 的约束下,最小化正则项与误分类惩罚之和,折中“间隔尽量大”与“错分尽量少”。
这就是软间隔支持向量机。
非线性支持向量机(核函数)
非线性分类问题是指通过非线性模型才能很好地进行分类的问题。如下图是无法直接使用超平面对其分类的:
可以通过核函数(也称核技巧)将数据从原始空间映射到高维特征空间,使得数据在高维特征空间线性可分,将原本的非线性问题转换为线性问题。使用核技巧学习非线性支持向量机,等价于隐式地在高维特征空间中学习线性支持向量机。
核函数的选择是支持向量机最大的变数,若核函数选择不合适,意味着将样本映射到了一个不合适的特征空间,很可能导致性能不佳。
常用的核函数有:
- 线性核:$ K(\boldsymbol{x},\boldsymbol{z}) = \boldsymbol{x}^T \boldsymbol{z} $
- 多项式核:$ K(\boldsymbol{x},\boldsymbol{z}) = (\boldsymbol{x}^T \boldsymbol{z} + c)^d $
- 高斯径向基核(RBF):$ K(\boldsymbol{x},\boldsymbol{z}) = \exp\left(-\gamma |\boldsymbol{x} - \boldsymbol{z}|^2\right) $
- Sigmoid 核:$ K(\boldsymbol{x},\boldsymbol{z}) = \tanh(\gamma \boldsymbol{x}^T \boldsymbol{z} + c) $
集成学习
集成学习(Ensemble Learning)通过某种策略组合多个个体学习器的预测结果来提高整体的预测能力。只包含同种类型的个体学习器的集成称为同质集成(例如决策树集成中全是决策树),同质集成中的个体学习器亦称基学习器,相应的学习算法称为基学习算法。包含不同类型的个体学习器的集成称为异质集成(例如同时包含决策树和神经网络)。
集成学习有三大经典方法:Boosting、Bagging 和 Stacking。
- Boosting(提升方法):按顺序训练模型,每个模型关注前一个模型的错误,通过加权调整来优化整体预测。如 AdaBoost 通过给错分的样本更大的权重,逐步改进;梯度提升树用梯度下降法优化损失函数;XGBoost 和 LightGBM 是高效的梯度提升树变种。Boosting 主要关注于降低偏差。
- Bagging(Bootstrap Aggregating,自助聚合):从原始数据集中通过有放回抽样生成多个子数据集,分别训练多个独立模型,最后通过投票(分类)或平均(回归)得到结果。随机森林则是在 Bagging 基础上随机选择特征子集训练每棵树。Bagging 主要关注于降低方差。
- Stacking(堆叠):训练多个不同类型的个体学习器,之后使用一个元模型综合多个个体学习器的预测。灵活性强,能结合多种模型的优势。
AdaBoost
在概率近似正确学习的框架中,若存在一个多项式的学习算法能够学习某概念且正确率很高,则称该概念是强可学习的;若存在一个多项式的学习算法能够学习它但正确率仅比随机猜测略好,则称该概念是弱可学习的。可以证明,强可学习与弱可学习是等价的。Boosting 即从弱学习算法出发,反复学习得到一系列弱分类器,然后组合这些弱分类器构成一个强分类器。AdaBoost(Adaptive Boosting,自适应提升)通常使用单层决策树(决策树桩,Decision Stump)作为基学习器。
做法是:提高被前一轮弱分类器错误分类的样本的权重,降低被正确分类的样本的权重,使后一轮弱学习器更加关注未被正确分类的数据;同时采用加权多数表决,加大分类误差率小的弱分类器的权重,减小分类误差率大的弱分类器的权重。
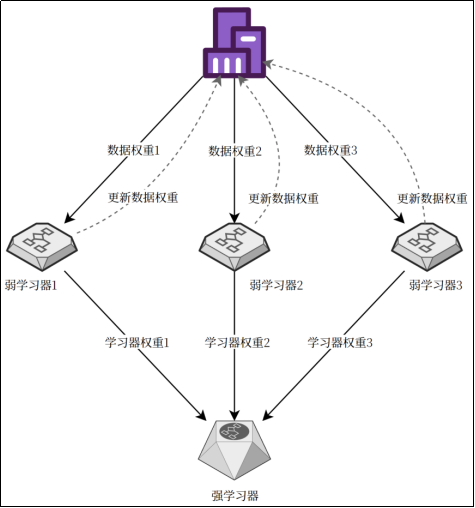
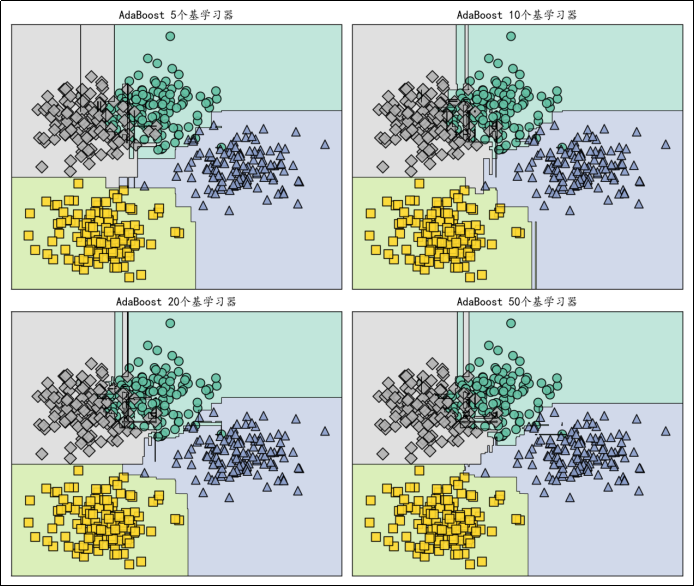
随机森林
随机森林是 Bagging 的一个变体,在以决策树为基学习器构建 Bagging 集成的基础上,在决策树训练过程中进一步引入随机属性选择。
具体来说,传统决策树在选择划分特征时是在当前节点的特征集合(假定有 $ d $ 个特征)中选择最优特征。而在随机森林中,基决策树的每个节点先从该节点的特征集合中随机选择一个包含 $ k $ 个特征的子集,然后再从这个子集中选择一个最优特征用于划分。
参数 $ k $ 控制随机性的引入程度:若 $ k=d $,则基决策树的生成与传统决策树相同;若 $ k=1 $,则随机选择一个属性用于划分。一般推荐 $ k = \log_2 d $ 或 $ k = \sqrt{d} $。
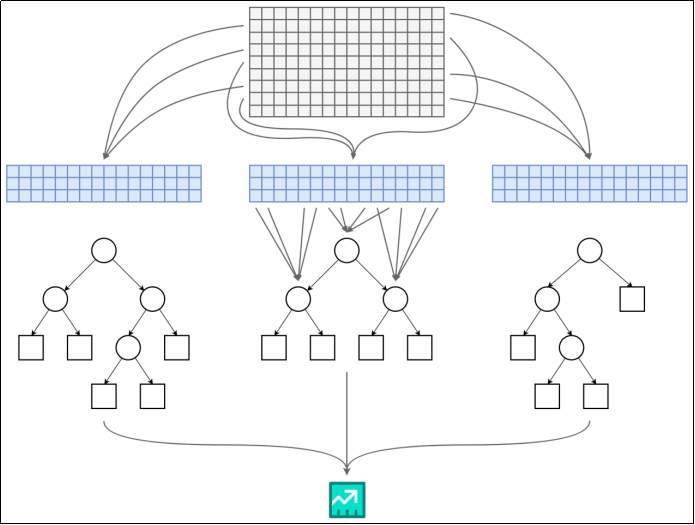
随机森林简单易实现,但在很多任务中都展现出了强大性能。Bagging 中基学习器的多样性仅来自样本扰动,而随机森林中基学习器的多样性还来自特征扰动,使得最终集成的泛化性能可通过基学习器之间差异度的增加而进一步提升。
第九章 无监督学习
聚类
基本介绍
聚类(Clustering)旨在将数据集中的样本分成若干个簇,使得同一个簇内的对象彼此相似,不同簇间的对象差异较大。聚类是一种无监督学习算法,不需要预先标记数据的标签,完全依赖数据本身内在结构和特征来进行分组,最终簇所对应的概念语义需由使用者来把握和命名。
聚类的核心是「物以类聚」,通过以下步骤实现:
- 定义相似性:选择度量标准(如欧氏距离、余弦相似度)来衡量对象之间的相似性或距离。
- 分组:根据相似性将对象分配到不同的簇中。
- 优化:通过迭代或直接计算,调整簇的划分,使簇内相似性最大化,簇间差异最大化。
聚类应用场景:
- 市场细分:将消费者按购买习惯分组。
- 图像分割:将图像像素按颜色或纹理聚类。
- 异常检测:识别不属于任何主要簇的异常点。
- 生物信息:对基因表达数据进行分组。
常见聚类算法
K 均值聚类
K 均值聚类(K-means) 是基于样本集合划分的聚类方法,将样本集合划分为 $ K $ 个子集构成 $ K $ 个簇,使每个样本到其所属簇的中心的距离最小。每个样本只能属于一个簇,因此 K 均值聚类是硬聚类。
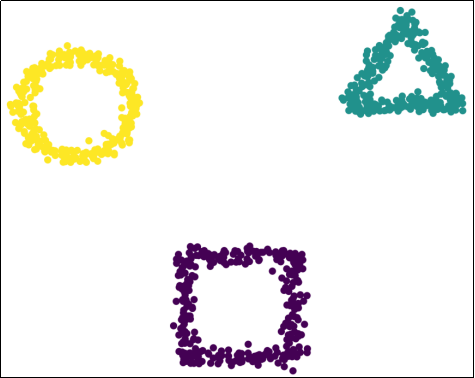
K 均值聚类归结为最小化损失函数来选取最优划分。使用欧氏距离平方作为样本之间的距离:
$ d(\boldsymbol{x}_i, \boldsymbol{x}_j) = |\boldsymbol{x}_i - \boldsymbol{x}_j|^2 $
含义:两样本间的欧氏距离平方,K-means 用其衡量样本与簇中心的接近程度;取平方便于求导与计算。
定义样本与其所属簇的中心之间的距离总和作为损失函数:
$ W(C) = \sum_{l=1}^{k} \sum_{C(i)=l} |\boldsymbol{x}_i - \boldsymbol{x}_l|^2 $
其中 $ \boldsymbol{x}_l $ 为第 $ l $ 个簇的中心,$ C(i)=l $ 表示第 $ i $ 个样本属于簇 $ l $(即按划分 $ C $ 将样本 $ i $ 归入簇 $ l $)。
等价地,用 0-1 指示变量可写成:
$ J = \sum_{i=1}^{n} \sum_{k=1}^{K} r_{ik} |\boldsymbol{x}_i - \boldsymbol{\mu}_k|^2 $
其中 $ \boldsymbol{\mu}k $ 为第 $ k $ 个簇的中心,$ r{ik} \in {0,1} $ 表示第 $ i $ 个样本是否属于簇 $ k $。
$ W(C) $(或 $ J $)表示在划分 $ C $ 下,每个样本到其所属簇中心的距离平方之和;划分越合理、簇内越紧,损失越小。
K 均值聚类就是求解最优化问题:
$ \argmin_{{r_{ik}},{\boldsymbol{\mu}k}} \sum{i=1}^{n} \sum_{k=1}^{K} r_{ik} |\boldsymbol{x}_i - \boldsymbol{\mu}_k|^2 $
K-means 的优化目标:同时优化划分 $ {r_{ik}} $ 与簇中心 $ {\boldsymbol{\mu}_k} $,使簇内距离平方和最小;实际用迭代(先固定中心分样本,再按样本更新中心)求解。
相似的样本被聚到同一个簇时损失函数最小。现实中采用迭代方法求解。
工作流程:
- 初始化:随机选择 $ K $ 个样本点作为初始簇中心。
- 对样本进行聚类:计算每个样本到各簇中心的距离,将每个样本分到与其最近的簇,构成聚类结果。
- 更新簇中心:计算每个簇中所有样本的均值,作为新的簇中心。
- 重复 2–3 直到收敛或满足停止条件(例如划分不再改变)。
特点:
- 初始中心的选择会直接影响聚类结果,且不适合非凸形状的簇。
- 需要事先指定簇个数 $ K $,实际中可尝试不同 $ K $ 并用簇的平均直径等指标评估质量;可采用肘部法确定较优的 $ K $。
层次聚类
层次聚类(Hierarchical Clustering)假设簇之间存在层次结构,将样本聚到层次化的簇中,属于硬聚类。
- 聚合聚类(自下而上):开始时每个样本各自为一个簇,之后将相距最近的两个簇合并,如此往复直至满足停止条件(如达到预设簇个数、每个簇只含一个样本、簇内相似性达到某阈值等)。
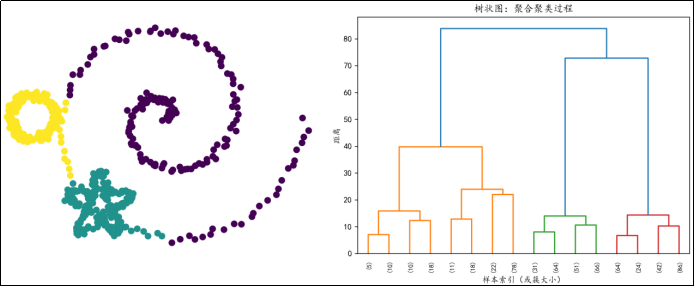
- 分裂聚类(自上而下):开始时将整个数据集视作一个簇,之后根据某种距离或相似性度量选择一个簇将其分裂成两个簇,使分裂后子簇内相似性高、子簇间差异大,如此往复直至满足停止条件。
密度聚类
密度聚类(Density-Based Clustering)假设聚类结构能通过样本分布的紧密程度确定。DBSCAN 是一种著名的密度聚类算法,基于邻域参数 $ (\epsilon, MinPts) $ 刻画样本分布的紧密程度。对于给定数据集 $ D $,定义:
- $ \epsilon $-邻域:对于 $ \boldsymbol{x}_i \in D $,其 $ \epsilon $-邻域包含 $ D $ 中与 $ \boldsymbol{x}_i $ 的距离不大于 $ \epsilon $ 的样本。
- 核心对象:若 $ \boldsymbol{x}_i $ 的 $ \epsilon $-邻域至少包含 $ MinPts $ 个对象,则 $ \boldsymbol{x}_i $ 是核心对象。
- 密度直达:若 $ \boldsymbol{x}_j $ 位于 $ \boldsymbol{x}_i $ 的 $ \epsilon $-邻域中,且 $ \boldsymbol{x}_i $ 是核心对象,则称 $ \boldsymbol{x}_j $ 由 $ \boldsymbol{x}_i $ 密度直达。
- 密度可达:若存在样本序列 $ \boldsymbol{x}_i,\ldots,\boldsymbol{x}_j $,其中相邻两者密度直达,则称 $ \boldsymbol{x}_j $ 由 $ \boldsymbol{x}_i $ 密度可达。
- 密度相连:若存在 $ \boldsymbol{x}_k $ 使得 $ \boldsymbol{x}_i $ 与 $ \boldsymbol{x}_j $ 均由 $ \boldsymbol{x}_k $ 密度可达,则称 $ \boldsymbol{x}_i $ 与 $ \boldsymbol{x}_j $ 密度相连。
- 噪声点:不属于任何簇的点(既不是核心对象,也不在任何核心对象的 $ \epsilon $-邻域内)。
示例:
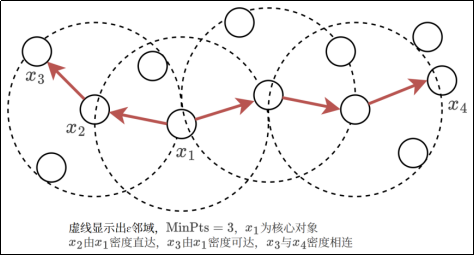
DBSCAN 将簇定义为由密度可达关系导出的最大密度相连样本集合。算法先根据 $ (\epsilon, MinPts) $ 找出所有核心对象,再以任一核心对象为起点找出由其密度可达的样本生成一个簇,直到所有核心对象均被访问。
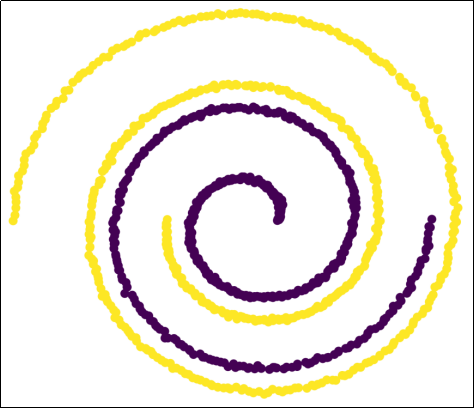
密度聚类能识别任意形状的簇并自动排除噪声点,但 $ \epsilon $ 与 $ MinPts $ 的选择对结果影响较大,且难以适应密度变化很大的数据集。
K-means API 使用
kmeans = KMeans(n_clusters=3)   # n_clusters: 指定 K 的值
kmeans.fit(X)                   # 训练
kmeans.predict(X)               # 预测
kmeans.fit_predict(X)           # 训练并预测
示例代码:
import matplotlib.pyplot as plt
from sklearn.cluster import KMeans
from sklearn.datasets import make_blobs

plt.rcParams["font.sans-serif"] = ["KaiTi"]
plt.rcParams["axes.unicode_minus"] = False

# 使用 make_blobs 生成 3 个簇,每个簇 100 个点
X, y_true = make_blobs(n_samples=300, centers=3, cluster_std=2)
fig, ax = plt.subplots(2, figsize=(8, 8))
ax[0].scatter(X[:, 0], X[:, 1], s=50, c="gray", label="原始数据")
ax[0].set_title("原始数据")
ax[0].legend()

# 使用 K-Means 聚类
kmeans = KMeans(n_clusters=3)
kmeans.fit(X)
y_kmeans = kmeans.predict(X)  # 预测每个点的簇标签
centers = kmeans.cluster_centers_  # 获取簇中心
ax[1].scatter(X[:, 0], X[:, 1], s=50, c=y_kmeans)
ax[1].scatter(centers[:, 0], centers[:, 1], s=200, c="red", marker="o", label="簇中心")
ax[1].set_title("K-means 聚类结果 (K=3)")
ax[1].legend()
plt.show()
结果如下图:
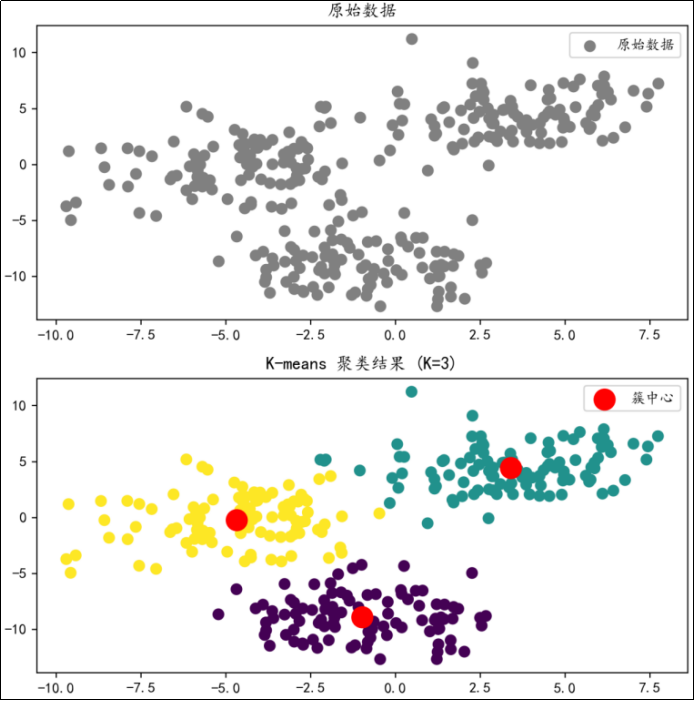
聚类模型评估(了解)
聚类任务没有预定义标签,需依赖聚类结果和原始数据衡量模型好坏,主要关注簇内紧凑性和簇间分离性。
- 轮廓系数(Silhouette Coefficient)
计算每个样本到同簇其他样本的平均距离(内聚度 $ a_i $)和到最近其他簇样本的平均距离(分离度 $ b_i $),综合评价聚类紧密度和分离度。
- $ a_i $(内聚度):样本 $ i $ 到同簇内其他样本的平均距离;$ a_i $ 越小表示该样本与同簇越紧密。
- $ b_i $(分离度):样本 $ i $ 到最近其他簇中样本的平均距离;$ b_i $ 越大表示该样本与其他簇越分离。
样本 $ i $ 的轮廓系数定义为:
$ s_i = \frac{b_i - a_i}{\max(a_i,\, b_i)} \in [-1,1] $
$ s_i $ 越接近 1 聚类效果越好;$ s_i $ 接近 0 表示样本落在两簇边界附近;$ s_i $ 接近 -1 表示样本可能被分错簇。总体轮廓系数为所有 $ s_i $ 的平均值,用于评价整体聚类质量。
- 簇内平方和(Within-Cluster Sum of Squares, WCSS)
衡量簇内数据点到各自簇中心的总距离平方和,常用于 K-means 等基于中心的聚类:
$ \text{WCSS} = \sum_{k=1}^{K} \sum_{i \in C_k} |\boldsymbol{x}_i - \boldsymbol{\mu}_k|^2 $
其中 $ \boldsymbol{\mu}_k $ 是第 $ k $ 个簇的中心(质心),$ C_k $ 为属于第 $ k $ 个簇的样本下标集合。
含义:WCSS 即 K-means 的损失 $ W(C) $;值越小表示簇内越紧凑。肘部法常以 WCSS 随 $ K $ 变化的拐点选取较优簇数。
- 肘部法
绘制簇数 $ K $ 与聚类质量指标(通常是 WCSS 或簇内平方和)的关系曲线,找到拐点(「肘部」),即增加 $ K $ 带来的收益显著减少的点,作为较优的 $ K $。
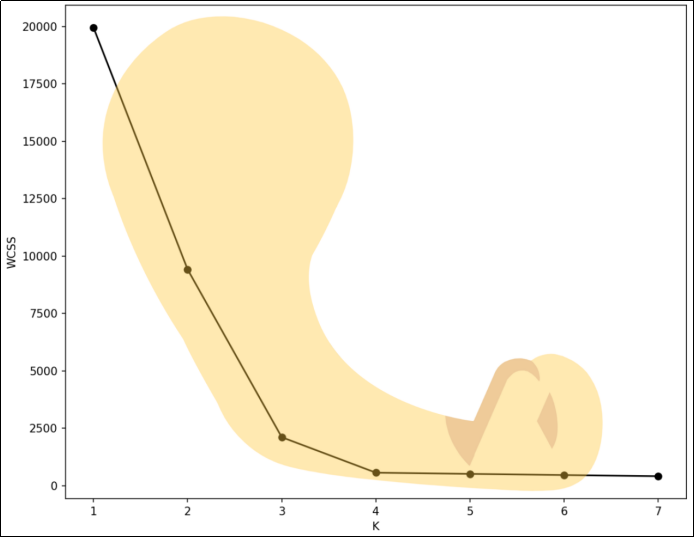
- CH 指数(Calinski-Harabasz Index)
簇间和簇内分散度的比值,也称方差比准则:
$ \text{CH} = \frac{\text{BCSS}\,/\,(K-1)}{\text{WCSS}\,/\,(N-K)} $
其中 $ N $ 为样本总数,$ K $ 为簇数。
含义:CH =(簇间分散度 / 自由度 $ (K-1) $)/(簇内分散度 / 自由度 $ (N-K) $)。值越大表示簇间分离越好、簇内越紧凑,聚类质量越高。
簇间平方和(BCSS,Between-Cluster Sum of Squares)定义为:
$ \text{BCSS} = \sum_{k=1}^{K} n_k |\boldsymbol{\mu}_k - \boldsymbol{\mu}|^2 $
簇内平方和(WCSS)定义为:
$ \text{WCSS} = \sum_{k=1}^{K} \sum_{i \in C_k} |\boldsymbol{x}_i - \boldsymbol{\mu}_k|^2 $
符号说明:$ n_k $ 是第 $ k $ 个簇的样本数,$ \boldsymbol{\mu}_k $ 为第 $ k $ 个簇的中心,$ \boldsymbol{\mu} $ 是所有样本的中心(全局质心),$ C_k $ 为属于第 $ k $ 个簇的样本下标集合。
聚类评估 API 使用示例:
import matplotlib.pyplot as plt
from sklearn.cluster import KMeans
from sklearn.datasets import make_blobs
from sklearn.metrics import silhouette_score, calinski_harabasz_score

plt.rcParams["font.sans-serif"] = ["SimHei"]
plt.rcParams["axes.unicode_minus"] = False

X, y_true = make_blobs(n_samples=300, centers=3, cluster_std=5)
kmeans = KMeans(n_clusters=3)
kmeans.fit(X)
y_kmeans = kmeans.predict(X)
centers = kmeans.cluster_centers_

plt.scatter(X[:, 0], X[:, 1], s=50, c=y_kmeans, cmap="viridis")
plt.scatter(centers[:, 0], centers[:, 1], s=200, c="red", marker="*", label="簇中心")
plt.legend()
print("簇内平方和:", kmeans.inertia_)
print("轮廓系数:", silhouette_score(X, y_kmeans))
print("CH指数:", calinski_harabasz_score(X, y_kmeans))
plt.show()
降维
奇异值分解
基本介绍
奇异值分解(Singular Value Decomposition,SVD)是一种矩阵因子分解方法,用于将矩阵分解为更简单的形式,从而揭示数据的内在结构和特性。通过保留最大的几个奇异值及其对应的奇异向量,可以近似重构原始矩阵,减少数据维度,同时保留主要信息。主成分分析、潜在语义分析等都用到了奇异值分解。
矩阵 $ A $ 的奇异值分解是指将非零实矩阵 $ A_{m \times n} $ 表示为三个矩阵的乘积:
$ A = U \Sigma V^T $
- $ U $ 是 $ m $ 阶正交矩阵:$ U^T U = I_m $。
- $ V $ 是 $ n $ 阶正交矩阵:$ V^T V = I_n $。
- $ \Sigma $ 是由降序排列的非负对角元素组成的 $ m \times n $ 矩形对角阵:$ \Sigma = \operatorname{diag}(\sigma_1, \sigma_2, \ldots, \sigma_{\min(m,n)}) $,$ \sigma_1 \geq \sigma_2 \geq \cdots \geq 0 $。
称上述分解为矩阵 $ A $ 的奇异值分解;$ \sigma_i $ 称为 $ A $ 的奇异值,$ U $ 的列向量称为左奇异向量,$ V $ 的列向量称为右奇异向量。任一实矩阵一定存在奇异值分解,且奇异值分解不唯一。
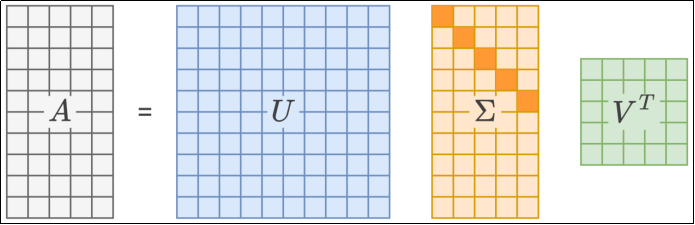
$ V $ 来自 $ A^T A $ 的特征向量,$ \Sigma $ 来自其特征值的平方根,$ U $ 的前 $ r $ 列由 $ A\boldsymbol{v}_j/\sigma_j $ 得到、其余列由 $ A^T $ 的零空间补全,使 $ A = U\Sigma V^T $。
例:矩阵
$ A = \begin{pmatrix} 1 & 0 & 0 & 0 \ 0 & 0 & 0 & 4 \ 0 & 3 & 0 & 0 \ 0 & 0 & 0 & 0 \ 2 & 0 & 0 & 0 \end{pmatrix} $
它的奇异值分解由 $ U\Sigma V^T $给出,$ U $、$ \Sigma $、$ V^T $分别为:
$ U = \begin{pmatrix} 0 & 0 & \sqrt{0.2} & 0 & \sqrt{0.8} \ 1 & 0 & 0 & 0 & 0 \ 0 & 1 & 0 & 0 & 0 \ 0 & 0 & 0 & 0 & 0 \ 0 & 0 & \sqrt{0.8} & 0 & -\sqrt{0.2} \end{pmatrix},\quad
\Sigma = \begin{pmatrix} 4 & 0 & 0 & 0 \ 0 & 3 & 0 & 0 \ 0 & 0 & \sqrt{5} & 0 \ 0 & 0 & 0 & 0 \ 0 & 0 & 0 & 0 \end{pmatrix},\quad
V^T = \begin{pmatrix} 0 & 0 & 0 & 1 \ 0 & 1 & 0 & 0 \ 1 & 0 & 0 & 0 \ 0 & 0 & 1 & 0 \end{pmatrix} $
奇异值分解算法
矩阵 $ A $ 的奇异值分解可以通过求对称矩阵 $ A^T A $ 或 $ A A^T $ 的特征值和特征向量得到。$ A^T A $ 的单位化特征向量构成正交矩阵 $ V $ 的列;$ A^T A $ 的特征值的非负平方根为奇异值,按从大到小排列构成 $ \Sigma $ 的对角元;由 $ A V = U \Sigma $ 可得到左奇异向量构成 $ U $。若 $ r = \operatorname{rank}(A) < \min(m,n) $,则需对 $ U $ 或 $ V $ 补充正交向量使成为正交方阵。
具体步骤如下:
步骤 1:求 $ A^T A $ 的特征值与特征向量
解特征方程
$ (A^T A - \lambda I)\,\boldsymbol{x} = \boldsymbol{0} $
得到特征值并按其从大到小排列:
$ \lambda_1 \geq \lambda_2 \geq \cdots \geq \lambda_p \geq 0 $
步骤 2:构造正交矩阵 $ V $
将各特征值代入上式求出对应的特征向量,并将特征向量单位化,得到单位特征向量 $ \boldsymbol{v}_1,\boldsymbol{v}_2,\ldots,\boldsymbol{v}_p $,构成正交矩阵
$ V = \begin{pmatrix} \boldsymbol{v}_1 & \boldsymbol{v}_2 & \cdots & \boldsymbol{v}_p \end{pmatrix} $
步骤 3:构造对角阵 $ \Sigma $
特征值的非负平方根为奇异值 $ \sigma_i = \sqrt{\lambda_i} $,按从大到小排列作为对角线元素构成 $ m \times n $ 矩形对角阵:
$ \Sigma = \operatorname{diag}(\sigma_1,\, \sigma_2,\, \ldots,\, \sigma_p),\quad \sigma_1 \geq \sigma_2 \geq \cdots \geq \sigma_p \geq 0 $
步骤 4:构造正交矩阵 $ U $
设 $ A $ 的秩为 $ r $(正奇异值个数)。对 $ A $ 的正奇异值,计算 $ U $ 的列向量:
$ \boldsymbol{u}_j = \frac{1}{\sigma_j} A \boldsymbol{v}_j,\quad j = 1,\,2,\,\ldots,\,r $
记 $ U_1 = \begin{pmatrix} \boldsymbol{u}_1 & \boldsymbol{u}_2 & \cdots & \boldsymbol{u}_r \end{pmatrix} $。
若 $ n > r $,则需补充 $ A^T $ 的零空间 $ N(A^T) $ 的一组标准正交基 $ \boldsymbol{u}{r+1},\,\ldots,\,\boldsymbol{u}_n $(即求解 $ A^T \boldsymbol{x} = \boldsymbol{0} $ 得到基础解系再单位正交化),令 $ U_2 = \begin{pmatrix} \boldsymbol{u}{r+1} & \cdots & \boldsymbol{u}_n \end{pmatrix} $,则
$ U = \begin{pmatrix} U_1 & U_2 \end{pmatrix} $
为 $ m \times m $ 正交矩阵。
以求 $ A = \begin{pmatrix} 1 & 1 \ 2 & 2 \ 0 & 0 \end{pmatrix} $ 的奇异值分解为例:
首先求 $ A^T A $ 的特征值和特征向量,特征方程为 $ (A^T A - \lambda I)\boldsymbol{x} = \boldsymbol{0} $。得到齐次线性方程组:
$ (5-\lambda)x_1 + 5x_2 = 0,\quad 5x_1 + (5-\lambda)x_2 = 0 $
该方程组有非零解的充要条件是:
$ \left| \begin{array}{cc} 5-\lambda & 5 \ 5 & 5-\lambda \end{array} \right| = 0 $
即 $ \lambda^2 - 10\lambda = 0 $。解得 $ \lambda_1 = 10 $,$ \lambda_2 = 0 $。代入线性方程组,得到对应的单位向量:
$ \boldsymbol{v}_1 = \begin{pmatrix} 1/\sqrt{2} \ 1/\sqrt{2} \end{pmatrix},\quad \boldsymbol{v}_2 = \begin{pmatrix} 1/\sqrt{2} \ -1/\sqrt{2} \end{pmatrix} $
构成正交矩阵
$ V = \begin{pmatrix} 1/\sqrt{2} & 1/\sqrt{2} \ 1/\sqrt{2} & -1/\sqrt{2} \end{pmatrix} $
奇异值 $ \sigma_1 = \sqrt{\lambda_1} = \sqrt{10} $,$ \sigma_2 = \sqrt{\lambda_2} = 0 $,构造对角矩阵:
$ \Sigma = \begin{pmatrix} \sqrt{10} & 0 & 0 \ 0 & 0 & 0 \ 0 & 0 & 0 \end{pmatrix} $
(注:$ A $ 为 $ 3\times 2 $ 时,$ \Sigma $ 取 $ 3\times 2 $ 矩形对角阵 $ \begin{pmatrix} \sqrt{10} & 0 \ 0 & 0 \ 0 & 0 \end{pmatrix} $,下同。)
基于 $ A $ 的正奇异值计算得到列向量 $ \boldsymbol{u}_1 $:
$ \boldsymbol{u}_1 = \frac{1}{\sigma_1}A\boldsymbol{v}_1 = \frac{1}{\sqrt{10}} \begin{pmatrix} 1 & 1 \ 2 & 2 \ 0 & 0 \end{pmatrix} \begin{pmatrix} 1/\sqrt{2} \ 1/\sqrt{2} \end{pmatrix} = \frac{1}{\sqrt{10}} \begin{pmatrix} 2/\sqrt{2} \ 4/\sqrt{2} \ 0 \end{pmatrix} = \begin{pmatrix} 1/\sqrt{5} \ 2/\sqrt{5} \ 0 \end{pmatrix} $
列向量 $ \boldsymbol{u}_2 $、$ \boldsymbol{u}_3 $ 是 $ A^T $ 的零空间 $ N(A^T) $ 的一组标准正交基,为此求解下面线性方程组:
$ A^T\boldsymbol{x} = \begin{pmatrix} 1 & 2 & 0 \ 1 & 2 & 0 \end{pmatrix} \begin{pmatrix} x_1 \ x_2 \ x_3 \end{pmatrix} = \begin{pmatrix} 0 \ 0 \end{pmatrix} $
得 $ x_1 + 2x_2 = 0 $,即 $ x_1 = -2x_2 $。分别取 $ (x_2,\,x_3) $ 为 $ (1,\,0) $ 和 $ (0,\,1) $ 得到 $ N(A^T) $ 的基:
$ \begin{pmatrix} -2 \ 1 \ 0 \end{pmatrix},\quad \begin{pmatrix} 0 \ 0 \ 1 \end{pmatrix} $
正交基为:
$ \boldsymbol{u}_2 = \begin{pmatrix} -2/\sqrt{5} \ 1/\sqrt{5} \ 0 \end{pmatrix},\quad \boldsymbol{u}_3 = \begin{pmatrix} 0 \ 0 \ 1 \end{pmatrix} $
构造正交矩阵 $ U $:
$ U = \begin{pmatrix} 1/\sqrt{5} & -2/\sqrt{5} & 0 \ 2/\sqrt{5} & 1/\sqrt{5} & 0 \ 0 & 0 & 1 \end{pmatrix} $
最终得到矩阵 $ A $ 的奇异值分解:
$ A = U\Sigma V^T = \begin{pmatrix} 1/\sqrt{5} & -2/\sqrt{5} & 0 \ 2/\sqrt{5} & 1/\sqrt{5} & 0 \ 0 & 0 & 1 \end{pmatrix} \begin{pmatrix} \sqrt{10} & 0 \ 0 & 0 \ 0 & 0 \end{pmatrix} \begin{pmatrix} 1/\sqrt{2} & 1/\sqrt{2} \ 1/\sqrt{2} & -1/\sqrt{2} \end{pmatrix} $
上述过程只是为了说明计算的过程,实际应用中不会使用此算法。
主成分分析
基本介绍
主成分分析(Principal Component Analysis,PCA)是一种常用的无监督学习方法,旨在找到数据中「最重要的方向」,即方差最大的方向,并用这些方向重新表达数据。
在 PCA 中,通常先将数据的每个特征规范化为均值为 0、方差为 1(或至少中心化),以消除量纲差异,再通过正交变换把线性相关的原始数据转换为线性无关的新变量(主成分)。主成分彼此正交并尽可能保留原始数据的方差。PCA 主要用于降维和发现数据的基本结构。
可直观理解为:对数据所在的原始坐标系进行旋转变换,将数据投影到新坐标系的坐标轴上;新坐标系的第一、第二坐标轴等分别对应第一、第二主成分等;数据在各轴上的投影方差之和在所有正交坐标系中最大。
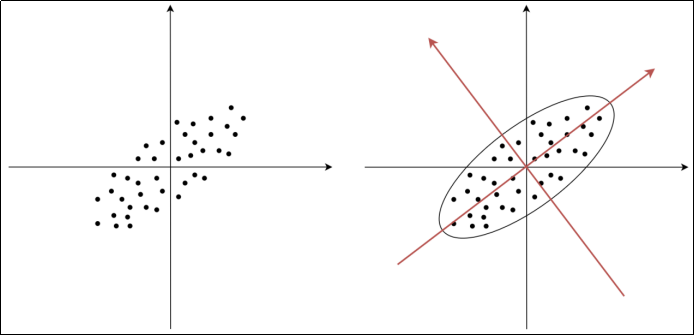
在数据总体上进行的主成分分析称为总体主成分分析,在有限样本上进行的主成分分析称为样本主成分分析。实际问题中通常在观测数据(样本)上进行,即样本主成分分析。
传统 PCA 可通过协方差矩阵或相关矩阵的特征值分解实现。
- 协方差矩阵描述变量之间的方差和协方差,适用于未标准化的数据;
- 相关矩阵描述变量之间的标准化相关性,适用于标准化的数据。
- 特征值分解的结果给出了主成分的方向(特征向量)和每个主成分的方差(特征值)。
现在常用的方法是通过奇异值分解(SVD)进行主成分分析。
奇异值分解实现主成分分析
通过奇异值分解实现主成分分析可以避免显式形成协方差矩阵,提高计算效率。
计算过程如下:
设规范化后的样本矩阵为 $ X $(每行为一个样本,每列为一个特征,列均值为 0、方差为 1)。对 $ X $ 进行奇异值分解:
$ X = U \Sigma V^T $
则 $ V $ 的列向量就是主成分的方向,主成分矩阵为 $ X V $。$ \Sigma $ 的对角元与协方差矩阵的特征值相关。第 $ j $ 个主成分的方差贡献率为 $ \sigma_j^2 / \sum_i \sigma_i^2 $,用于决定保留多少主成分。
数学验证如下:给定样本矩阵(每行为一个样本,每列为一个特征),对其进行规范化使每列均值为 0、方差为 1,得到矩阵 $ X $。$ X $ 的协方差矩阵为
$ S_X = \frac{1}{n-1} X^T X $
其中 $ n $ 为样本数。代入奇异值分解 $ X = U \Sigma V^T $,因 $ U $ 是正交矩阵,$ U^T U = I $,故
$ X^T X = (U \Sigma V^T)^T (U \Sigma V^T) = V \Sigma^T U^T U \Sigma V^T = V \Sigma^T \Sigma V^T $
于是
$ S_X = \frac{1}{n-1} X^T X = \frac{1}{n-1} V \Sigma^T \Sigma V^T = V \underbrace{\frac{\Sigma^T \Sigma}{n-1}}_{\Lambda} V^T = V \Lambda V^T $
其中 $ \Lambda = \operatorname{diag}(\lambda_1,\ldots,\lambda_p) $,$ \lambda_i = \sigma_i^2 / (n-1) $。
这正是协方差矩阵 $ S_X $ 的特征值分解形式:$ V $ 的列为特征向量(主成分方向),$ \lambda_i = \sigma_i^2/(n-1) $ 为对应的特征值(主成分方差)。
因此用 SVD 得到 $ X = U\Sigma V^T $ 后,主成分方向即 $ V $ 的列,主成分方差与 $ \sigma_i^2 $ 成正比。
一起交流
分享你的思考,让讨论更进一步。