
📍 你在这里 AI 基础 · 第 10 篇 / 共 13 篇
第一章 深度学习概述
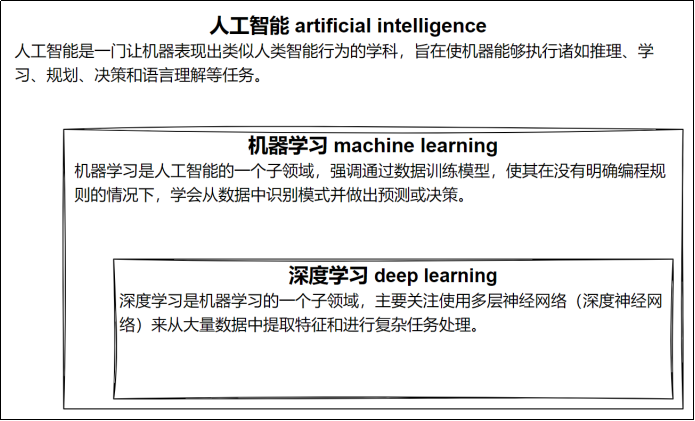
深度学习作为机器学习的一个分支,专注于使用多层神经网络(深度神经网络)来建模和解决问题。
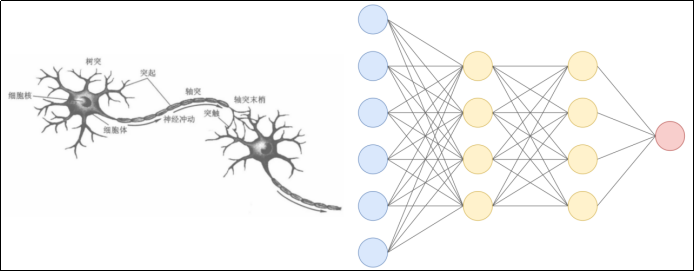
人脑中有很多相互连接的神经元,当大脑处理信息时,这些神经元之间通过电信号和化学物质相互作用,在大脑的不同区域之间传递信息。神经网络使用人工神经元模仿这种生物现象,这些人工神经元由称为节点的软件模块构成,使用数值计算来进行通信和传递信息。
深度学习的特点:
- 使用多层神经网络,能够自动提取数据的多层次特征。
- 适合处理非结构化数据,如图像、音频、文本等。
- 依赖大量数据和计算资源,训练时间较长。
- 模型复杂,通常被视为“黑箱”,解释性较差。
深度学习应用场景:
- 金融服务:预测分析可推荐股票的算法交易,评估贷款审批的业务风险,检测欺诈行为,并帮助管理信贷和投资组合。
- 媒体和娱乐:从网上购物到流媒体服务,跟踪用户活动及开发个性化推荐也应用到了深度学习。
- 客户服务:聊天机器人、虚拟助手和拨入式客户服务门户网站利用语音识别等工具。
- 医疗卫生:通过图像识别应用和深度学习技术,医学影像专家可以利用数字化的医疗记录和医学影像数据来支持和改进医学诊断过程,提供更精确和高效的医疗服务。
- 工业自动化:在工厂和仓库中,深度学习应用可以自动检测人或物体何时处于机器的安全距离之外,或协助质量控制及预测性维护。
- 自动驾驶汽车:汽车行业研究员使用深度学习来训练汽车检测停车标志、红绿灯、人行横道和行人等对象。
- 航空航天和军事:深度学习技术可以用来在监控的大片地理区域中检测物体,从远处识别需要关注的区域,并为部队验证安全或不安全区域。
- 执法:语音识别、计算机视觉和自然语言处理(NLP)有助于分析大量数据,从而节省时间和资源。
第二章 神经网络基础
神经网络的构成
基本概念和结构

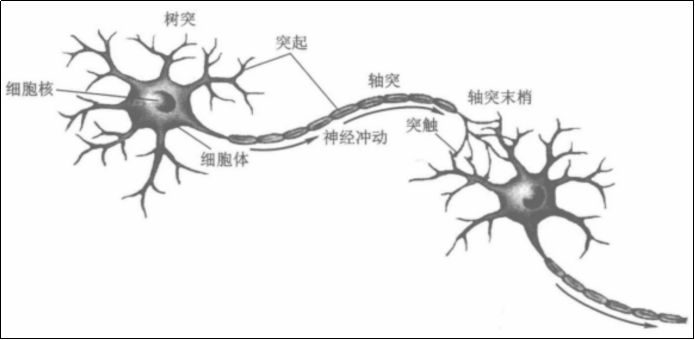
神经元从树突接收其它神经元细胞发出的电化学刺激脉冲,这些脉冲叠加后,一旦强度达到临界值,这个神经元就会产生动作电位,沿着轴突发送电信号。
轴突将刺激传到末端的突触,电信号触发突触上面的电压敏感蛋白,把一个内含神经递质的小泡(突触小体)推到突触的膜上,从而释放出突触小体中的神经递质。这些化学物质会扩散到其它神经元的树突或轴突上。
人工神经网络(Artificial Neural Network,ANN)简称神经网络(NN),是一种模仿生物神经网络结构和功能的计算模型。大多数情况下人工神经网络能在外界信息的基础上改变内部结构,是一种自适应系统(adaptive system),通俗地讲就是具备学习功能。
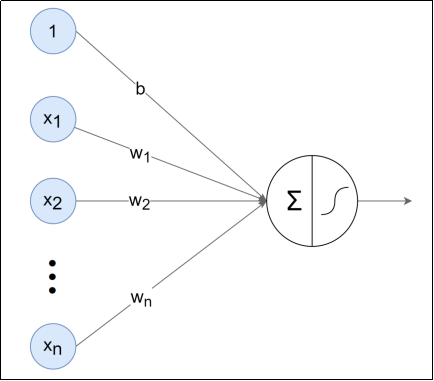
人工神经网络中的神经元,一般可以对多个输入进行加权求和,再经过特定的"激活函数"转换后输出。

使用多个神经元就可以构建多层神经网络,最左边的一列神经元都表示输入,称为 输入层;最右边一列表示网络的输出,称为 输出层;输入层与输出层之间的层统称为 中间层(隐藏层)。
相邻层的神经元相互连接(图中下一层每个神经元都与上一层所有神经元连接,称为
全连接),每个连接都会有一个 权重。
神经元中的信息逐层传递(一般称为前向传播 forward),上一层神经元的输出作为下一层神经元的输入。
联想感知机
回顾在机器学习部分的感知机内容。
感知机(Perceptron)是二分类模型,接收多个信号,输出一个信号。感知机的信号只有0、1两种取值。
下图是一个接收两个输入信号的感知机的例子:

$ x_{1},x_{2} $ 是输入信号,$ y\ $是输出信号,$ w_{1},w_{2}\ $是权重,○ 称为神经元或节点。输入信号被送往神经元时,会分别乘以固定的权重。神经元会计算传送过来的信号的总和,只有当这个总和超过某个界限值时才会输出1,也称之为神经元被激活。
$ y = \begin{cases}
0 & b + w_1 x_1 + w_2 x_2 \leq 0 \
1 & b + w_1 x_1 + w_2 x_2 > 0
\end{cases} $
这里将界限的阈值设为0。除了权重$ w_{1},w_{2} $之外,还可以增加一个参数$ b $,被称为
偏置。

感知机的多个输入信号都有各自的权重,这些权重发挥着控制各个信号的重要性的作用,权重越大,对应信号的重要性越高。偏置则可以用来控制神经元被激活的容易程度。
引入激活函数
可以看出,式(2.1)中包含了两步处理操作:首先按照输入各自的权重及偏置,计算出一个加权总和;然后再根据这个总和与阈值的大小关系,决定输出 0 还是 1。
如果定义一个函数:
$ h(x) = \begin{cases}
0 & x \leq 0 \
1 & x > 0
\end{cases} \tag{2.2} $
那么式(2.1)就可以简化为:
$ y = h(b + w_1 x_1 + w_2 x_2) \tag{2.3} $
为了更明显地表示出两个处理步骤,可以进一步写成:
$ a = b + w_1 x_1 + w_2 x_2 \tag{2.4} $
$ y = h(a) \tag{2.5} $
这里将输入信号和偏置的加权总和,记作 $ a $。

$ h(x) $可以将输入信号的加权总和转换为输出信号,起到"激活神经元"的作用,所以被称为激活函数。
激活函数
激活函数的作用
激活函数是连接感知机和神经网络的桥梁,在神经网络中起着至关重要的作用。
如果没有激活函数,整个神经网络就等效于单层线性变换,不论如何加深层数,总是存在与之等效的“无隐藏层的神经网络”。激活函数必须是非线性函数,也正是激活函数的存在为神经网络引入了非线性,使得神经网络能够学习和表示复杂的非线性关系。
常见的激活函数
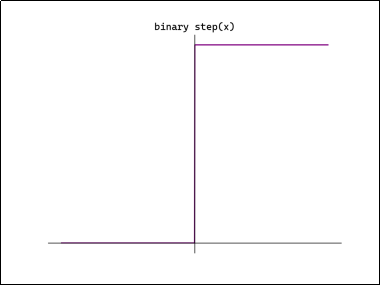
阶跃(Binary step)函数
上文的感知机中,式(2.2)表示的$ \ h(x) $就是最简单的激活函数,它可以为输入设置一个"阈值";一旦超过这个阈值,就切换输出(0或者1)。这种函数被称为"阶跃函数"。阶跃函数的导数恒为 0。
定义

原理
本质上是“硬开关”而不是平滑变化:输入一旦跨过边界,输出会突然跳变。也正因为这种不连续特性,它更适合规则判定,不适合梯度优化。
说明
这种形式在感知机时代很直观,但不适合现代神经网络训练,因为它在几乎所有位置都不给有效梯度,导致参数很难通过反向传播更新。
深度学习依赖梯度下降来更新参数,而阶跃函数几乎不给梯度信号,因此网络难以学习到稳定可泛化的参数。
代码实现:
def step_function(x):
    if x > 0:
        return 1
    else:
        return 0
这里的 $ x $ 只能取一个数值(浮点数)。如果希望直接传入 Numpy 数组进行批量化的操作,可以改进如下:
def step_function(x):
    return np.array(x > 0, dtype=int)
Sigmoid 函数
Sigmoid(也叫 Logistic 函数)是平滑的、可微的,能将任意输入映射到区间 (0,1)。
定义
$ \sigma(x)=\frac{1}{1+e^{-x}} $
导数
$ \sigma'(x)=\sigma(x)\big(1-\sigma(x)\big) $
推导
$ \sigma(x)=\frac{1}{1+e^{-x}}=(1+e^{-x})^{-1} $
$ \sigma'(x)=-(1+e^{-x})^{-2}\cdot(-e^{-x})
=\frac{e^{-x}}{(1+e^{-x})^2}
=\frac{1}{1+e^{-x}}\left(1-\frac{1}{1+e^{-x}}\right)
=\sigma(x)\big(1-\sigma(x)\big) $
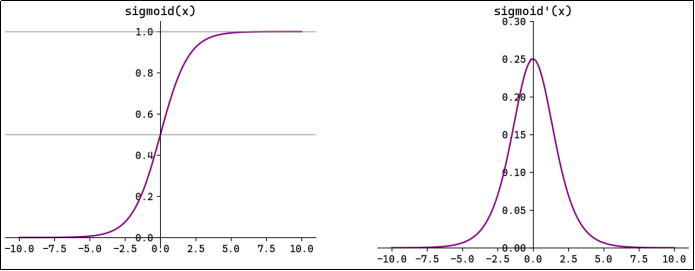
常用于二分类的输出层。但因其涉及指数运算,计算量相对较高。
说明
Sigmoid 会把任意实数压到 $ (0,1) $ 区间,因此非常适合表达“概率”,尤其是二分类任务中的正类概率。
- Sigmoid 的输入在 [-6,6] 之外时,其输出值变化很小,可能导致信息丢失。
- Sigmoid 的输出并非以 0 为中心,其输出值均>0,导致后续层的输入始终为正,可能影响后续梯度更新方向。
- Sigmoid的导数范围为 (0,0.25),梯度较小。当输入在 [-6,6] 之外时,导数接近 0,此时网络参数的更新将会极其缓慢。
主要问题是存在饱和区,当输入绝对值很大时,函数斜率趋近于 0,梯度会显著变小,深层网络中容易出现梯度消失(在逐层反向传播时,梯度会呈指数级衰减)。
代码实现:
def sigmoid(x):
    return 1 / (1 + np.exp(-x))
Tanh 函数
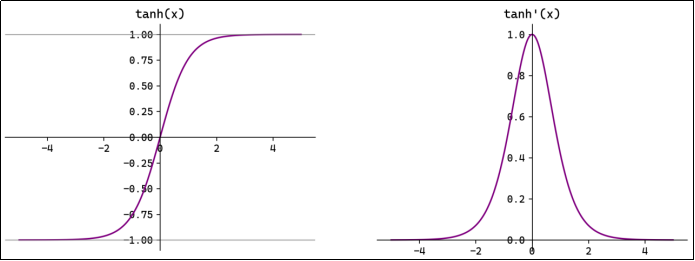
Tanh(双曲正切)将输入映射到区间$ (-1,1) $。其关于原点中心对称。常用在隐藏层。
定义
$ \tanh(x)=\frac{e^x-e^{-x}}{e^x+e^{-x}}
=\frac{1-e^{-2x}}{1+e^{-2x}} $
与 Sigmoid 的关系
$ \tanh(x)=2\sigma(2x)-1 $
导数
$ \tanh'(x)=1-\tanh^2(x) $
说明
Tanh 以 0 为中心这一点通常让梯度更新更均衡,不会像 Sigmoid 那样全部落在正区间,从而减少更新方向偏置。所以在一些场景下它比 Sigmoid 更适合作为隐藏层激活。
输入在 [-3,3] 之外时,Tanh 的输出值变化很小,此时其导数接近 0。
Tanh 的输出以0为中心,且其梯度相较于 Sigmoid 更大,收敛速度相对更快。但同样也存在梯度消失现象,输入过大时仍会进入饱和区。
代码实现:
import numpy as np

def tanh(x):
    return np.tanh(x)
ReLU 函数
ReLU(Rectified Linear Unit,修正线性单元)会将小于 0 的输入转换为 0,大于等于0 的输入则保持不变。
定义
$ f(x)=\max(0,x)=
\begin{cases}
0, & x\le 0 \
x, & x>0
\end{cases} $
$ f'(x)=
\begin{cases}
0, & x\le 0 \
1, & x>0
\end{cases} $
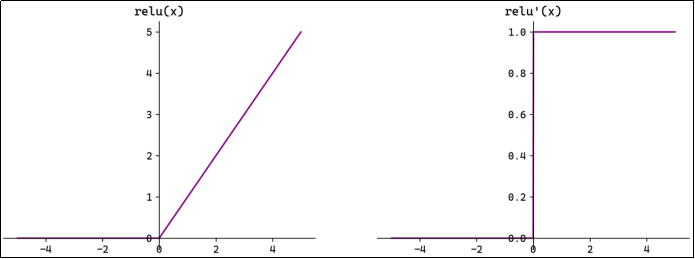
注意:x=0 时 ReLU 函数不可导,此时默认使用左侧的函数。
说明
ReLU 计算非常简单,前向与反向都高效,因此成为隐藏层最常见的默认选择。
ReLU 的行为可以理解为“保留正信号,屏蔽负信号”:正数原样通过,负数直接截断为 0。作为激活函数不存在梯度消失。
ReLU 在正区间梯度恒为 1,有利于缓解深层网络中的梯度衰减;当输入小于 0 时,输出为 0,这意味着在神经网络中,ReLU 激活的节点只有部分是"活跃"的,这种机制会形成稀疏激活(很多位置输出为 0),有助于减少计算量和提高模型的效率。但当神经元长期处于负半轴时,梯度一直为 0,积大量的神经元都变成了“死神经元”,参数几乎不再更新,这就是“死亡 ReLU”。
为解决此问题,可使用 Leaky ReLU 来代替 ReLU 作为激活函数。Leaky ReLU
$ \left( f(x) = \left{ \begin{array}{r}
\alpha x,x \leq 0 \
x,x > 0
\end{array} \right.\ ,其中\alpha 是一个很小的常数 \right) $在负数区域引
入一个小的斜率来解决"神经元死亡"问题。
代码实现:
def relu(x):
    return np.maximum(0, x)
Softmax 函数
Softmax 的作用是将一个任意的实数向量转换为一个概率分布,确保输出值的总和为 1,是二分类激活函数 Sigmoid 在多分类上的推广。Softmax 常用于多分类问题的输出层,用来表示类别的预测概率。
定义
$ y_k=\frac{e^{x_k}}{\sum_{i=1}^{n}e^{x_i}},\quad k=1,\dots,n $
为什么减去最大值不改变结果
设 $ m=\max_i x_i $,则:
$ \frac{e^{x_k-m}}{\sum_i e^{x_i-m}}
=\frac{e^{-m}e^{x_k}}{e^{-m}\sum_i e^{x_i}}
=\frac{e^{x_k}}{\sum_i e^{x_i}} $
因此结果不变,但指数不容易溢出。
导数(雅可比形式)
$ \frac{\partial y_k}{\partial x_i}=
\begin{cases}
y_k(1-y_k), & i=k \
-y_k y_i, & i\ne k
\end{cases} $
Softmax 会放大输入中较大的值,使得最大输入值对应的输出概率较大,其他较小的值会被压缩。即在类别之间起到了一定的区分作用。
$ \begin{bmatrix}
1 \
3 \
5 \
10
\end{bmatrix}\overset{Softmax}{\rightarrow}\begin{bmatrix}
0.00012246 \
0.00090485 \
0.006686 \
0.99229
\end{bmatrix} $
Softmax 函数用代码实现如下:
def softmax(x):
    return np.exp(x) / np.sum(np.exp(x))
考虑到 x 较大时,指数函数的值会非常大,容易溢出,可以改进为:
def softmax(x):
    x = x - np.max(x)  # 溢出对策
    return np.exp(x) / np.sum(np.exp(x))
考虑到 x 为二维数组(矩阵)的情况,可以进一步写为:
def softmax(x):
    if x.ndim == 2:
        x = x.T
        x = x - np.max(x, axis=0)
        y = np.exp(x) / np.sum(np.exp(x), axis=0)
        return y.T

    x = x - np.max(x)  # 溢出对策
    return np.exp(x) / np.sum(np.exp(x))
其他常见激活函数
- Identity(恒等函数)
$ f(x) = x,f'(x) = 1 $

- Leaky ReLU(Leaky Rectified Linear Unit)
$ f(x) = \left{ \begin{array}{r}
\alpha x,x \leq 0 \
x,x > 0
\end{array} \right.\ ,f'(x) = \left{ \begin{array}{r}
\alpha,x \leq 0 \
1,x > 0
\end{array} \right.\ $

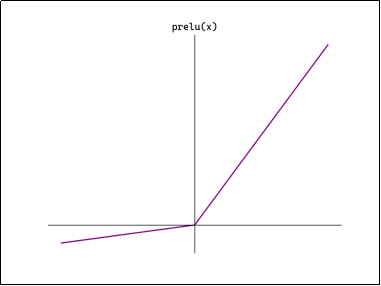
- PReLU(Parametric Rectified Linear Unit)
$ f(x) = \left{ \begin{array}{r}
\alpha x,x \leq 0 \
x,x > 0
\end{array} \right.\ ,f'(x) = \left{ \begin{array}{r}
\alpha,x \leq 0 \
1,x > 0
\end{array} \right.\ (\alpha是一个可训练的参数,而非固定的常数) $
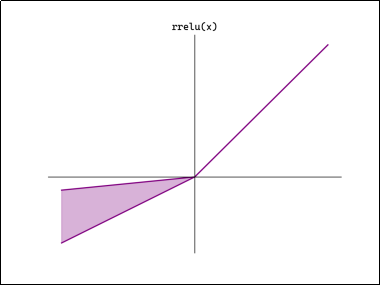
- RReLU(Randomized Leaky ReLU)
$ f(x) = \left{ \begin{array}{r}
\alpha x,x \leq 0 \
x,x > 0
\end{array} \right.\ ,f'(x) = \left{ \begin{array}{r}
\alpha,x \leq 0 \
1,x > 0
\end{array} \right.\
(\alpha是一个在训练时从一个均匀分布中随机选择的参数) $
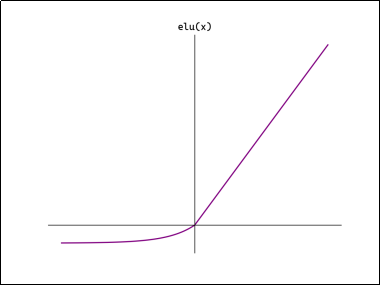
- ELU(Exponential Linear Unit)
$ f(x) = \left{ \begin{array}{r}
\alpha\left( e^{x} - 1 \right),x \leq 0 \
x,x > 0
\end{array} \right.\ ,f'(x) = \left{ \begin{array}{r}
\alpha e^{x},x \leq 0 \
1,x > 0
\end{array} \right.\ $
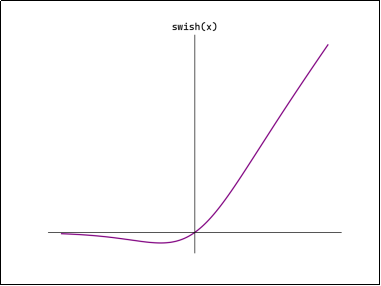
- Swish(也称Sigmoid Linear Unit,SiLU)
$ f(x) = \frac{x}{1 + e^{- x}},f^{'(x)} = \frac{1 + e^{- x} + xe^{- x}}{\left( 1 + e^{- x} \right)^{2}} $
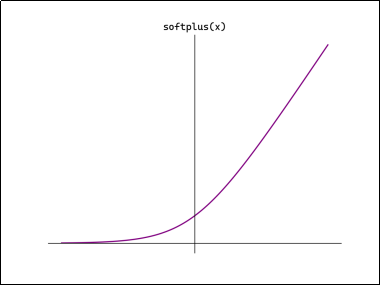
- Softplus
$ f(x) = \ln\left( 1 + e^{x} \right),f^{'(x)} = \frac{1}{1 + e^{- x}} $
如何选择激活函数
隐藏层:
- 首选 ReLU,如果效果不好可尝试 Leaky ReLU 等。
- Sigmoid 在隐藏层易导致梯度消失,应尽量避免。
- Tanh 的输出均值为 0,对中心化数据更友好,但仍可能引发梯度消失,仅适用于浅层网络。
输出层:
- 二分类选择 Sigmoid。
- 多分类选择 Softmax。
- 回归默认选择 Identity。
神经网络的简单实现
深度神经网络由多个层(layer)组成,通常将其称之为模型(Model)。整个模型接受原始输入(特征),生成输出(预测),并包含一些参数。而在模型内部,每个单独的层都会接受一些输入(由前一层提供),生成输出(到下一层的输入),并包含一组参数;层层向下传递,就可以得到最终的输出值。
神经网络中的参数,就是每一层的权重和偏置。
三层神经网络
这里以一个三层神经网络为例,实现从输入到输出的处理计算,这个过程就是前向传播(forward)。

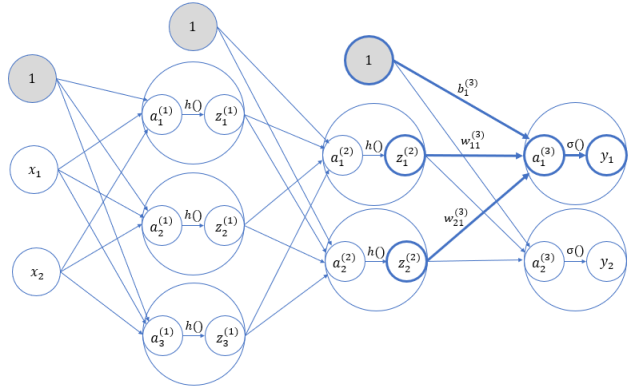
说明:输入层(第0层)有2个神经元;第1个隐藏层(第1层)有3个神经元;第2个隐藏层(第2层)有2个神经元;输出层(第3层)有2个神经元。
各层之间的信号传递
上面只是三层网络的示意图,实际上每层还应该有偏置,各输入信号加权总和还要经过激活函数的处理。接下来逐层进行分析,考察信号在各层之间传递的过程。
输入层(第0层)→ 第1层:
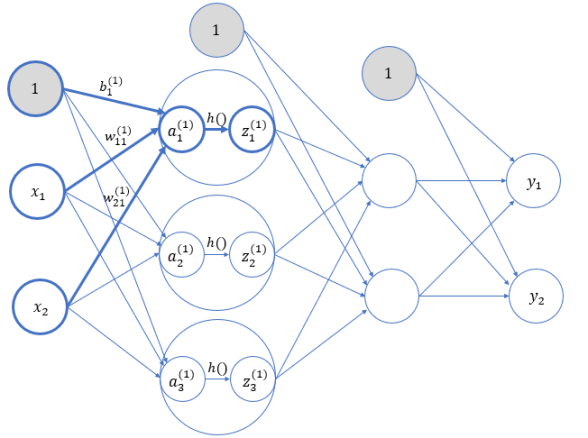
权重和神经元的上标(1)表示网络层号,下标对于神经元来说,表示这一层内的"索引号";对于权重来说则包含两个数字,分别代表前一层和后一层神经元的索引号。
所以,$ w_{21}^{(1)} $就表示这是第1层的权重(输入层到第1层),并且是从第 2 个输入节点到第 1 层第 1 个节点。偏置的下标只有 1 个,因为前一层的偏置节点只有一个。
所以,可以利用式(2.4)(2.5)得到:
$ a_{1}^{(1)} = w_{11}^{(1)}x_{1} + w_{21}^{(1)}x_{2} + \ b_{1}^{(1)}
(2.6) $
$ z_{1}^{(1)} = h(a_{1}^{(1)})
(2.7) $
同样,对于第1层的第 2 个、第 3 个神经元,有:
$ a_{2}^{(1)} = w_{12}^{(1)}x_{1} + w_{22}^{(1)}x_{2} + \ b_{2}^{(1)} $
$ a_{3}^{(1)} = w_{13}^{(1)}x_{1} + w_{23}^{(1)}x_{2} + \ b_{3}^{(1)} $
可以直接写成矩阵乘法的形式:
$ A^{(1)} = XW^{(1)} + B^{(1)}
(2.8) $
其中,
$ {A^{(1)} = \left( a_{1}^{(1)}\ \ a_{2}^{(1)}\ \ a_{3}^{(1)} \right),\ \ X = \left( x_{1}\ \ x_{2} \right),\ \ B^{(1)} = \left( b_{1}^{(1)}\ \ b_{2}^{(1)}\ \ b_{3}^{(1)} \right),\
}{W^{(1)} = \begin{pmatrix}
w_{11}^{(1)} & w_{12}^{(1)} & w_{13}^{(1)} \
w_{21}^{(1)} & w_{22}^{(1)} & w_{23}^{(1)}
\end{pmatrix}} $
可以看到,由于有2个输入节点、3个第1层节点,所以全连接层的权重 _W _就应该是一个 2×3 的矩阵。这样就可以很容易地利用 Numpy 中的矩阵乘法计算出输出信号值了。
第1层 → 第2层:
第1层到第2层的处理类似,权重参数应该是一个3×2的矩阵。

第2层 → 输出层(第3层):
第2层到输出层的处理也类似,权重参数为2×2的矩阵;不过输出层的激活函数一般与隐藏层是不同的,这里用$ \sigma() $ 表示。
代码实现:
可以将神经网络的所有参数(每一层的权重_w_和偏置_b_),保存在一个字典network中;并定义函数:
init_network():对参数进行初始化,每一个权重参数都是一个矩阵(二维),每一个偏置参数则是一个数组(一维);forward():前向传播,将输入信号转换为输出信号的处理操作。
这里的激活函数,隐藏层用 sigmoid,输出层用 identity(恒等函数)。
具体代码如下:
import numpy as np
from dl_code.common.functions import sigmoid, identity_function

# 初始化网络
def init_network():
    network = {}
    network['W1'] = np.array([[0.1, 0.3, 0.5], [0.2, 0.4, 0.6]])
    network['b1'] = np.array([0.1, 0.2, 0.3])
    network['W2'] = np.array([[0.1, 0.4], [0.2, 0.5], [0.3, 0.6]])
    network['b2'] = np.array([0.1, 0.2])
    network['W3'] = np.array([[0.1, 0.3], [0.2, 0.4]])
    network['b3'] = np.array([0.1, 0.2])

    return network

# 前向传播
def forward(network, x):
    w1, w2, w3 = network['W1'], network['W2'], network['W3']
    b1, b2, b3 = network['b1'], network['b2'], network['b3']

    a1 = np.dot(x, w1) + b1
    z1 = sigmoid(a1)
    a2 = np.dot(z1, w2) + b2
    z2 = sigmoid(a2)
    a3 = np.dot(z2, w3) + b3
    y = identity_function(a3)

    return y

network = init_network()
x = np.array([1.0, 0.5])
y = forward(network, x)

print(y)
应用案例:手写数字识别
使用 Digit Recognizer 数据集来进行手写数字识别:Digit Recognizer。
(原文档附带的附件请到语雀源文档查看)
文件 train.csv 中包含手绘数字(从0到9)的灰度图像,每张图像为28×28像素,共784像素。每个像素有一个0到255的值表示该像素的亮度。
文件第1列为标签,之后784列分别为784个像素的亮度值。
任务:搭建一个神经网络,实现它的前向传播;也就是要根据输入的数据(28×28=784数据点表示的图像),推断出它到底是哪个数字,这个过程也被称为"推理"。
这里构建的也是一个三层神经网络,输入层应该有784个神经元,输出层有10个神经元(表示0~9的分类结果);中间设置2个隐藏层,第一个隐藏层有50个神经元,第二个隐藏层有100个神经元。这里的参数是需要学习得到的;假设已经学习完毕,直接从保存好的文件中进行读取即可。
具体代码如下:
import numpy as np
import pandas as pd
import joblib
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import MinMaxScaler
from dl_code.common.functions import sigmoid, softmax

# 读取数据
def load_data():
    # 1. 从文件读取数据
    data = pd.read_csv('../data/train.csv')
    # 2. 划分数据集
    X_train, X_test, y_train, y_test = train_test_split(data.drop('label', axis=1), data['label'], test_size=0.3,
                                                        random_state=42)
    # 3. 特征工程:归一化
    scaler = MinMaxScaler()
    X_train = scaler.fit_transform(X_train)
    X_test = scaler.transform(X_test)
    return X_test, y_test


# 初始化模型
def init_network():
    network = joblib.load('../data/nn_sample') # 训练好的参数模型
    return network


# 前向传播
def forward(network, x):
    w1, w2, w3 = network['W1'], network['W2'], network['W3']
    b1, b2, b3 = network['b1'], network['b2'], network['b3']
    # 逐层计算传递
    a1 = np.dot(x, w1) + b1
    z1 = sigmoid(a1)
    a2 = np.dot(z1, w2) + b2
    z2 = sigmoid(a2)
    a3 = np.dot(z2, w3) + b3
    y = softmax(a3)
    return y

# 主流程
# 1. 读取测试数据
x,y = load_data()
# print(x)
# print(y)
# print(x.shape)
# print(y.shape)

# 2. 加载模型(训练好的模型)
network = init_network()

# 3. 前向传播
y_proba = forward(network, x)
print(y_proba)
# 4. 将分类概率转为分类结果
y_pred = np.argmax(y_proba, axis=1) # argmax:返回最大值的索引
print(y_pred)

# 5. 计算准确率
acc = np.mean(y_pred == y) # 计算预测结果与真实标签匹配的比例,即准确率(平均值)
n = x.shape[0]   # 测试样本的总数
accuracy = np.sum(y_pred == y) / n  # 计算预测正确的样本数占总样本数的比例,也是准确率

print('准确率:', acc, accuracy)
批处理优化:
import numpy as np
import pandas as pd
import joblib
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import MinMaxScaler
from dl_code.common.functions import sigmoid, softmax

# 读取数据
def load_data():
    # 1. 从文件读取数据
    data = pd.read_csv('../data/train.csv')
    # 2. 划分数据集
    X_train, X_test, y_train, y_test = train_test_split(data.drop('label', axis=1), data['label'], test_size=0.3,
                                                        random_state=42)
    # 3. 特征工程:归一化
    scaler = MinMaxScaler()
    X_train = scaler.fit_transform(X_train)
    X_test = scaler.transform(X_test)
    return X_test, y_test

# 初始化模型
def init_network():
    network = joblib.load('../data/nn_sample')
    return network

# 前向传播
def forward(network, x):
    w1, w2, w3 = network['W1'], network['W2'], network['W3']
    b1, b2, b3 = network['b1'], network['b2'], network['b3']
    # 逐层计算传递
    a1 = np.dot(x, w1) + b1
    z1 = sigmoid(a1)
    a2 = np.dot(z1, w2) + b2
    z2 = sigmoid(a2)
    a3 = np.dot(z2, w3) + b3
    y = softmax(a3)
    return y

# 主流程
# 1. 读取测试数据
x,y = load_data()
# print(x)
# print(y)
# print(x.shape)
# print(y.shape)

# 2. 加载模型(训练好的模型)
network = init_network()

# 3. 前向传播(批处理)
batch_size = 100 # 批处理窗口
accuracy_cnt = 0 # 预测正确的样本数
n = x.shape[0]   # 测试样本的总数

for i in range(0, n, batch_size):
    x_batch = x[i:i+batch_size] # i:i+batch_size:表示截取一个窗口的数据[i, i+batch_size)
    y_batch = y[i:i+batch_size]
    y_pred = np.argmax(forward(network, x_batch), axis=1)
    accuracy_cnt += np.sum(y_pred == y_batch)

# 4. 计算准确率
print('准确率:', accuracy_cnt / n)
第三章 神经网络的学习
神经网络的主要特点,就是可以从数据中进行"学习"。这个学习的过程,就是让训练数据自动决定最优的权重参数。
神经网络(深度学习)也是机器学习的一种;跟传统机器学习方法相比,神经网络不需要人工设置特征量(如 SIFT、HOG等),这样就可以用同样的流程直接处理所有问题了。
损失函数
神经网络中,需要以某个指标为线索来寻找最优权重参数;这个指标就是损失函数(loss function)。
常见损失函数
均方误差(MSE)
均方误差(Mean Squared Error ,MSE),也称L2 Loss:
$ L = \frac{1}{n}\sum_{i = 1}^{n}\left( y_{i} - t_{i} \right)^{2} $
其中:
- yi 表示神经网络的输出
- ti 表示监督数据的标签(正确的解标签)
- n 则是数据的"维度"
对于固定维度的网络,前面的系数n不重要,因此公式有时也可以写成:
$ L = \frac{1}{2}\sum_{i = 1}^{n}\left( y_{i} - t_{i} \right)^{2} $
L2 Loss对异常值敏感,遇到异常值时易发生梯度爆炸。
代码实现如下:
def mean_squared_error(y, t):
    return 0.5 * np.sum((y - t) ** 2)
交叉熵误差
除均方误差之外,交叉熵误差(Cross Entropy Error)也经常被用作损失函数:
$ L = - \frac{1}{n}\sum_{i = 1}^{n}{t_{i}\log y_{i}} $
其中:
- log 表示自然对数
- yi 表示神经网络的输出
- ti 表示正确解标签;而且,ti 中只有正确解标签对应的值为1,其它均为 0(one-hot表示)
代码实现如下:
# 交叉熵误差
def cross_entropy(y, t):
    # 将y转为二维
    if y.ndim == 1:
        t = t.reshape(1, t.size)
        y = y.reshape(1, y.size)
    # 将t转换为顺序编码(类别标签)
    if t.size == y.size:
        t = t.argmax(axis=1)
    n = y.shape[0]
    # 如果预测概率绝对等于 0,np.log(0) 会导致程序抛出 -inf(负无穷大)
    return -np.sum( np.log(y[np.arange(n), t] + 1e-10) ) / n
分类任务损失函数
二分类任务
二分类任务常用二元交叉熵损失函数(Binary Cross-Entropy Loss)。
$ L = - \frac{1}{n}\sum_{i = 1}^{n}\left( y_{i}\log\widehat{y_{i}} + \left( 1 - y_{i} \right)\log\left( 1 - \widehat{y_{i}} \right) \right) $
其中:
- $ y_{i} $为真实值(通常为0或1)
- $ \widehat{y_{i}} $为预测值(表示样本$ i $为1的概率)
多分类任务
多分类任务常用多类交叉熵损失函数(Categorical Cross-Entropy
Loss)。它是对每个类别的预测概率与真实标签之间差异的加权平均。
$ L = - \frac{1}{n}\sum_{i = 1}^{n}{\sum_{c = 1}^{C}{y_{i,c}\log\widehat{y_{i,c}}}} $
其中:
- C 是类别数
- $ y_{i,c} $为真实值(表示$ y_{i} $是否为类别c,通常为0或1)
- $ \widehat{y_{i,c}} $为预测值(表示样本$ i $为类别c的概率)
回归任务损失函数
MAE
平均绝对误差(Mean Absolute Erro,MAE),也称L1 Loss:
$ L = \frac{1}{n}\sum_{i = 1}^{n}\left| y_{i} - \widehat{y_{i}} \right| $

L1 Loss对异常值鲁棒,但在0点处不可导。
MSE
均方误差(Mean Squared Error,MSE),也称L2 Loss:
$ L = \frac{1}{n}\sum_{i = 1}^{n}\left( y_{i} - \widehat{y_{i}} \right)^{2} $

L2 Loss对异常值敏感,遇到异常值时易发生梯度爆炸。
Smooth L1
平滑L1:
$ Smooth\ L1 = \left{ \begin{array}{r}
\frac{1}{2}\left( y_{i} - \widehat{y_{i}} \right)^{2},\left| y_{i} - \widehat{y_{i}} \right| < 1 \
\left| y_{i} - \widehat{y_{i}} \right| - \frac{1}{2},\left| y_{i} - \widehat{y_{i}} \right| \geq 1
\end{array} \right.\ $

当误差较小时($ \left| y_{i} - \widehat{y_{i}} \right| < 1 $)使用L2 Loss,使得损失函数平滑可导。当误差较大时($ \left| y_{i} - \widehat{y_{i}} \right| \geq 1 $)使用L1 Loss降低异常值的影响。
数值微分
损失函数的值越小,代表我们选取的参数越适合;想要求得损失函数的最小值,最基本的想法就是对函数求导,解出导数值为0的点,并判断它是否为极小值/最小值。
然而,实际的函数直接求导,不容易得到解析解。这时可以用数值微分的方式来求某点处的导数,这在工程上应用非常广泛。
导数和数值微分
在数学上,导数被定义为
$ f'(x) = \frac{df(x)}{dx} = \lim_{h \rightarrow 0}\frac{f(x + h) - f(x)}{h} $
这个定义中表达出了导数的本质。当 x _发生一个微小的变化 _h(或者Δ_x_)时,函数值 _f(x) 也会发生变化;当 h _趋近于 0 时,此时 _f(x) 的"变化率"就是 x _这一点的导数值。

利用这个定义,我们可以直接以数值计算的方式,利用微小的差分来求函数某点处的导数值,这种方法称为数值微分。
对于每个参数 ($ \theta $),数值微分的基本思想是在该参数上施加一个非常小的变化 ($ h $),然后观察损失函数 ($ L $) 的变化。具体来说,给定某个参数 ($ \theta $),我们首先计算当前损失值 ($ L(\theta) $),接着稍微改变这个参数到 ($ \theta + h $) 并再次计算新的损失值 ($ L(\theta + h) $)。
基于这两个点的信息,我们可以使用下面的公式来近似计算该参数处的导数:
$ \frac{\partial L}{\partial \theta} \approx \frac{L(\theta + h) - L(\theta)}{h} $
这里的关键在于,为了得到上述公式的右侧,我们需要执行两次前向传播:
- 第一次:用原始参数 ($ \theta $) 计算损失 ($ L(\theta) $)。
- 第二次:将参数 ($ \theta $) 改变为 ($ \theta + h $) 后重新计算损失 ($ L(\theta + h) $)。
数值微分可以用代码实现非常方便地实现:
def numerial_diff(f, x):
  h = 1e-4 *# 微小值 0.0001*
  return (f(x+h) - f(x-h)) / (2 * h)
在这里,我们以_x_为中心,计算它两边各发生微小变化后的差分,可以避免只计算单向增大时的误差。这种方法称为中心差分。
另外,取微小值 h 时不能太小,这会导致计算机浮点数表示的精度不够,出现舍入误差。
偏导数
如果函数$ f $的自变量并非单个元素,而是多个元素,例如:

可将其中一个元素$ x $看作参数,此时$ f $可看作关于另一元素$ y $的函数。
$ f_{x}(y) = x^{2} + xy + y^{2} $
在$ x = a $固定的情况下,可计算$ f_{x} $关于$ y $的导数。
$ f_{a}'(y) = a + 2y $
这种导数称为偏导数,一般记作:
$ \frac{\partial f}{\partial y}(x,y) = x + 2y $
更一般地来说,一个多元函数$ f\left( x_{1},x_{2},\ldots,x_{n} \right) $在点$ \left( a_{1},a_{2},\ldots,a_{n} \right) $处对$ x_{i} $的偏导数定义为:
$ \frac{\partial f}{\partial x_{i}}\left( a_{1},a_{2},\ldots,a_{n} \right) = \lim_{\mathrm{\Delta}x_{i} \rightarrow 0}\frac{f\left( a_{1},\ldots a_{i} + \mathrm{\Delta}x_{i},\ldots,a_{n} \right) - f(a_{1},\ldots a_{i},\ldots,a_{n})}{\mathrm{\Delta}x_{i}} $
偏导数同样也可以用数值微分的方式来求,即只改变一个自变量、其它不变,做差分考察函数值的变化率。
梯度
多元函数$ f\left( x_{1},\ldots,x_{n} \right) $关于每个变量$ x_{i} $都有偏导数$ \frac{\partial f}{\partial x_{i}} $,在点$ a $处,这些偏导数定义了一个向量。
$ \nabla f(a) = \left\lbrack \frac{\partial f}{\partial x_{1}}(a),\ldots,\frac{\partial f}{\partial x_{n}}(a) \right\rbrack $
这个向量称为$ f $在点$ a $的梯度。
例如:$ f(x,y) = x^{2} + xy + y^{2} $在$ (1,1) $处的梯度为$ \lbrack 3,3\rbrack $。

在函数的极小值、极大值和鞍点处,梯度为0。
需要注意的是,梯度代表的其实是函数值增大最快的方向;在实际应用中,我们需要寻找损失函数的最小值,所以一般选择负梯度向量。同样地,负梯度代表的是函数值减小最快的方向,并不一定直接指向函数图像的最低点。
利用数值微分,在代码中实现梯度的计算:
def _numerical_gradient(f, x):
    h = 1e-4
    grad = np.zeros_like(x)  # 生成x的形状相同,全为0的向量
    # 遍历向量x中的特征xi
    for i in range(len(x)):
        xi = x[i]
        x[i] = xi + h
        fxh1 = f(x)  # 这里意为计算交叉熵误差
        x[i] = xi - h
        fxh2 = f(x)
        x[i] = xi
        # 利用中心差公式计算偏导数,即求导数,找出梯度下降最大方向,即损失函数最小的方向
        grad[i] = (fxh1 - fxh2) / (2 * h)
        # 恢复x向量的值
        x[i] = xi
    return grad
神经网络的梯度计算
在神经网络的学习中,梯度的计算非常重要。神经网络中的梯度,指的就是损失函数关于权重参数的梯度。
我们以一个单层的简单网络为例,形状为 2×3,权重参数为 W,损失函数记为 L。那么它的权重参数和梯度为:
$ W = \begin{pmatrix}
w_{11} & w_{12} & w_{13} \
w_{21} & w_{22} & w_{23}
\end{pmatrix} $
$ \frac{\partial L}{\partial W} = \begin{pmatrix}
\frac{\partial L}{\partial w_{11}} & \frac{\partial L}{\partial w_{12}} & \frac{\partial L}{\partial w_{13}} \
\frac{\partial L}{\partial w_{21}} & \frac{\partial L}{\partial w_{22}} & \frac{\partial L}{\partial w_{23}}
\end{pmatrix} $
这里,梯度 $ \frac{\partial L}{\partial W} $也是一个 2×3 的矩阵,其中各个元素由_L_关于_W_中各元素的偏导数构成。
计算这个简单网络的梯度,可以用代码实现如下:
# 定义一个简单神经网络类
class SimpleNet:
    def __init__(self):
        self.W = np.random.randn(2,3)
    # 前向传播
    def forward(self, x):
        a = np.dot(x, self.W)
        y = softmax(a) # softmax为上文实现的函数
        return y
    # 损失函数
    def loss(self, x, t):
        y = self.forward(x)
        return cross_entropy(y, t) # cross_entropy为上文实现的函数

x = np.array([0.6, 0.9])
t = np.array([0, 0, 1])

net = SimpleNet()

f = lambda w: net.loss(x, t)
dW = numerical_gradient(f, net.W) # numerical_gradient为上文实现的函数

print(dW)
随机梯度下降法(SGD)
梯度下降法
梯度下降法(Gradient Descent)是一种用于最小化目标函数的迭代优化算法。核心是沿着目标函数(如损失函数)的负梯度方向逐步调整参数,从而逼近函数的最小值。梯度方向指示了函数增长最快的方向,因此负梯度方向是函数下降最快的方向。
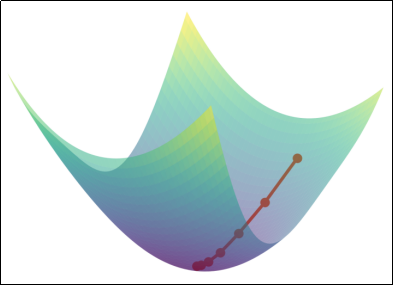
具体来说,我们初始找到函数 f(x1,x2) 的一个点 (x1,x2),按下式进行更新:
$ x_{1}' = x_{1} - \eta\frac{\partial f}{\partial x_{1}} $
$ x_{2}' = x_{2} - \eta\frac{\partial f}{\partial x_{2}} $
这样就可以沿着负梯度方向,找到一个新的点$ {\ (x}{1}',\ x{2}')\ $,让函数值更小。
这里的 η 表示每次的更新量,在神经网络的学习过程中,就代表了一次学习的步长(一次学习多少、多大程度去更新参数),称为学习率(learning rate)。学习率需要预先设定好,过大或过小都会导致学习效果不佳。
梯度下降法可以代码实现如下:
# 定义梯度下降法函数
def gradient_descent(f, init_x, lr=0.01, step_num=100):
    x = init_x
    # 定义列表保存梯度下降过程中每一步的参数x
    x_history = []
    # 循环迭代进行梯度下降
    for i in range(step_num):
        x_history.append(x.copy())
        # 计算梯度
        grad = numerical_gradient(f, x)
        # 更新参数x
        x -= lr * grad
    return x, np.array(x_history)
模型训练相关概念
Epoch
1个 Epoch 表示模型完整遍历一次整个训练数据集的过程。例如,训练10个 Epoch 表示模型将整个数据集反复学习 10 次。
模型需要多次遍历数据集(多个Epoch)才能逐步学习数据中的模式,单次遍历数据集(1个Epoch)通常不足以让模型收敛,多次遍历可以逐步优化模型数。
Batch Size
Batch Size 是每次训练时输入的样本数量。例如,Batch Size=32 表示每次用32个样本计算一次梯度并更新模型参数。
小批量数据计算梯度比单样本(Batch Size=1)更稳定,比全批量(Batch
Size=全体数据)更高效。并且较小的Batch Size 可能带来更多噪声,有助于模型泛化。
Iteration
一次Iteration表示完成一个Batch数据的正向传播(预测)和反向传播(更新参数)的过程。
例如,数据集现有2000个样本,对其训练10个Epoch,选择 Batch Size=64:Batch个数为 2000\64+1=31+1=32个(最后一个Batch仅有16个样本)。
每个 Epoch 中迭代次数 Itreation=32 次。
总迭代次数为 10×32=320 次。
总训练样本数为 10×2000=20000。
SGD
在神经网络的学习过程中,可以使用梯度下降法来更新参数,目标就是减小损失函数的值。
实际操作时,一般会从训练数据中随机选择一个小批量数据(mini-batch),然后用梯度下降法迭代多个轮次(iteration);这种"对随机选择的数据进行的梯度下降法",被称作随机梯度下降法(stochastic gradient descent,SGD)。
具体过程如下:
- 随机选择批数据(mini-batch):从训练数据中随机选出一部分数据,学习的目标就是要减少这个mini-batch数据的损失函数值。
- 计算梯度:对当前的各权重参数,计算出梯度的值,负梯度就表示了损失函数减小最多的方向。
- 更新参数:按照梯度下降法的公式,对权重参数沿负梯度方向进行微小更新。
- 重复迭代:重复上面的步骤 ,直到完成预定的总迭代次数。
综合代码实现:手写数字识别
针对上面手写数字识别的案例。实现一个2层的神经网络(中间只有1个隐藏层、后面是输出层),利用之前的数据集来进行学习,学习方法采用 SGD。
首先实现 TwoLayerNet 类:
class TwoLayerNet:
    """
    两层神经网络
    """

    def __init__(self, input_size, hidden_size, output_size, weight_init_std=0.01):
        """
        初始化:针对权重矩阵W和偏置项b都使用随机的方式初始化,用于后期训练调整
        """
        self.params = {}
        self.params['W1'] = weight_init_std * np.random.randn(input_size, hidden_size) # 生成一个服从标准正态分布(均值为0,标准差为1)的随机矩阵,形状为 (input_size, hidden_size)
        self.params['b1'] = np.zeros(hidden_size)
        self.params['W2'] = weight_init_std * np.random.randn(hidden_size, output_size)
        self.params['b2'] = np.zeros(output_size)

    def forward(self, x):
        """
        前向传播预测结果
        """
        W1, W2 = self.params['W1'], self.params['W2']
        b1, b2 = self.params['b1'], self.params['b2']
        a1 = np.dot(x, W1) + b1
        z1 = sigmoid(a1)
        a2 = np.dot(z1, W2) + b2
        y = softmax(a2)
        return y

    def loss(self, x, t):
        """
        计算损失:x:输入数据, t:监督数据
        """
        y = self.forward(x)
        return cross_entropy(y, t)

    def accuracy(self, x, t):
        """
        计算准确率
        """
        y = self.predict(x)
        y = np.argmax(y, axis=1)
        t = np.argmax(t, axis=1)
        accuracy = np.sum(y == t) / float(x.shape[0])
        return accuracy

    def numerical_gradient(self, x, t):
        """
        数值微分计算梯度
        """
        loss_W = lambda W: self.loss(x, t) # 一个匿名函数 loss_W,它接受一个参数矩阵 W,并返回调用 self.loss(x, t) 的结果
        grads = {}
        # 遍历所有参数,计算梯度,并保存在 grads 中,key 为参数名,value 为梯度
        grads['W1'] = numerical_gradient(loss_W, self.params['W1'])
        grads['b1'] = numerical_gradient(loss_W, self.params['b1'])
        grads['W2'] = numerical_gradient(loss_W, self.params['W2'])
        grads['b2'] = numerical_gradient(loss_W, self.params['b2'])
        return grads
获取数据方法:
def get_data():
    # 1. 从文件加载数据集
    data = pd.read_csv("../data/train.csv")
    # 2. 划分数据集
    X = data.drop("label", axis=1)
    y = data["label"]
    x_train, x_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
    # 3. 特征工程:归一化
    scaler = MinMaxScaler()
    x_train = scaler.fit_transform(x_train)
    x_test = scaler.transform(x_test)
    # 4. 将数据都转成ndarray
    y_train = y_train.values
    y_test = y_test.values

    return x_train, x_test, y_train, y_test
然后利用 SGD 进行训练:
import numpy as np
import matplotlib.pyplot as plt
from two_layer_net import TwoLayerNet

# 读入数据
x_train, x_test, t_train, t_test = get_data ()
# 创建一个二层神经网络
network = TwoLayerNet(input_size=784, hidden_size=50, output_size=10)

# 设置超参数
iters_num = 10000  # 适当设定循环的次数
train_size = x_train.shape[0]
batch_size = 100 # 批量大小
learning_rate = 0.1 # 学习率

train_loss_list = [] # 损失值列表
train_acc_list = [] # 训练集准确率列表
test_acc_list = [] # 测试集准确率列表

iter_per_epoch = max(train_size / batch_size, 1) # 一个epoch的迭代次数
for i in range(iters_num):
    batch_mask = np.random.choice(train_size, batch_size) # 从 [0, train_size) 范围内随机选择 batch_size 个不重复的索引
    # print(batch_mask)
    x_batch = x_train[batch_mask]# 获取批量数据
    t_batch = t_train[batch_mask]
    # 计算梯度
    grads = network.numerical_gradient(x_batch, t_batch)

    # 更新参数
    for key in ('W1', 'b1', 'W2', 'b2'): # 遍历所有参数更新其值
        network.params[key] -= learning_rate * grads[key]
    loss = network.loss(x_batch, t_batch)
    train_loss_list.append(loss)

    if i % iter_per_epoch == 0:
        train_acc = network.accuracy(x_train, t_train)
        test_acc = network.accuracy(x_test, t_test)
        train_acc_list.append(train_acc)
        test_acc_list.append(test_acc)
        print("train acc, test acc | " + str(train_acc) + ", " + str(test_acc))

# 绘制图形
markers = {'train': 'o', 'test': 's'}
x = np.arange(len(train_acc_list))
plt.plot(x, train_acc_list, label='train acc')
plt.plot(x, test_acc_list, label='test acc', linestyle='--')
plt.xlabel("epochs")
plt.ylabel("accuracy")
plt.ylim(0, 1.0)
plt.legend(loc='lower right')
plt.show()
时间复杂度分析:
上述代码中,使用数值微分来计算梯度虽然简单直接,但效率非常低,特别是在处理大型神经网络时。
假设神经网络中有 ( n ) 个可学习参数。对于每一个这样的参数,都需要进行两次前向传播来估算其梯度。因此,如果我们对所有 ( n ) 个参数都这样做,总共需要进行 ( 2n ) 次前向传播。如果每次前向传播的时间复杂度为 ( T ),那么总的计算时间复杂度将是 ( O(2nT) = O(nT) )。
然而,在实际讨论中,人们往往简化地认为整个过程的时间复杂度为 ( O(n^2) )。这是因为当考虑整个优化过程时,每一步迭代不仅涉及了对每个参数的梯度估计,还可能包括其他操作如梯度下降步骤等。此外,( T ) 本身可能依赖于 ( n ) 或者输入数据量等因素,使得总时间成本呈现出二次增长的趋势。
总之,虽然数值微分提供了一种简单直观的方式来估计梯度,但它确实效率低下,特别是在处理具有大量参数的大规模神经网络时。
第四章 反向传播算法
反向传播(Backpropagation,BP)是神经网络训练中用于高效计算损失函数对各层参数(权重 w、偏置 b)梯度的核心算法。它通过链式法则将输出层的误差逐层反向传递到输入层,最终得到所有参数的梯度,为参数更新(如梯度下降)提供依据。
计算图
计算图将计算过程用图表示出来。这里说的图是数据结构中的图,通过多个节点和边表示(连接节点的直线称为边)。

如上就是 $ 100 \times 2 + 150 \times 3 = 650\ $的计算图表示。
计算图的基本计算原则,就是从输入出发、按照箭头方向,从左到右依次进行计算,最终得到输出结果。这个过程,其实就是前向传播(forward)。
计算图的特点是可以通过传递"局部计算"获得最终结果。即只需根据与自己相关的信息输出接下来的结果。无论全局的计算有多么复杂,各个节点所要做的就是进行局部计算并传递计算结果,最终得出全局的复杂计算的结果。
如果增加更多的计算环节,比如再乘以一个"零售加价系数",计算图如下所示。
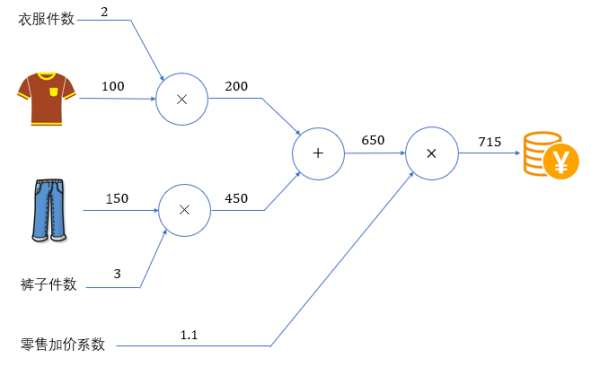
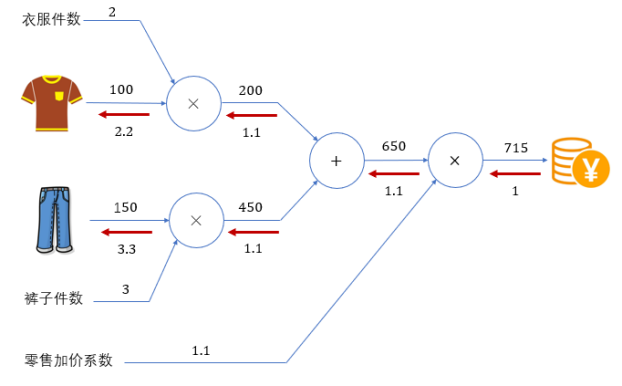
如果我们进一步考虑,当衣服的价格上涨(输入变化)时,会多大程度上影响最后要支付的金额(输出结果)?
将输入的衣服价格记为_x_,输出的支付金额记为_L_,这其实就是要求导数值$ \frac{\partial L}{\partial x}\ $。在计算图上,我们可以利用反向(从右到左)的传递来方便地计算导数。这个过程,就可以叫做反向传播(backward)。

链式法则
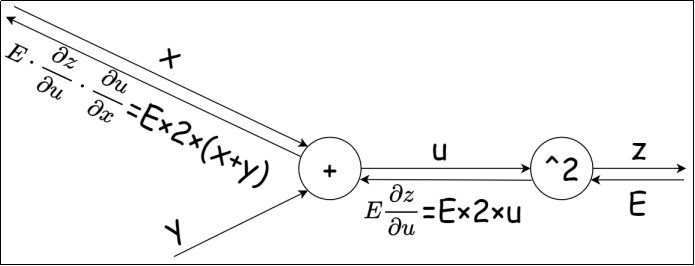
反向传播将局部导数向反方向传递,传递的原理基于链式法则。反向传播时将信号乘以节点的局部导数然后传递给下一个节点。核心是:下游梯度 = 上游梯度 $ \times $ 局部梯度。

对于复合函数$ \ z = (x + y)^{2} $,令$ \ u = x + y $,则
$ \frac{\partial z}{\partial x} = \frac{\partial z}{\partial u}\frac{\partial u}{\partial x} = 2u \times 1 = 2(x + y) $
现用计算图表示:
反向传播
利用计算图的反向传播,可以很容易地计算出输出关于输入的偏导数。
反向传播底层逻辑是:一次前向传播算出结果,一次反向传播算出所有梯度。每一层计算出的梯度都会被前一层复用。
假设一个三层串联的网络结构:$ x \xrightarrow{w_1} a \xrightarrow{w_2} b \xrightarrow{w_3} L $
其中:
- $ a = x \cdot w_1 $
- $ b = a \cdot w_2 $
- $ L = b \cdot w_3 $ (假设 $ L $ 是最终的损失)
目标是求出 $ L $ 对三个参数 $ w_1, w_2, w_3 $ 的梯度。
首先,独立地求每一个梯度,公式如下:
- 对 $ w_3 $ 求导: $ \frac{\partial L}{\partial w_3} = b $
- 对 $ w_2 $ 求导: $ \frac{\partial L}{\partial w_2} = \frac{\partial L}{\partial b} \cdot \frac{\partial b}{\partial w_2} $
- 对 $ w_1 $ 求导: $ \frac{\partial L}{\partial w_1} = \frac{\partial L}{\partial b} \cdot \frac{\partial b}{\partial a} \cdot \frac{\partial a}{\partial w_1} $
其中:
- 计算 $ w_2 $ 的梯度时,需要用到 $ \frac{\partial L}{\partial b} $。
- 计算 $ w_1 $ 的梯度时,也需要用到 $ \frac{\partial L}{\partial b} $,并且还需要用到 $ \frac{\partial b}{\partial a} $。
反向传播的执行逻辑(从后往前):
- **** 计算并存储 $ \delta_3 = \frac{\partial L}{\partial b} = w_3 $。
- 此时,$ w_3 $ 的梯度直接算出:$ Grad_{w_3} = \delta_3 \cdot b $。
- 计算并存储 $ \delta_2 = \delta_3 \cdot \frac{\partial b}{\partial a} = w_3 \cdot w_2 $。
- 复用了 $ \delta_3 $。此时,$ w_2 $ 的梯度直接算出:$ Grad_{w_2} = \delta_3 \cdot a $。
- 计算 $ \delta_1 = \delta_2 \cdot \frac{\partial a}{\partial x} = (w_3 \cdot w_2) \cdot w_1 $。
- 复用了 $ \delta_2 $(而 $ \delta_2 $ 已经包含了 $ \delta_3 $)。此时,$ w_1 $ 的梯度直接算出:$ Grad_{w_1} = \delta_2 \cdot x $。
如果用先前的数值微分:
- 为了求 $ w_1 $ 的梯度,要走一遍完整的 $ x \to a \to b \to L $。
- 为了求 $ w_2 $ 的梯度,还要走一遍完整的 $ x \to a \to b \to L $。
- ...以此类推。
- 每一层的计算都是孤立的,没有任何信息共享。在大量参数的情况下,时间复杂度爆炸。
加法节点的反向传播
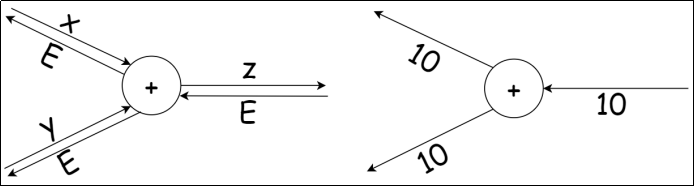
对于$ z = x + y $,$ \frac{\partial z}{\partial x} = 1 $,$ \frac{\partial z}{\partial y} = 1 $。因此加法的反向传播会将上游传来的值原样向下游传递。
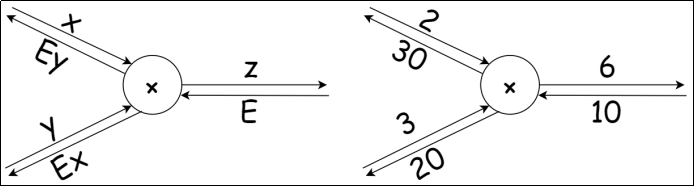
乘法节点的反向传播
对于$ z = xy $,$ \frac{\partial z}{\partial x} = y $,$ \frac{\partial z}{\partial y} = x $。因此乘法的反向传播会将上游传来的值乘以输入的翻转向下游传递。
激活层的反向传播和实现
现在将计算图应用到神经网络中。神经网络中一步重要的计算操作就是激活函数,下面就来讨论各种激活函数的反向传播,基于这些我们就可以用代码实现激活层的完整功能了。
ReLU 的反向传播
对于 ReLU 函数:
$ f(x) = \max(0,x) = \ \left{ \begin{array}{r}
0,x \leq 0 \
x,x > 0
\end{array} \right.\ $
其导数为:
$ f^{'(x)} = \left{ \begin{array}{r}
0,x \leq 0 \
1,x > 0
\end{array} \right.\ $
分为 $ x \leq 0 $ 和 $ x > 0 $ 两种情况分别讨论,反向传播的计算图如下:
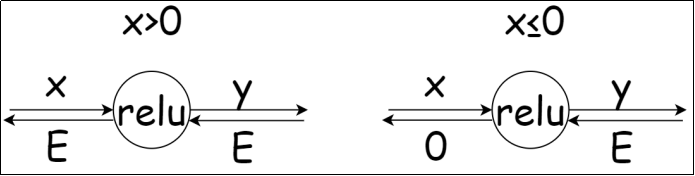
ReLU 层可以在代码中实现为一个类 Relu:
class ReLU:
    # 初始化
    def __init__(self):
        # 内部属性,记录哪些x<=0
        self.mask = None
    # 前向传播
    def forward(self, x):
        self.mask = (x <= 0) # x<=0的索引值为true
        y = x.copy() # 创建一个和x相同的数组
        # 将x<=0的值设为0
        y[self.mask] = 0 # 索引为true的元素设为0
        return y
    # 反向传播
    def backward(self, dy):
        dx = dy.copy()
        dx[self.mask] = 0 # 索引为true的元素设为0
        return dx
Sigmoid 的反向传播
对于 Sigmoid 函数:
$ f(x) = \frac{1}{1 + e^{- x}} $
其导数为:
$ f'(x) = - \left( \frac{1}{1 + e^{- x}} \right)^{2} \cdot e^{- x} \cdot ( - 1) = \frac{e^{- x}}{\left( {1 + e}^{- x} \right)^{2}} $
$ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ = \frac{1}{1 + e^{- x}}\left( 1 - \frac{1}{1 + e^{- x}} \right) $
$ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ = f(x)\left( 1 - f(x) \right) $
利用计算图的反向传播,也可以得到相同的结果:
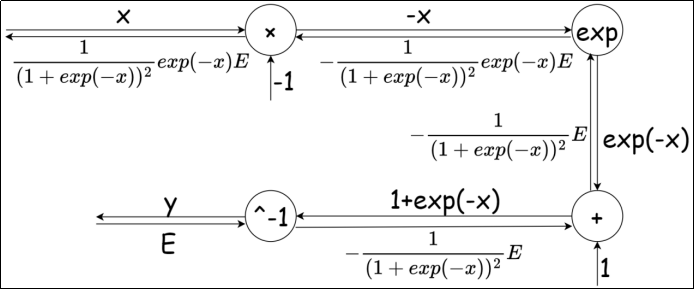
图中假设最终输出的损失对 $ y $ 的梯度为 $ E $。其详细步骤为:
- 倒数节点 ($ ^{-1} $)
+ 前向:$ f(u) = \frac{1}{u} $,其中 $ u = 1 + e^{-x} $。
+ 局部梯度:$ \frac{df}{du} = -\frac{1}{u^2} $。
+ 反向: 传回的梯度为 $ E \cdot \left( -\frac{1}{(1 + e^{-x})^2} \right) $。 - 加法节点 ($ + $)
+ 前向: 将 $ e^{-x} $ 与常数 $ 1 $ 相加。
+ 局部梯度: 加法对任一输入的导数均为 $ 1 $。
+ 反向: 梯度直接传递,保持为 $ -\frac{1}{(1 + e^{-x})^2}E $。 - 指数节点 ($ \exp $)
+ 前向: 计算 $ e^v $,其中 $ v = -x $。
+ 局部梯度:$ \frac{d(e^v)}{dv} = e^v = e^{-x} $。
+ 反向: 梯度变为 $ -\frac{1}{(1 + e^{-x})^2}E \cdot e^{-x} $。 - 乘法节点 ($ \times $)
+ 前向: 将 $ x $ 与常数 $ -1 $ 相乘。
+ 局部梯度: 对于变量 $ x $,导数是常数系数 $ -1 $。
+ 反向: 最终对 $ x $ 的梯度为:$ \frac{\partial L}{\partial x} = \left( -\frac{e^{-x}}{(1 + e^{-x})^2} \right) \cdot (-1) \cdot E = \frac{e^{-x}}{(1 + e^{-x})^2}E $
简化得:
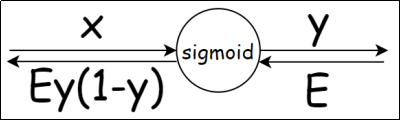

Sigmoid 层可以在代码中实现为一个类 Sigmoid:
class Sigmoid:
    # 创建一个Sigmoid对象
    def __init__(self):
        # 创建一个内部属性,记录输出值y,用于反向传播时计算梯度
        self.y = None
    # 前向传播
    def forward(self, x):
        y = sigmoid(x)
        self.y = y
        return y
    # 反向传播
    def backward(self, dy):
        dx = dy * (1.0 - self.y) * self.y # 梯度计算
        return dx
Affine 的反向传播和实现
在全连接层(Fully Connected Layer,Dense Layer)中,每个输入节点与输出节点相连,通过权重矩阵和偏置进行线性变换,这种操作在几何领域称为仿射变换(Affine transformation)。几何中,仿射变换包括一次线性变换和一次平移,分别对应神经网络的加权求和运算与加偏置运算。
考虑 N 个数据一起进行正向传播的情况,写成矩阵计算形式:
$ Y = XW + B $
这里的_X_是形状为N×m的矩阵,m就是Affine层输入神经元的个数;而_W_是形状为m×n的权重矩阵,n就是Affine层输出神经元的个数。
根据矩阵求导的运算法则,可以得到损失函数_L_关于_X_、_W_的偏导数:
$ \frac{\partial L}{\partial X} = \frac{\partial L}{\partial Y}\ \cdot \ W^{T} $
$ \frac{\partial L}{\partial W} = X^{T} \cdot \ \frac{\partial L}{\partial Y}\ $
用计算图的反向传播计算如下:

这里令$ E = \frac{\partial L}{\partial Y} $,需要注意矩阵的形状要满足矩阵乘法的要求。
Affine层可以在代码中实现为一个类 Affine:
class Affine:
    # 创建一个仿射层对象
    def __init__(self, W, b):
        self.W = W
        self.b = b
        # 输入数据X做保存,方便反向传播计算梯度
        self.X = None
        self.original_x_shape = None
        # 将权重和偏置参数的梯度(偏导数)保存成属性,方便梯度极端
        self.dW = None
        self.db = None
    # 前向传播
    def forward(self, X):
        self.original_x_shape = X.shape
        self.X = X.reshape(X.shape[0], -1)
        y = np.dot(self.X, self.W) + self.b
        return y
    # 反向传播
    def backward(self, dy):
        dX = np.dot(dy, self.W.T)
        dX = dX.reshape(*self.original_x_shape)  # 还原输入数据的形状(对应张量)
        self.dW = np.dot(self.X.T, dy)
        self.db = np.sum(dy, axis=0)
        return dX
输出层的反向传播和实现
在输出层,我们一般使用Softmax作为激活函数。
对于Softmax函数:
$ y_{k} = \frac{e^{x_{k}}}{\sum_{i = 1}^{n}e^{x_{i}}},\ \ k = 1\sim n $
其偏导数为:
$ \frac{\partial y_{k}}{\partial x_{i}} = \left{ \begin{array}{r}
y_{k}\left( 1 - y_{i} \right),k = i \
- y_{k}y_{i},k \neq i
\end{array} \right.\ $
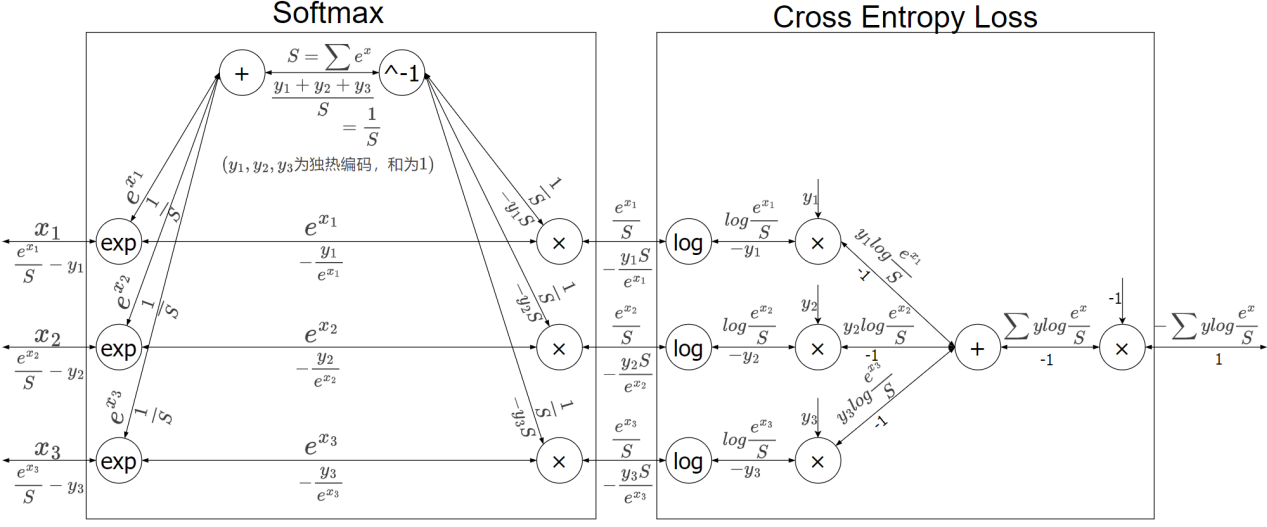
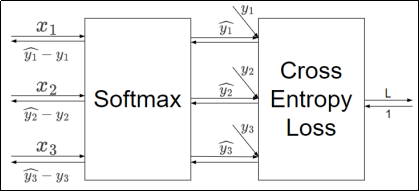
而对于输出层,一般会直接将结果代入损失函数的计算。对于之前介绍的分类问题,这里选择交叉熵误差(Cross Entropy Error)作为损失函数,就可以得到一个 Softmax-with-Loss 层,它包含了 Softmax 和 Cross Entropy Loss 两部分。
导数的计算会比较复杂,可以用计算图表示如下:
简化得:
在代码中可以实现为一个类 SoftmaxWithLoss:
# SoftmaxWithLoss层 - 结合Softmax激活和交叉熵损失
# 用于多分类问题的输出层
class SoftmaxWithLoss:
    # 创建一个SoftmaxWithLoss对象
    def __init__(self):
        self.loss = None      # 存储计算的损失值
        self.y = None         # 存储softmax输出的概率分布
        self.t = None         # 存储真实标签
    # 前向传播:计算softmax概率和交叉熵损失
    def forward(self, X, t):
        self.t = t                    # 保存真实标签
        self.y = softmax(X)           # 计算softmax概率分布
        self.loss = cross_entropy(self.y, self.t)  # 计算交叉熵损失
        return self.loss              # 返回损失值
    # 反向传播:计算损失函数对输入的梯度
    # 返回梯度∇L/∂y = (y-t)/N,指示损失减小最快的方向
    def backward(self, dy=1):
        batch_size = self.t.shape[0]  # 获取批次大小

        # 如果是独热编码的标签,直接使用公式∇L/∂y = y - t
        if self.t.size == self.y.size:  # size表示数组元素个数
            dx = self.y - self.t

        # 如果是顺序编码的标签,需要找到对应位置进行计算
        else:
            dx = self.y.copy()  # 复制softmax输出作为初始梯度
            # 具体例子:batch_size=3, self.t=[1,0,2], self.y=[[0.2,0.7,0.1],[0.8,0.1,0.1],[0.1,0.2,0.7]]
            # 执行dx[np.arange(3), [1,0,2]] -= 1
            # 即:dx[0,1]-=1, dx[1,0]-=1, dx[2,2]-=1
            # 结果:dx=[[0.2,-0.3,0.1],[-0.2,0.1,0.1],[0.1,0.2,-0.3]]
            # 这相当于将顺序编码转换为稀疏的one-hot形式进行计算
            dx[np.arange(batch_size), self.t] -= 1
        return dx / batch_size  # 返回平均梯度
反向传播优化 SGD
现在可以在之前手写数字识别案例的基础上,对 SGD 的计算过程进行优化。核心就是使用误差的反向传播法来计算梯度,而不是使用差分数值计算;这将大大提升学习的效率。
对于二层网络 TwoLayerNet,隐藏层由一个 Affine 层和一个 ReLU 层组成,输出层则由一个 Affine 层和一个 Softmax-with-Loss 层组成。由于之前已经实现了各层的类,现在只要用"搭积木"的方式将它们拼接在一起就可以了。
将 TwoLayerNet 类改进为使用反向传播计算梯度:
from common.gradient import numerical_gradient
from common.layers import *
from collections import OrderedDict     # 有序字典,用来保存层结构

class TwoLayerNet:
    def __init__(self, input_size, hidden_size, output_size, weight_init_std=0.01):
        """
        初始化:针对权重矩阵W和偏置项b都使用随机的方式初始化,用于后期训练调整
        """
        self.params = {}
        self.params['W1'] = weight_init_std * np.random.randn(input_size, hidden_size) # 生成一个服从标准正态分布(均值为0,标准差为1)的随机矩阵,形状为 (input_size, hidden_size)
        self.params['b1'] = np.zeros(hidden_size)
        self.params['W2'] = weight_init_std * np.random.randn(hidden_size, output_size)
        self.params['b2'] = np.zeros(output_size)
        # 定义层结构
        self.layers = OrderedDict()
        self.layers['Affine1'] = Affine(self.params['W1'], self.params['b1'])
        self.layers['Relu1'] = ReLU()
        self.layers['Affine2'] = Affine(self.params['W2'], self.params['b2'])
        # 单独定义SoftmaxWithLoss层
        self.lastLayer = SoftmaxWithLoss()

    def forward(self, X):
        """
        前向传播
        """
        for layer in self.layers.values():
            X = layer.forward(X)
        return X

    def loss(self, x, t):
        """
        计算损失:x:输入数据, t:监督数据
        """
        y = self.forward(x)
        loss_value = self.lastLayer.forward(y, t)
        return loss_value

    def accuracy(self, x, t):
        """
        计算准确率
        """
        y_pred = self.forward(x) # 预测分类数值
        # 根据最大概率得到预测的分类号
        y = np.argmax(y_pred, axis=1)
        # 与正确解标签对比,得到准确率
        accuracy = np.sum(y == t) / x.shape[0]
        return accuracy

    def gradient(self, x, t):
        # 先做一次前向传播,直到计算损失
        self.loss(x, t)
        # 反向传播
        dy = 1
        dy = self.lastLayer.backward(dy)
        # 将神经网络中的所有层翻转处理
        layers = list(self.layers.values())
        layers.reverse()
        for layer in layers:
            dy = layer.backward(dy)
        # 提取各层参数的梯度
        grads = {}
        grads['W1'], grads['b1'] = self.layers['Affine1'].dW, self.layers['Affine1'].db
        grads['W2'], grads['b2'] = self.layers['Affine2'].dW, self.layers['Affine2'].db
        return grads
接下来的训练过程与之前相同,只需将 numerical_gradient 替换为 gradient 即可。代码如下:
import matplotlib.pyplot as plt

from common.load_data import get_data
from common.functions import *
from two_layer_net_bp import TwoLayerNet

# 读入数据
x_train, x_test, t_train, t_test = get_data ()
# 创建一个二层神经网络
network = TwoLayerNet(input_size=784, hidden_size=50, output_size=10)

# 设置超参数
iters_num = 10000   # 适当设定循环的次数
train_size = x_train.shape[0]
batch_size = 100 # 批量大小
learning_rate = 0.1 # 学习率

train_loss_list = [] # 损失值列表
train_acc_list = [] # 训练集准确率列表
test_acc_list = [] # 测试集准确率列表

iter_per_epoch = max(train_size / batch_size, 1) # 一个epoch的迭代次数
# 随机梯度下降(SGD)训练过程。每次循环都会:
# 1. 随机选择一批新的数据 (batch_mask)
# 2. 对这批数据执行一次前向传播和反向传播 (grads = network.gradient(x_batch, t_batch))
# 3. 使用计算出的梯度更新网络参数
# 4. 继续下一轮循环
for i in range(iters_num):
    batch_mask = np.random.choice(train_size, batch_size) # 从 [0, train_size) 范围内随机选择 batch_size 个不重复的索引
    # print(batch_mask)
    x_batch = x_train[batch_mask]# 获取批量数据
    t_batch = t_train[batch_mask]
    # 计算梯度
    # grads = network.numerical_gradient(x_batch, t_batch) # 数值微分法
    grads = network.gradient(x_batch, t_batch) # 反向传播法

    # 更新参数
    for key in ('W1', 'b1', 'W2', 'b2'): # 遍历所有参数更新其值
        network.params[key] -= learning_rate * grads[key]
    loss = network.loss(x_batch, t_batch)
    train_loss_list.append(loss)

    if i % iter_per_epoch == 0:
        train_acc = network.accuracy(x_train, t_train)
        test_acc = network.accuracy(x_test, t_test)
        train_acc_list.append(train_acc)
        test_acc_list.append(test_acc)
        print("train acc, test acc | " + str(train_acc) + ", " + str(test_acc))

# 绘制图形
markers = {'train': 'o', 'test': 's'}
x = np.arange(len(train_acc_list))
plt.plot(x, train_acc_list, label='train acc')
plt.plot(x, test_acc_list, label='test acc', linestyle='--')
plt.xlabel("epochs")
plt.ylabel("accuracy")
plt.ylim(0, 1.0)
plt.legend(loc='lower right')
plt.show()
第六章 学习的技巧
深度神经网络及其问题
深度学习
当神经网络的层数加深时,往往可以有效地提高识别精度;特别是对于大规模的复杂问题,通常都需要用更多的层来分层次传递信息,而且可以有效减少网络的参数数量,从而使得学习更加高效。
深层网络能够逐层学习从低级到高级的抽象特征(如从边缘→纹理→部件→整体),这种层次化表示是深度学习优势的重要来源。使用深度神经网络进行的学习就被称为深度学习(Deep Learning)。
ILSVRC 是近年来机器视觉领域最受追捧且最具权威的学术竞赛之一,代表了图像领域的最高水平。它包含多个测试项目,其中最有名的就是"类别分类"(Classification),该项目会进行 1000 个类别的分类,比试识别精度。自从 2012 年以后的 ILSVRC 比赛,优胜队伍采用的方法基本上都是以深度学习为基础的。
可以说,深度学习代表了目前人工智能领域的发展方向,正以超乎想象的速度发展并改变我们的生活。
梯度消失和梯度爆炸
在某些神经网络中,随着网络深度的增加,梯度在隐藏层反向传播时倾向于变小。这就意味着,前面隐藏层中的神经元要比后面的学习起来更慢。这种现象被称为"梯度消失"。
与之对应,如果我们进行一些特殊的调整(比如初始权重很大),可以让梯度反向传播时不会明显减小,从而解决梯度消失的问题;然而这样一来,前面层的梯度又会变得非常大,引起网络不稳定,无法再从训练数据中学习。这种现象被称为"梯度爆炸"。
基于梯度学习的深度神经网络中,梯度本身是不稳定的,前面层中的梯度可能"消失",也可能"爆炸"。
对于梯度消失和梯度爆炸,一个容易理解的解释是:当反向传播进行很多层的时候,每一层都对前一层梯度乘以了一个系数;因此当这个系数比较小(小于1)时,越往前传递,梯度就会越小、训练越慢,导致梯度消失;而如果这个系数比较大,则越往前传递梯度就会越大,导致梯度爆炸。Sigmoid 的导数最大为 0.25,多层连乘后极易导致梯度消失;ReLU 在正值区导数为 1,能缓解这一问题,但不当的初始化仍可能引发梯度爆炸。
所以,深度神经网络的训练是比较复杂的,会有一系列的问题。研究表明,激活函数的选择、权重的初始化,甚至学习算法的实现方式都是影响因素;另外,网络的架构和其它一些超参数也有重要影响。
为了让深度神经网络的学习更加稳定、高效,我们需要考虑进一步改进寻找最优参数的方法,以及如何设置参数初始值、如何设定超参数;此外还应该解决过拟合的问题。
更新参数方法的优化
对于深度神经网络的学习,之前更新参数的方法是随机梯度下降法(SGD)。这种方法比较简单,也非常经典,但在很多具体问题中并不是最高效的。
SGD 的缺点
SGD的更新方式可以写为:
$ W \leftarrow W - \eta\frac{\partial L}{\partial W} $
这里 W 是要更新的权重参数(矩阵),损失函数L关于W的梯度就是$ \frac{\partial L}{\partial W} $ ;而 _η _表示 学习率。
我们可以将SGD单独包装成一个类:
# SGD
class SGD:
    def __init__(self, lr=0.01):
        """
        初始化参数
        :param lr: 学习率
        """
        self.lr = lr
    def update(self, params, grads):
        """
        参数更新
        :param params: 模型参数
        :param grads: 梯度
        :return:
        """
        for key in params.keys():
            params[key] -= self.lr * grads[key]
SGD有以下问题:
- 局部最优解:陷入局部最优,尤其在非凸函数中,难以找到全局最优解。
- 鞍点:在高维空间中,梯度为 0 的点多为鞍点(沿某些方向为极小、沿另一些方向为极大),SGD 容易在此停滞。
- 收敛速度慢:高维或非凸函数中,收敛速度较慢。
- 学习率选择:学习率过大导致震荡或不收敛,过小则收敛速度慢。

Momentum
原始的梯度下降法直接使用当前梯度来更新参数:
$ W \leftarrow W - \eta\nabla $
而 Momentum(动量法)会保存历史梯度并给予一定的权重,使其也参与到参数更新中:
$ v \leftarrow \alpha v - \eta\nabla $
$ W \leftarrow W + v $
- $ v $:历史(负)梯度的加权和
- $ \alpha $:历史梯度的权重
- $ \nabla $:当前梯度,即$ \ \frac{\partial L}{\partial W} $
- $ \eta $:学习率
动量法有时能够减缓优化过程中的震荡,加快优化的速度。因为其会累计历史梯度,也可以有效避免鞍点问题。α 常取 0.9 或 0.99,表示历史梯度在更新中的保留比例。
对比 SGD:


Momentum 的代码实现如下:
# 动量法
class Momentum:
    def __init__(self, lr=0.01, momentum=0.9):
        """
        初始化参数
        :param lr: 学习率
        :param momentum: 动量因子
        """
        self.lr = lr
        self.momentum = momentum
        self.v = None  # 历史负梯度的加权和

    def update(self, params, grads):
        """
        参数更新
        :param params: 模型参数
        :param grads: 梯度
        :return:
        """
        if self.v is None:
            self.v = {}
            for key, val in params.items():
                self.v[key] = np.zeros_like(val)
        for key in params.keys():
            self.v[key] = self.momentum * self.v[key] - self.lr * grads[key]
            params[key] += self.v[key]
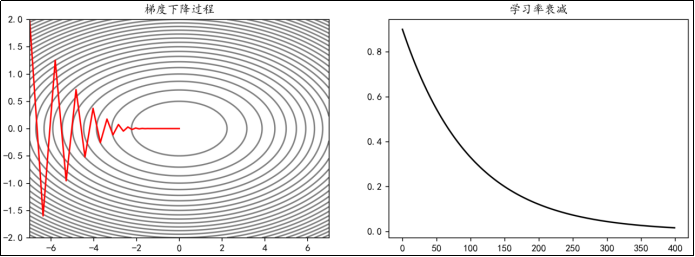
学习率衰减
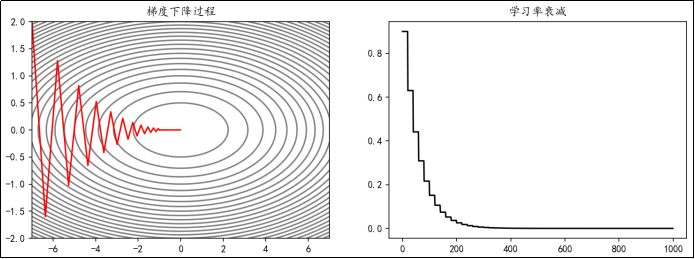
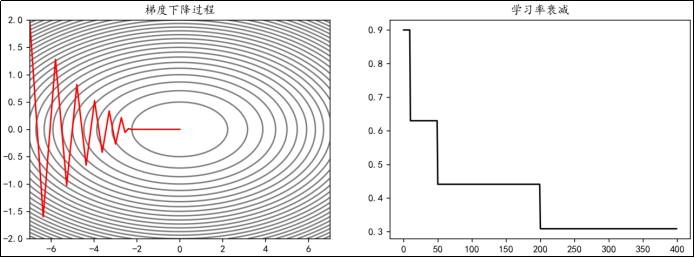
深度学习模型训练中调整最频繁的当属学习率,好的学习率可以使模型逐渐收敛并获得更好的精度。较大的学习率可以加快收敛速度,但可能在最优解附近震荡或不收敛;较小的学习率可以提高收敛的精度,但训练速度慢。
学习率衰减是一种平衡策略,初期使用较大学习率快速接近最优解,后期逐渐减小学习率,使参数更稳定地收敛到最优解。
实践中,等间隔衰减实现简单;指定间隔衰减便于在关键 epoch 手动调控;指数衰减适合长训练,衰减更平滑。
等间隔衰减
每隔固定的训练周期(epoch),学习率按一定的比例下降,也称为"步长衰减"。例如,使学习率每隔 20 epoch 衰减为之前的 0.7:
指定间隔衰减
在指定的 epoch,让学习率按照一定的系数衰减。例如,使学习率在epoch达到 [10,50,200] 时衰减为之前的 0.7:
指数衰减
学习率按照指数函数$ \ {f(x) = \ a}^{x}\ ,\ \ a < 1 $进行衰减。例如,使学习率以 0.99 为底数,epoch 为指数衰减:
AdaGrad
AdaGrad(Adaptive Gradient,自适应梯度)会为每个参数适当地调整学习率,并且随着学习的进行,学习率会逐渐减小。
$ h \leftarrow h + \nabla^{2} $
$ W \leftarrow W - \eta\frac{1}{\sqrt{h}}\nabla $
- $ h $:历史梯度的平方和这里$ {\ \nabla}^{2}\ $就表示了梯度的平方和,即$ \frac{\partial L}{\partial W}\ \odot \ \frac{\partial L}{\partial W} $,这里的$ \ \odot $ 表示对应矩阵元素的乘法。
使用 AdaGrad 时,学习越深入,更新的幅度就越小。如果无止境地学习,更新量就会变为0,完全不再更新。公式中的 $ 10^{-7} $ 用于防止 $ \sqrt{h} $ 过小导致数值不稳定。AdaGrad 适合稀疏梯度场景(如 NLP),对频繁更新的参数会施加更强约束。
对比 SGD:

AdaGrad 的代码实现如下:
# AdaGrad
class AdaGrad:
    def __init__(self, lr=0.01):
        """
        初始化参数
        :param lr: 学习率
        """
        self.lr = lr
        self.h = None  # 存储每个参数的梯度平方

    def update(self, params, grads):
        """
        参数更新
        :param params: 模型参数
        :param grads: 梯度
        :return:
        """
        if self.h is None:  # 初始化
            self.h = {}
            for key, val in params.items():
                self.h[key] = np.zeros_like(val)
        for key in params.keys():
            self.h[key] += grads[key] * grads[key]
            params[key] -= self.lr * grads[key] / (np.sqrt(self.h[key]) + 1e-8)
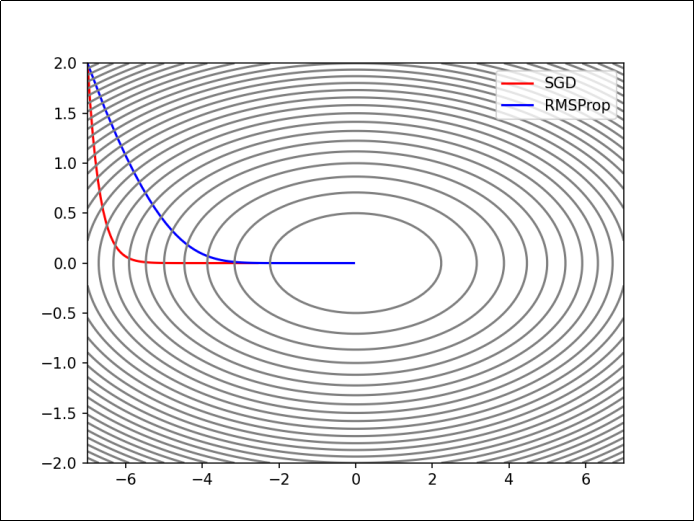
RMSProp
RMSProp(Root Mean Square Propagation,均方根传播)是在 AdaGrad 基础上的改进,它并非将过去所有梯度一视同仁的相加,而是逐渐遗忘过去的梯度,采用指数移动加权平均,呈指数地减小过去梯度的尺度。这样避免了 AdaGrad 在非凸优化中过早停止更新的问题,α 通常取 0.9。
$ h \leftarrow \alpha h + (1 - \alpha)\nabla^{2} $
$ W \leftarrow W - \eta\frac{1}{\sqrt{h}}\nabla $
- h:历史梯度平方和的指数移动加权平均
- $ \alpha $:权重
对比 SGD:
RMSProp 的代码实现如下:
# RMSProp
class c:
    def __init__(self, lr=0.01, decay_rate=0.99):
        """
        初始化参数
        :param lr: 学习率
        :param decay_rate: 衰减率
        """
        self.lr = lr
        self.decay_rate = decay_rate
        self.h = None  # 存储每个参数的梯度平方

    def update(self, params, grads):
        """
        参数更新
        :param params: 模型参数
        :param grads: 梯度
        :return:
        """
        if self.h is None:  # 初始化
            self.h = {}
            for key, val in params.items():
                self.h[key] = np.zeros_like(val)
        for key in params.keys():
            self.h[key] *= self.decay_rate
            self.h[key] += (1 - self.decay_rate) * grads[key] * grads[key]
            params[key] -= self.lr * grads[key] / (np.sqrt(self.h[key]) + 1e-8)
Adam
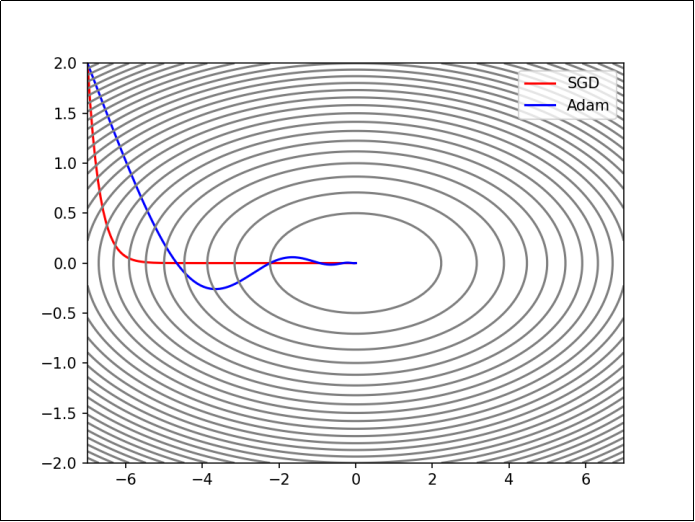
Adam(Adaptive Moment Estimation,自适应矩估计)融合了 Momentum 和 AdaGrad 的方法。它对一阶矩(梯度均值)和二阶矩(梯度平方均值)分别做指数移动平均,并引入偏差修正项,以解决迭代初期 $ v $、$ h $ 偏向 0 的问题。α₁、α₂ 常用 0.9 和 0.999。
$ v \leftarrow \alpha_{1}v + \left( 1 - \alpha_{1} \right)\nabla $
$ h \leftarrow \alpha_{2}h + \left( 1 - \alpha_{2} \right)\nabla^{2} $
$ \widehat{v} = \frac{v}{1 - \alpha_{1}^{t}} $
$ \widehat{h} = \frac{h}{1 - \alpha_{2}^{t}} $
$ W \leftarrow W - \eta\frac{\widehat{v}}{\sqrt{\widehat{h}}} $
- $ \eta $:学习率
- $ \alpha_{1}、\alpha_{2} $:一次动量系数和二次动量系数
- $ t $:迭代次数,从1开始
对比 SGD:
Adam 的代码实现如下:
# Adam
class Adam:
    def __init__(self, lr=0.001, beta1=0.9, beta2=0.999):
        """
        初始化参数
        :param lr: 学习率
        :param beta1: 一阶矩估计的衰减率
        :param beta2: 二阶矩估计的衰减率
        """
        self.lr = lr  # 学习率
        self.beta1 = beta1
        self.beta2 = beta2
        self.iter = 0  # 迭代次数
        self.h = None
        self.v = None

    def update(self, params, grads):
        """
        参数更新
        :param params: 模型参数
        :param grads: 梯度
        :return:
        """
        if self.h is None:
            self.h, self.v = {}, {}
            for key, val in params.items():
                self.h[key] = np.zeros_like(val)
                self.v[key] = np.zeros_like(val)
        self.iter += 1
        lr_t = self.lr * np.sqrt(1.0 - self.beta2 ** self.iter) / (1.0 - self.beta1 ** self.iter)
        for key in params.keys():
            # 简化前:
            # self.v[key] = self.beta1 * self.v[key] + (1 - self.beta1) * grads[key]
            # self.h[key] = self.beta2 * self.h[key] + (1 - self.beta2) * grads[key] ** 2
            # 优化后:
            self.v[key] += (1 - self.beta1) * (grads[key] - self.v[key])
            self.h[key] += (1 - self.beta2) * (grads[key] ** 2 - self.h[key])
            params[key] -= lr_t * self.v[key] / (np.sqrt(self.h[key]) + 1e-8)
参数初始化
参数初始化方案的选择在神经网络学习中起着举足轻重的作用,它对保持数值稳定性至关重要。此外,这些初始化方案的选择可以与激活函数的选择有趣的结合在一起。我们选择哪个激活函数以及如何初始化参数,可以决定优化算法收敛的速度有多快;糟糕的选择可能会导致我们在训练时遇到梯度爆炸或梯度消失。
常数初始化
所有权重参数初始化为一个常数,即
$ W = k \cdot \mathbf{J} $
这里 _J _为全1矩阵,_k _为初始化的常数。
注意:将权重初始值设为 0 将无法正确进行学习。严格地说,不能将权重初始值设成一样的值。因为这意味着反向传播时权重全部都会进行相同的更新,被更新为相同的值(对称的值)。这使得神经网络拥有许多不同的权重的意义丧失了。为了防止"权重均一化"(瓦解权重的对称结构),必须随机生成初始值。
秩初始化
权重参数初始化为单位矩阵,即
$ W = I $
这里 _I _为单位矩阵,即主对角线上元素为 1,其它元素为 0。秩初始化多用于 RNN 等需要保持恒等映射的场景,全连接层中较少使用。
正态分布初始化
权重参数按指定均值_μ_与标准差_σ_正态分布初始化。因为不能直接将权重初始化为相同的常数,所以需要对参数进行随机初始化。最常见的随机分布就是
正态分布(也叫 高斯分布),记作 X ~ N(μ, σ2)。
其概率密度函数为:
$ f(x) = \frac{1}{\sigma\sqrt{2\pi}}e^{- \frac{{(x - \mu)}^{2}}{2\sigma^{2}}} $
均匀分布初始化
权重参数在指定区间内均匀分布初始化。均匀分布一般记作 X ~ U(a,b)。
其概率密度函数为:
$ f(x) = \frac{1}{b - a},a < x < b $
$ f(x) = 0,x \leq \ a\ or\ x \geq \ b $
Xavier 初始化(Glorot 初始化)
Xavier初始化根据输入和输出的神经元数量调整权重的初始范围,确保每一层的输出方差与输入方差相近。
- 正态分布初始化:均值为0,标准差为$ \sqrt{\frac{2}{n_{in} + n_{out}}} $的正态分布。
- 均匀分布初始化:区间$ \left\lbrack - \sqrt{\frac{6}{n_{in} + n_{out}}},\sqrt{\frac{6}{n_{in} + n_{out}}} \right\rbrack $内均匀分布。
其中$ n_{in} $表示输入数,$ n_{out} $表示输出数。
Xavier 初始化参数适用于 Sigmoid 和 Tanh 等激活函数,能有效缓解梯度消失或爆炸问题。其推导假设激活函数在 0 附近近似线性且对称,因此不适用于 ReLU(输出恒非负,破坏了对称性)。
He 初始化(Kaiming 初始化)
He初始化根据输入的神经元数量调整权重的初始范围。其方差为 Xavier 的 2 倍,以补偿 ReLU 将一半神经元置零导致的方差减半。
- 正态分布初始化:均值为0,标准差为$ \sqrt{\frac{2}{n_{in}}} $的正态分布。
- 均匀分布初始化:区间$ \left\lbrack - \sqrt{\frac{6}{n_{in}}},\sqrt{\frac{6}{n_{in}}} \right\rbrack $内均匀分布。
其中$ n_{in} $表示输入数。
He 初始化参数主要适用于 ReLU 及其变体(如 Leaky ReLU)激活函数。
正则化
机器学习的问题中,过拟合是一个很常见的问题。
过拟合指的是能较好拟合训练数据,但不能很好地拟合不包含在训练数据中的其他数据。机器学习的目标是提高泛化能力,希望即便是不包含在训练数据里的未观测数据,模型也可以进行正确的预测。因此可以通过正则化方法来抑制过拟合。
常用的正则化方法有 Batch Normalization、权值衰减、Dropout、早停法等。
Batch Normalization
Batch Normalization 最重要的目的,其实是调整各层的激活值分布使其拥有适当的广度,BN层通常放在线性层(全连接层/卷积层)之后,激活函数之前。它有着以下优点:
- 可以使学习快速进行(允许更高的学习率)
- 不那么依赖初始值(对于初始值不用那么神经质)
- 抑制过拟合(降低 Dropout 等的必要性)
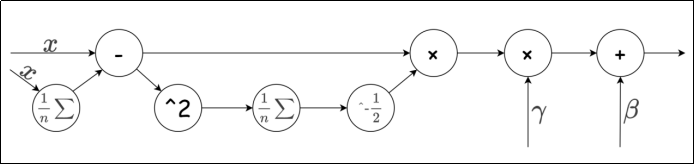
Batch Normalization会先对数据进行标准化,再对数据进行缩放和平移:
$ 均值:\mu = \frac{1}{n}\sum_{}^{}x $
$ 方差:\sigma^{2} = \frac{1}{n}\sum_{}^{}(x - \mu)^{2} $
$ 标准化:\widehat{x} = \frac{x - \mu}{\sqrt{\sigma^{2} + \varepsilon}}\left. (\varepsilon 为一个微小值,防止分母为0 \right.) $
$ 缩放平移:y = \gamma\widehat{x} + \beta $
- $ \varepsilon $:一个微小值,防止分母为0
- $ \gamma $:系数,可通过学习调整
- $ \beta $:偏置,可通过学习调整
标准化会强制每层输入均值为 0、方差为 1,可能削弱网络表达能力;$ \gamma $ 和 $ \beta $ 作为可学习参数,使网络能够恢复或调整该分布,兼顾稳定性与表达能力。
下图为 Batch Normalization 的计算图:
权值衰减
通过在学习的过程中对大的权重进行"惩罚",可以有效地抑制过拟合,这种方法被称为权值衰减。因为很多过拟合产生的原因,就是权重参数取值过大。
一般会对损失函数加上一个权重的范数;最常见的就是 L2 范数的平方:
$ L' = L + \ \frac{1}{2} \cdot \lambda \cdot {||W||}^{2} $
- $ ||W|| $:表示权重$ W = (w_{1},\ w_{1},\ \ldots,w_{1}) $的L2范数,即$ \sqrt{w_{1}^{2} + w_{2}^{2} + \ldots{+ \ w}_{n}^{2}} $
- $ \lambda $: 控制正则化强度的超参数。
惩罚项$ \ \frac{1}{2} \cdot \lambda \cdot {||W||}^{2}\ $求导之后得到$ \lambda W $;所以在求权重梯度时,需要为之前误差反向传播法的结果,再加上$ \ \lambda W $。λ 通常取 $ 10^{-4} $ 到 $ 10^{-2} $ 量级,需根据验证集表现调节。
Dropout 随机失活
Dropout(随机失活,暂退法)是一种在学习的过程中随机关闭神经元的方法。
训练时以概率$ p $随机关闭神经元,迫使网络不依赖特定神经元,增强鲁棒性,同时未被关闭的神经元的输出值以$ \frac{1}{(1 - p)} $的比例进行缩放,以保持期望值不变;而测试时通常不使用 Dropout,即所有神经元保持激活状态并且不进行缩放。全连接层常用 $ p=0.5 $,卷积层因参数共享可用较小值如 0.1~0.2。
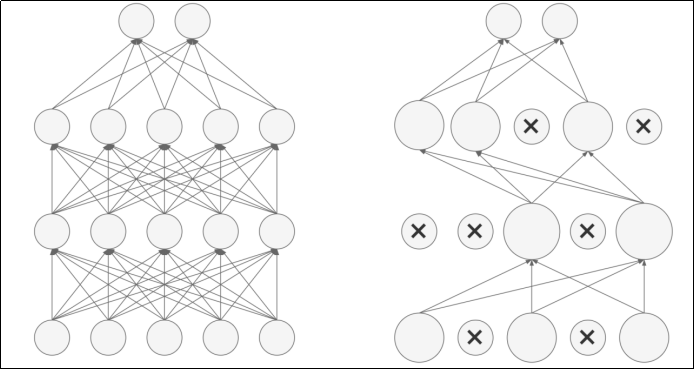
Dropout 会有隐式集成的效果(每次迭代训练不同的子网络,测试时近似集成效果)。
Dropout 在全连接层和卷积层均适用,尤其对大规模网络效果显著。Dropout 通常放在激活函数之后,线性层(全连接层/卷积层)之前。
第七章 PyTorch 入门
基本介绍
PyTorch 是一个开源的 Python 机器学习库,基于 Torch 库(一个有大量机器学习算法支持的科学计算框架,有着与 Numpy 类似的张量(Tensor)操作,采用的编程语言是Lua),底层由 C++ 实现,应用于人工智能领域,如计算机视觉和自然语言处理。
PyTorch 主要有两大特征:
- 类似于 NumPy 的张量计算,能在 GPU 或 MPS 等硬件加速器上加速。
- 基于带自动微分系统的深度神经网络。
张量创建
Tensor(张量)是 PyTorch 的核心数据结构。张量在不同学科中有不同的意义,在深度学习中张量表示一个多维数组,是标量、向量、矩阵的拓展。
如一个 RGB 图像的数组就是一个三维张量,第1维是图像的高,第 2 维是图像的宽,第 3 维是图像的颜色通道(颜色通道是指用来表示图像中每个像素颜色信息的不同组成部分。对于最常见的 RGB 颜色模型来说,一个彩色图像由三个颜色通道组成:红色通道、绿色通道和蓝色通道。每个通道都是一个二维数组,其大小与原始图像的高度和宽度相同,分别存储对应颜色的强度值)。
基本张量创建
torch.tensor
接口:torch.tensor(data, dtype=None, device=None, requires_grad=False)
功能:根据给定数据构造新的张量,不与其他张量或 ndarray 共享内存,推荐用于从 Python 列表或标量创建张量。
参数:
data:用于构造张量的数据(标量、列表、嵌套列表或 NumPy 数组)dtype:元素数据类型,如torch.float32、torch.int64device:存放设备,如'cpu'、'cuda:0'requires_grad:是否参与自动求导
示例代码:
import torch
import numpy as np

# 从标量创建 0 维张量
tensor1 = torch.tensor(10)
print(tensor1)  # tensor(10)

# 从列表创建一维张量
tensor2 = torch.tensor([1, 2, 3])
print(tensor2)  # tensor([1, 2, 3])

# 从 NumPy 数组创建张量(复制数据,不共享内存)
arr = np.array([[1, 2, 3], [4, 5, 6], [7, 8, 9]])
tensor3 = torch.tensor(arr)
print(tensor3)
torch.Tensor(类构造函数)
接口:torch.Tensor(*sizes) 或 torch.Tensor(list_like)
功能:构造指定形状的张量(未初始化),或从序列构造张量,默认元素类型为 torch.float32。
参数:
*sizes:各维度大小,如torch.Tensor(3, 2, 4)表示形状 (3,2,4)- 若传入序列则按该数据构造张量
示例代码:
import torch

# 按形状创建:元素未初始化,默认 dtype=float32
tensor1 = torch.Tensor(3, 2, 4)
print(tensor1.shape, tensor1.dtype)  # torch.Size([3, 2, 4]) torch.float32

# 从嵌套列表创建二维张量
tensor2 = torch.Tensor([[1, 2, 3, 4], [5, 6, 7, 8]])
print(tensor2)
创建指定类型的张量(dtype)
接口:torch.IntTensor / torch.LongTensor / torch.FloatTensor / torch.DoubleTensor 等,或 torch.tensor(..., dtype=...)
功能:创建元素类型为 int32 / int64 / float32 / float64 等指定类型的张量。
参数:
- 形状或数据同
torch.Tensor torch.tensor的dtype指定元素类型- 浮点传入整型构造函数时会截断为整数
示例代码:
import torch

# 方式一:类型构造函数
a = torch.IntTensor(2, 3)           # int32,未初始化
b = torch.LongTensor([1, 2, 3])      # int64
c = torch.FloatTensor([9, 8, 7])    # float32
d = torch.DoubleTensor(2, 3, 1)     # float64,未初始化

# 方式二:torch.tensor + dtype(推荐,语义清晰)
e = torch.tensor([1, 2, 3], dtype=torch.int32)
f = torch.tensor([1, 2, 3], dtype=torch.int64)
g = torch.tensor([1.0, 2.0, 3.0], dtype=torch.float32)

# 整型构造函数传入浮点:会做截断
h = torch.IntTensor([1.1, 2.2, 3.6])  # tensor([1, 2, 3])
print(h)
指定区间的张量创建
torch.arange
接口:torch.arange(start=0, end, step=1, dtype=None, device=None)
功能:在区间 [start, end) 内按步长 step 生成一维张量,类似 range()。
参数:
start:起始值(默认 0)end:结束值(不包含)step:步长(默认 1)dtype:元素类型
示例代码:
import torch

# [10, 30) 步长 2
tensor1 = torch.arange(10, 30, 2)
print(tensor1)  # tensor([10, 12, 14, ..., 28])

# [0, 6) 步长 1,即 [0,1,2,3,4,5]
tensor2 = torch.arange(6)
print(tensor2)  # tensor([0, 1, 2, 3, 4, 5])
torch.linspace
接口:torch.linspace(start, end, steps, dtype=None, device=None)
功能:在区间 [start, end] 上均匀取 steps 个点,生成一维张量。
参数:
start:起始值end:结束值(包含)steps:点的个数(≥2)
示例代码:
import torch

# 在 [10, 30] 上均匀取 5 个点
tensor1 = torch.linspace(10, 30, 5)
print(tensor1)  # tensor([10., 15., 20., 25., 30.])
torch.logspace
接口:torch.logspace(start, end, steps, base=10.0, dtype=None, device=None)
功能:在“指数区间”上均匀取点:先对 [start, end] 做 linspace,再对每个值做 base ** x,得到一维张量。
参数:
start、end:指数区间的两端steps:点数base:底数(默认 10)
示例代码:
import torch

# 指数区间 [1,3],3 个点,底数 2 → 即 2^1, 2^2, 2^3
tensor1 = torch.logspace(1, 3, 3, base=2)
print(tensor1)  # tensor([2., 4., 8.])
按数值填充张量
相关 API:
- torch.zeros:
torch.zeros(*size, dtype=None, device=None)。创建全 0 张量。参数*size为各维度大小。 - torch.ones:
torch.ones(*size, dtype=None, device=None)。创建全 1 张量,参数同上。 - torch.full:
torch.full(size, fill_value, dtype=None, device=None)。用常数填充。size为形状元组,fill_value为填充值。 - torch.empty:
torch.empty(*size, dtype=None, device=None)。未初始化张量(值未定义),*size为各维度大小。 - torch.zeros_like / ones_like / full_like / empty_like:与
input同形状的对应张量,input为参考张量;full_like需额外传入fill_value。 - torch.eye:
torch.eye(n, m=None, dtype=None, device=None)。单位矩阵或 n×m 对角为 1 的矩阵。n为行数,m为列数(默认 n)。
示例代码:
import torch

# 全 0 / 全 1 / 常数填充
tensor1 = torch.zeros(2, 3)
print(tensor1)
tensor2 = torch.ones_like(tensor1)
print(tensor2)
tensor3 = torch.full((2, 3), 6)
print(tensor3)

# empty 不保证数值,仅分配内存
tensor4 = torch.empty(2, 3)
tensor5 = torch.empty_like(tensor1)

# 单位矩阵:n×n 或 n×m
eye_n = torch.eye(3)       # 3×3 单位阵
eye_nm = torch.eye(3, 4)  # 3×4,前 3 列对角为 1
print(eye_n)
print(eye_nm)
随机张量创建
相关 API:
- torch.rand:
torch.rand(*size, dtype=None, device=None)。[0, 1) 均匀分布,*size为形状。 - torch.randint:
torch.randint(low, high, size, ...)。[low, high) 离散均匀整数。low、high为下界与上界(不含),size为形状。 - torch.randn:
torch.randn(*size, ...)。标准正态 N(0,1),*size为形状。 - torch.normal:
torch.normal(mean, std, size=None, ...)。正态 N(mean, std²)。mean、std为标量或与size兼容的张量,size为形状。 - torch.rand_like / randint_like / randn_like:与
input同形状的对应随机张量,input为参考张量;randint_like需传入low、high。 - torch.randperm:
torch.randperm(n, dtype=torch.int64, device=None)。0 到 n-1 的随机排列,n为整数。 - torch.manual_seed:
torch.manual_seed(seed)。设置 CPU 随机种子,seed为整数。
示例代码:
import torch

# [0, 1) 均匀分布
tensor1 = torch.rand(2, 3)
print(tensor1)

# 与某张量同形状的 [1, 10) 整数
tensor2 = torch.randint_like(tensor1, 1, 10)
print(tensor2)

# 标准正态 N(0, 1)
tensor3 = torch.randn(4, 2)
print(tensor3)

# 正态 N(5, 1),形状与 tensor3 相同
tensor4 = torch.normal(5, 1, size=tensor3.shape)
print(tensor4)

# 0~9 的随机排列
perm = torch.randperm(10)
print(perm)

# 固定种子以便复现
torch.manual_seed(42)
a = torch.rand(2, 2)
torch.manual_seed(42)
b = torch.rand(2, 2)
print(a.equal(b))  # True
张量转换
张量元素类型转换
接口:Tensor.type(dtype) / Tensor.double() / Tensor.float() / Tensor.long() / Tensor.int() 等
功能:返回指定元素类型的新张量,原张量不变(非 in-place)。
参数:
dtype:目标类型,如torch.float32、torch.int64(仅type(dtype)需传入)
示例代码:
import torch

tensor1 = torch.tensor([1, 2, 3])  # 默认 int64 或根据数据推断
print(tensor1.dtype)  # torch.int64

# 转为 float32
tensor1 = tensor1.type(torch.float32)
print(tensor1.dtype)  # torch.float32

# 便捷方法:double→float64, long→int64, int→int32
tensor1 = tensor1.double()
tensor1 = tensor1.long()
print(tensor1.dtype)  # torch.int64
Tensor 与 ndarray 转换
相关 API:
- Tensor.numpy():
tensor.numpy()。张量转为 NumPy 数组。CPU 且非requires_grad时与张量共享内存,修改一方会影响另一方。 - torch.from_numpy:
torch.from_numpy(ndarray)。NumPy 数组转为张量,与数组共享内存。 - torch.tensor(ndarray):
torch.tensor(ndarray)。NumPy 数组转为张量,不共享内存,复制数据。
示例代码:
import torch
import numpy as np

# Tensor → ndarray:默认共享内存(CPU)
tensor1 = torch.rand(3, 2)
arr = tensor1.numpy()
tensor1[:, 0] = 4
print(tensor1)
print(arr)  # arr 也会被修改

# 不共享:使用 .copy()
arr2 = tensor1.numpy().copy()
tensor1[:, 0] = -1
print(arr2)  # 不变

# ndarray → Tensor:from_numpy 共享,torch.tensor 不共享
arr3 = np.random.randn(3)
tensor2 = torch.from_numpy(arr3)
arr3[0] = 100
print(tensor2[0])  # 100,共享

tensor3 = torch.tensor(arr3)
arr3[0] = -1
print(tensor3[0])  # 仍为 100,不共享
Tensor 与标量转换
接口:Tensor.item()
功能:当张量仅含一个元素时,返回该元素的 Python 标量(int/float)。多元素张量调用会报错。
参数:无
示例代码:
import torch

tensor1 = torch.tensor(3.14)
scalar = tensor1.item()  # 得到 Python float
print(scalar, type(scalar))  # 3.14 <class 'float'>

tensor2 = torch.tensor(5)
print(tensor2.item())  # 5 <class 'int'>
张量数值计算
基本运算
四则运算
接口:+、-、*、/ 以及 Tensor.add(other) / sub / mul / div、Tensor.add_(other) / sub_ / mul_ / div_
功能:逐元素加减乘除。运算符与 add/sub/mul/div 返回新张量、不修改自身;带下划线的 add_ 等为 in-place,会修改自身。
参数:
other:张量或标量
示例代码:
import torch

tensor1 = torch.randint(1, 9, (2, 3))
print(tensor1)
# 运算符与 add 均不修改原张量
print(tensor1 + 10)
print(tensor1.add(10))
print(tensor1)  # 未变
# in-place:原张量被修改
print(tensor1.add_(10))
print(tensor1)  # 已加 10
取负:-、neg()、neg_()
接口:-Tensor / Tensor.neg() / Tensor.neg_()
功能:逐元素取负。neg() 返回新张量,neg_() 为 in-place。
参数:无
示例代码:
import torch
tensor1 = torch.tensor([1, 2, 3])
print(-tensor1)        # tensor([-1, -2, -3])
print(tensor1.neg())  # 同上,tensor1 不变
print(tensor1.neg_()) # 同上,且 tensor1 被修改
print(tensor1)        # tensor([-1, -2, -3])
求幂:**、pow()、pow_()
接口:Tensor ** exponent / Tensor.pow(exponent) / Tensor.pow_(exponent)
功能:逐元素求幂。pow() 返回新张量,pow_() 为 in-place。
参数:exponent:指数(标量或与张量可广播的张量)
示例代码:
import torch
tensor1 = torch.tensor([1, 2, 3])
print(tensor1 ** 2)   # tensor([1, 4, 9])
print(tensor1.pow(2)) # 同上
tensor1.pow_(2)       # in-place
print(tensor1)        # tensor([1, 4, 9])
求平方根:sqrt()、sqrt_()
接口:Tensor.sqrt() / Tensor.sqrt_()
功能:逐元素平方根。sqrt() 返回新张量,sqrt_() 为 in-place。
参数:无
示例代码:
import torch
tensor1 = torch.tensor([1.0, 2.0, 3.0])
print(tensor1.sqrt())  # tensor([1., 1.414..., 1.732...])
tensor1.sqrt_()
print(tensor1)
以 e 为底:exp()、log()
接口:Tensor.exp() / Tensor.exp_()、Tensor.log() / Tensor.log_()
功能:逐元素以 e 为底求幂(exp)或求自然对数(log)。带下划线版本为 in-place。
参数:无
示例代码:
import torch
tensor1 = torch.tensor([1.0, 2.0, 3.0])
print(tensor1.exp())  # e^1, e^2, e^3
print(tensor1.log())  # ln(1), ln(2), ln(3)
哈达玛积(逐元素乘法)
接口:*、Tensor.mul(other)
功能:两张量形状相同或可广播时,对应位置相乘(Hadamard product),与矩阵乘法不同。
参数:other:张量或标量
示例代码:
import torch
tensor1 = torch.tensor([[1, 2], [3, 4]])
tensor2 = torch.tensor([[1, 2], [3, 4]])
print(tensor1 * tensor2)   # [[1,4],[9,16]]
print(tensor1.mul(tensor2)) # 同上
矩阵乘法:mm、@、matmul
接口:Tensor.mm(mat2)、Tensor @ other、Tensor.matmul(other)
功能:mm 仅支持二维矩阵乘法 (m×n)(n×p)。@ 与 matmul 支持二维及高维,高维时对最后两维做矩阵乘,其余维按批处理或广播。
参数:
mat2/other:与当前张量最后两维满足矩阵乘法的张量mm仅接受 2D
示例代码:
import torch

# 2D
a = torch.tensor([[1, 2, 3], [4, 5, 6]])   # 2×3
b = torch.tensor([[1, 2], [3, 4], [5, 6]]) # 3×2
print(a.mm(b))    # 2×2
print(a @ b)     # 同上
print(a.matmul(b))

# 3D:按批次做矩阵乘,(batch, m, n) @ (batch, n, p) -> (batch, m, p)
x = torch.tensor([[[1, 2, 3], [4, 5, 6]], [[6, 5, 4], [3, 2, 1]]])  # (2,2,3)
y = torch.tensor([[[1, 2], [3, 4], [5, 6]], [[6, 5], [4, 3], [2, 1]]])  # (2,3,2)
print((x @ y).shape)  # (2, 2, 2)
节省内存:避免重复分配
X = X @ Y 会先分配新张量再赋给 X;若之后不再使用原来的 X,可用 X[:] = X @ Y 在原有存储上写入,减少一次分配。
示例代码:
import torch
X = torch.randint(1, 9, (3, 2, 4))
Y = torch.randint(1, 9, (3, 4, 1))
print(id(X))
X = X @ Y      # X 指向新对象,原内存可被回收
print(id(X))   # 与上面不同

X = torch.randint(1, 9, (3, 2, 4))
print(id(X))
X[:] = X @ Y   # 结果写回 X 的存储,id(X) 不变
print(id(X))
注意:确保右边的结果能够正确地广播到左边指定的形状。如果形状不匹配,则会导致错误。
张量运算函数
接口:
Tensor.sum(dim=None, keepdim=False):求和Tensor.mean(...):求均值Tensor.max(...):最大值Tensor.min(...):最小值Tensor.argmax(dim=None)/argmin(dim=None):返回最大/最小值下标Tensor.std(dim=None, unbiased=True):求标准差Tensor.unique(sorted=True, return_inverse=False):去重Tensor.sort(dim=-1, descending=False):排序并返回
参数:
dim:沿某维聚合;不指定则对全部元素keepdim:是否保留该维(True 时该维为 1)unbiased:标准差分母用 n-1 或 nsorted、return_inverse:unique 是否排序、是否返回逆索引descending:sort 是否降序
示例代码:
import torch
tensor1 = torch.randint(1, 9, (3, 2, 4)).float()

# 全局与按维求和/均值
print(tensor1.sum())           # 标量
print(tensor1.sum(dim=0))      # 沿 dim0 聚合,形状 (2,4)
print(tensor1.mean(dim=1))     # 沿 dim1 聚合,形状 (3,4)

# 最大值:可同时返回索引
print(tensor1.max())           # 全局最大
vals, idx = tensor1.max(dim=2)  # 每行最大及索引

# 最小值的线性索引、标准差、去重、排序
print(tensor1.argmin())        # 展平后最小值的下标
print(tensor1.std())
print(tensor1.unique())
print(tensor1.sort())          # (values, indices)
张量索引操作
简单索引与切片
接口:tensor[i]、tensor[:, j]、tensor[i:j, k:l] 等下标与切片语法
功能:单整数索引会使该维消失(降维);切片保留该维;: 表示该维全选。
参数:i、j 等为整数或切片(start:end:step),支持负索引。
示例代码:
import torch
tensor1 = torch.randint(1, 9, (3, 5, 4))
print(tensor1[0].shape)      # (5, 4):取第 0 维为 0 的片
print(tensor1[:, 1].shape)   # (3, 4):第 1 维取 1
print(tensor1[2, 1, 3])      # 标量
print(tensor1[1:, 1:4, 0:3].shape)  # (2, 3, 3):切片
范围索引(切片)
同上“简单索引”中的切片用法;start:end:step、负索引均支持。
示例代码:
import torch
tensor1 = torch.randint(1, 9, (3, 5, 4))
print(tensor1[1:].shape)           # (2, 5, 4):第 0 维从 1 到末
print(tensor1[-1:, 1:4, 0:3].shape) # (1, 3, 3):最后一行,第 1 维 1:4,第 2 维 0:3
列表索引
接口:tensor[[i1,i2,...],[j1,j2,...],...] 等,下标为整数张量或列表
功能:多下标按位置配对或广播,可取出不连续或重排后的元素。
参数:各维传入长度相同的整数序列或可广播的整数张量。
示例代码:
import torch
tensor1 = torch.randint(1, 9, (3, 5, 4))
# 取 (0,1)、(1,2) 两行,结果形状 (2, 4)
print(tensor1[[0, 1], [1, 2]].shape)
# [[0],[1]] 与 [1,2] 广播,取 4 个位置,结果形状 (2, 2, 4)
print(tensor1[[[0], [1]], [1, 2]].shape)
布尔索引
接口:tensor[mask]
功能:mask 为与张量同形状或可广播的布尔张量,结果为所有 True 位置元素组成的一维张量。
参数:mask:布尔类型的张量或布尔表达式(如 tensor > 5)。
示例代码:
#自定义环境 library/python3-be38bd9cb461ab775f44082e06df14e1
import torch
tensor1 = torch.randint(1, 9, (3, 5, 4))

print(tensor1)

print()

# 第 2 维第 0 列 > 5 的掩码 (3,5),按掩码取出一维
print(tensor1[:, :, 0] > 5)
print(tensor1[tensor1[:, :, 0] > 5].shape)

print()

# 取 第1维第1大于5的,返回(dim0,dim2)形状的索引

mask = tensor1[:, 1, :] > 5
print(mask)

tensor2 = tensor1.permute(0, 2, 1)  # 转换维度为(dim0,dim2,dim1)
print(tensor2[mask])

tensor2 = tensor2[mask].permute(1, 0)  # 转换维度为(dim1,?)
print(tensor2)
print()

# 取 第1维第1,第2维第2大于5的,返回(dim0)形状的索引
print(tensor1[:, 1, 2] > 5)
print(tensor1[tensor1[:, 1, 2] > 5])
张量形状操作
交换维度
接口:
Tensor.transpose(dim0, dim1):交换两个指定维度Tensor.permute(*dims):按给定顺序重排所有维度,可一次实现多维交换
参数:
transpose(dim0, dim1):dim0、dim1为要交换的两个维度下标(从 0 起)。permute(*dims):*dims为新的维度顺序,例如原形状 (2,3,6) 传入 (2,0,1) 得到 (6,2,3)。
示例代码:
import torch
tensor1 = torch.randint(1, 9, (2, 3, 6))

# transpose:只交换第 1 维与第 2 维,结果形状 (2, 6, 3)
print(tensor1.transpose(1, 2))

# permute:按 (dim2, dim0, dim1) 重排,结果形状 (6, 2, 3)
print(tensor1.permute(2, 0, 1))
reshape 与 view
接口:
Tensor.reshape(*shape):在内存不连续时可返回副本Tensor.view(*shape):要求张量在内存中连续,否则需先调用contiguous()
功能:在元素总数不变的前提下调整形状。
参数:
*shape:目标形状,可含一个-1表示该维由元素总数推断。
示例代码:
import torch
tensor1 = torch.randint(1, 9, (3, 5, 4))  # 共 60 个元素

print(tensor1.reshape(6, 10))   # 形状 (6, 10)
print(tensor1.reshape(3, -1))  # (3, 20),-1 被推断为 20
内存连续与 contiguous
接口:
Tensor.is_contiguous():判断内存是否连续Tensor.contiguous():返回连续副本(必要时复制数据),便于后续view
transpose、permute、切片等可能得到不连续张量。需要使用 contiguous()进行调整。
参数:无
示例代码:
import torch
tensor1 = torch.randint(1, 9, (3, 5, 4))
print(tensor1.is_contiguous())   # True
print(tensor1.view(-1, 10))     # 可直接 view

tensor1 = tensor1.permute(2, 0, 1)  # 交换后可能不连续
print(tensor1.is_contiguous())   # False
# tensor1.view(-1) 可能报错,先 contiguous 再 view
print(tensor1.contiguous().view(-1))
unsqueeze:增加大小为 1 的维
接口:
Tensor.unsqueeze(dim)Tensor.unsqueeze_(dim)
功能:在指定位置插入一个大小为 1 的维度,常用于广播或与某些接口的维度要求对齐。
参数:
dim:插入的维度下标(支持负索引,-1 表示最后一维之后)。
示例代码:
import torch
tensor1 = torch.tensor([1, 2, 3, 4, 5])  # shape (5,)

print(tensor1.unsqueeze(dim=0))   # (1, 5)
print(tensor1.unsqueeze(dim=1))   # (5, 1)
print(tensor1.unsqueeze(dim=-1))  # (5, 1)
squeeze:删除大小为 1 的维
接口:
Tensor.squeeze(dim=None)Tensor.squeeze_(dim=None)
功能:删除大小为 1 的维度。不传 dim 时删除所有大小为 1 的维;传 dim 时仅当该维为 1 才删除。
参数:
dim:可选,指定要删除的维度下标。
示例代码:
import torch
tensor1 = torch.tensor([1, 2, 3, 4, 5])
tensor1 = tensor1.unsqueeze_(dim=0)  # (1, 5)
print(tensor1.squeeze())  # (5,),删除所有大小为 1 的维
张量拼接操作
torch.cat
接口:torch.cat(tensors, dim=0, out=None)
功能:在指定维度上拼接多个张量,除 dim 外其余维度须相同。
参数:
tensors:张量序列(list 或 tuple)dim:沿该维拼接out:可选输出张量
torch.stack
接口:torch.stack(tensors, dim=0, out=None)
功能:在新维度上堆叠多个张量,所有输入形状必须一致,结果多出一维。
参数:
tensors:形状相同的张量序列dim:插入的新维度位置out:可选输出张量
示例代码:
import torch
# cat:在 dim=1 上拼接,(2,2,5) 与 (2,1,5) -> (2,3,5)
tensor1 = torch.randint(1, 9, (2, 2, 5))
tensor2 = torch.randint(1, 9, (2, 1, 5))
print(torch.cat([tensor1, tensor2], dim=1).shape)  # (2, 3, 5)
# stack:在 dim=2 处堆叠,(3,1,5) 与 (3,1,5) -> (3,1,2,5)
tensor1 = torch.randint(1, 9, (3, 1, 5))
tensor2 = torch.randint(1, 9, (3, 1, 5))
tensor3 = torch.stack([tensor1, tensor2], dim=2)
print(tensor3.shape)  # (3, 1, 2, 5)
自动微分模块
训练时 PyTorch 会构建计算图(computational graph),记录数据与运算,并通过内置的微分引擎 torch.autograd 在根节点调用 backward() 自动计算梯度。PyTorch 的 backward() 就是在计算图上自动做链式法则,从根节点(通常是损失)一路把梯度传回叶子节点(如权重、偏置)。
计算图与链式法则
计算图由节点(张量)和边(运算)组成。例如下面“单层线性 + MSE 损失”:
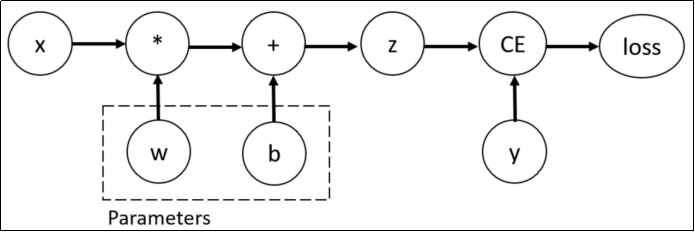
叶子节点 x、w、b 经过运算得到 z = w*x + b,再与 y 一起送入损失函数得到根节点 loss_value。前向时沿着“叶子 → 根”的方向计算。
调用 loss_value.backward() 时,梯度从根节点沿边反向传回叶子。链式法则体现在:根对某叶子的梯度 = 根对中间节点梯度 × 中间节点对叶子的梯度,逐层相乘,PyTorch 在每条边上记录 grad_fn,反向时按图自动完成这一过程。
自动微分相关接口
**torch.autograd**:自动求导引擎,追踪requires_grad=True的张量上的运算,无需直接调用,在根节点调用backward()时触发反向传播。**Tensor.requires_grad**:是否参与求导;设为True时参与计算图,叶子节点通常设为True。**Tensor.backward(gradient=None, retain_graph=False)**:从该张量开始反向传播,计算梯度。标量根节点可省略gradient;若根节点非标量(如形状为 (batch,) 的损失向量),必须传入gradient,形状与根节点相同,表示“损失对根节点自身的梯度”,常取全 1,即loss.backward(torch.ones_like(loss))。retain_graph=True时保留计算图以便再次反向。**Tensor.grad**:反向传播后得到的梯度(仅叶子节点默认保留),训练前需optimizer.zero_grad()清零。**Tensor.detach()**:从计算图中分离,返回不追踪梯度的新张量,梯度不会经此张量继续传播。**Tensor.is_leaf**:是否为叶子节点(由用户创建或由叶子节点运算得到、且未被其它运算作为输入的张量)。对requires_grad=True的叶子节点不宜做 in-place 修改,否则可能破坏梯度计算。**torch.no_grad()**:上下文管理器,在with torch.no_grad():内的计算不构建计算图、不记录梯度,用于推理/评估阶段,省显存且加速。
示例代码:
import torch

# 输入与目标(不需要梯度)
x = torch.tensor(10.0)
y = torch.tensor(3.0)
# 可训练参数:requires_grad=True 以记录运算并求梯度
w = torch.rand(1, 1, requires_grad=True)
b = torch.rand(1, 1, requires_grad=True)
z = w * x + b
# 损失函数与反向传播
loss_fn = torch.nn.MSELoss()
loss_value = loss_fn(z, y)
loss_value.backward()  # 计算图中所有 requires_grad=True 的叶子节点的梯度
print("w.grad:", w.grad)
print("b.grad:", b.grad)
在上述计算图中,x、w、b 为叶子节点(数据并非由图中其它运算生成),最终的损失 loss_value 为根节点。可通过 is_leaf 属性查看张量是否为叶子节点:
print(x.is_leaf)        # True
print(w.is_leaf)        # True
print(b.is_leaf)        # True
print(z.is_leaf)        # False(z 由 w*x+b 计算得到)
print(y.is_leaf)        # True
print(loss_value.is_leaf)  # False
自动微分的关键是记录每个节点的数据与运算:数据保存在张量的 data 属性中,运算类型保存在 grad_fn 属性中。PyTorch 采用动态图机制,在前向计算过程中逐步构建计算图,并为每个张量保存 grad_fn 供反向传播使用。
将张量设为 requires_grad=True 后,PyTorch 会追踪所有基于该张量的运算,在根节点调用 backward() 时反向传播,计算图中所有参与运算的叶子节点的梯度。非叶子节点的梯度在反向传播后默认会被释放(若需保留可设置 retain_grad=True);叶子节点的梯度会保留并累积,因此训练时通常需用 optimizer.zero_grad() 在每步前清零。
若希望把部分计算排除在计算图之外,可使用 Tensor.detach():返回与原张量同值、但不再参与梯度传播的新张量,梯度在反向传播时不会经过该节点继续向后传递。例如:
import torch

x = torch.ones(2, 2, requires_grad=True)
y = x * x
u = y.detach()   # 分离 y,得到与 y 同值但不追踪梯度的 u
z = u * x
z.sum().backward()
# 反向传播时 z = u*x 对 x 求偏导,u 被视为常数,故 dz/dx = u,即 x.grad == u
# 若未 detach,则 z = x*x*x,dz/dx = 3*x^2,与上述结果不同
print(x.grad == u)  # tensor([[True, True], [True, True]])
训练循环中的顺序
一次参数更新的标准顺序是:先 optimizer.zero_grad() 再前向与 loss.backward(),最后 optimizer.step()。因为叶子节点的梯度会累积,若不先清零,本步的梯度会与上一步的加在一起,导致更新错误。
in-place 与 no_grad 使用注意:
对 requires_grad=True 的叶子节点做 in-place 操作(如 w.add_(1)、x += 1)会修改其存储,可能使已记录的 grad_fn 与真实数据不一致,梯度错误或报错。需要“在原张量上改”时,可先 w = w + 1 或对不需要梯度的中间结果做 in-place。推理/评估时用 with torch.no_grad(): 包住前向计算,避免建图和保存中间结果,例如:
model.eval()
with torch.no_grad():
    pred = model(X_test)
案例:线性回归
整体流程:准备数据 → 构建模型 → 定义损失与优化器 → 循环训练(前向、算损失、反向、更新参数)。
本案例相关接口:
**torch.utils.data.TensorDataset(*tensors)**:将多个张量组成“特征-标签”对的数据集。参数:*tensors 第 0 维为样本数,一一对应。**torch.utils.data.DataLoader(dataset, batch_size=1, shuffle=False)**:按 batch 迭代数据集,支持打乱。参数:batch_size 批大小;shuffle 是否打乱。**torch.nn.Linear(in_features, out_features, bias=True)**:线性层 y = xW^T + b。参数:in_features/out_features 输入/输出特征数;bias 是否使用偏置。**torch.nn.MSELoss(reduction='mean')**:均方误差损失。参数:reduction 为 'mean'/'sum'/'none'。**torch.optim.SGD(params, lr, ...)**:随机梯度下降优化器。参数:params 可训练参数;lr 学习率。
示例代码:
#自定义环境 library/python3-be38bd9cb461ab775f44082e06df14e1
import torch
import matplotlib.pyplot as plt

from torch import nn, optim  # 模型、损失函数和优化器
from torch.utils.data import TensorDataset, DataLoader  #数据集和数据加载器

# 构建数据集
X = torch.randn(100, 1)  # 输入
w = torch.tensor([2.5])  # 权重
b = torch.tensor([5.2])  # 偏置
noise = torch.randn(100, 1) * 0.1  # 噪声
y = w * X + b + noise  # 目标
dataset = TensorDataset(X, y)  # 构造数据集对象
dataloader = DataLoader(dataset, batch_size=10, shuffle=True)  # 构造数据加载器对象,batch_size为每次训练的样本数,shuffle为是否打乱数据

# 构造模型
model = nn.Linear(in_features=1, out_features=1)  #线性回归模型,1个输入,1个输出

# 损失函数和优化器
loss = nn.MSELoss()  # 均方误差损失函数
optimizer = optim.SGD(model.parameters(), lr=1e-3)  #随机梯度下降,学习率0.001

# 模型训练
loss_list = []
for epoch in range(1000):
    total_loss = 0
    train_num = 0
    for x_train, y_train in dataloader:
        # 每次训练一个batch大小的数据
        y_pred = model(x_train)  # 模型预测
        loss_value = loss(y_pred, y_train)  # 计算损失
        total_loss += loss_value.item()
        train_num += len(y_train)
        optimizer.zero_grad()  # 梯度清零
        loss_value.backward()  # 反向传播
        optimizer.step()  # 更新参数
    loss_list.append(total_loss / train_num)

print(model.weight, model.bias)  # 打印权重和偏置
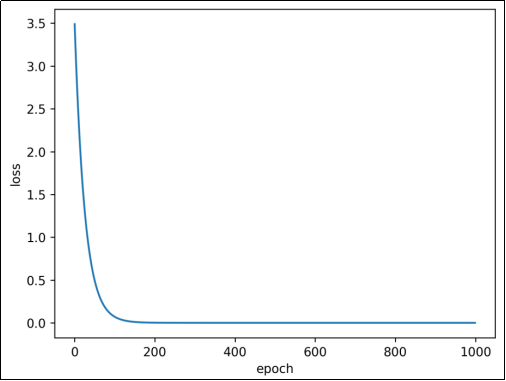
plt.plot(loss_list)
plt.xlabel("epoch")
plt.ylabel("loss")
plt.show()

第八章 用 PyTorch 进行深度学习
激活函数
PyTorch 中已经实现了神经网络中可能用到的各种激活函数,在代码中只要直接调用即可。
Sigmoid 函数
公式:
$ f(x) = \frac{1}{1 + e^{- x}} $
$ f'(x) = \frac{1}{1 + e^{- x}}\left( 1 - \frac{1}{1 + e^{- x}} \right) = f(x)\left( 1 - f(x) \right) $
接口:torch.sigmoid(x)
功能:对输入逐元素计算 Sigmoid,输出在 (0,1)。
参数:
x:输入张量
Sigmoid 函数与其导数图像绘制代码:
# 整体流程:
# 1. 构造输入与画布
# 2. 左图绘 sigmoid 曲线
# 3. 反向传播求导
# 4. 右图绘导数曲线

import torch
import matplotlib.pyplot as plt
x = torch.linspace(-10, 10, 1000, requires_grad=True)  # requires_grad=True 需梯度以便求导
fig, ax = plt.subplots(1, 2)  # 1 行 2 列子图
fig.set_size_inches(12, 4)
ax[0].plot(x.data, torch.sigmoid(x).data, "purple")  # 左图:sigmoid 函数值
ax[0].set_title("sigmoid(x)")
ax[0].spines["top"].set_visible(False)
ax[0].spines["right"].set_visible(False)
ax[0].spines["left"].set_position("zero")
ax[0].spines["bottom"].set_position("zero")
ax[0].axhline(0.5, color="gray", alpha=0.7, linewidth=1)
ax[0].axhline(1, color="gray", alpha=0.7, linewidth=1)
torch.sigmoid(x).sum().backward()  # 反向传播,使 x.grad 为 sigmoid 的导数
ax[1].plot(x.data, x.grad, "purple")  # 右图:导数
ax[1].set_title("sigmoid\'(x)")
ax[1].spines["top"].set_visible(False)
ax[1].spines["right"].set_visible(False)
ax[1].spines["left"].set_position("zero")
ax[1].spines["bottom"].set_position("zero")
ax[1].set_ylim(0, 0.3)
plt.show()
Tanh函数
公式:
$ f(x) = \frac{1 - e^{- 2x}}{1 + e^{- 2x}} $
$ f'(x) = 1 - \left( \frac{1 - e^{- 2x}}{1 + e^{- 2x}} \right)^{2} = 1 - f^{2}(x) $
接口:torch.tanh(x)
功能:对输入逐元素计算双曲正切,输出在 (-1,1)。
参数:
x:输入张量
Tanh 函数与其导数图像绘制代码:
# 整体流程:同 Sigmoid,生成 x → 左图 tanh、右图 tanh 导数
import torch
import matplotlib.pyplot as plt
x = torch.linspace(-5, 5, 1000, requires_grad=True)
fig, ax = plt.subplots(1, 2)
fig.set_size_inches(12, 4)
ax[0].plot(x.data, torch.tanh(x).data, "purple")
ax[0].set_title("tanh(x)")
ax[0].spines["top"].set_visible(False)
ax[0].spines["right"].set_visible(False)
ax[0].spines["left"].set_position("zero")
ax[0].spines["bottom"].set_position("zero")
ax[0].axhline(-1, color="gray", alpha=0.7, linewidth=1)
ax[0].axhline(1, color="gray", alpha=0.7, linewidth=1)
torch.tanh(x).sum().backward()  # 反向传播求 tanh 的梯度
ax[1].plot(x.data, x.grad, "purple")
ax[1].set_title("tanh\'(x)")
ax[1].spines["top"].set_visible(False)
ax[1].spines["right"].set_visible(False)
ax[1].spines["left"].set_position("zero")
ax[1].spines["bottom"].set_position("zero")
plt.show()
ReLU 函数
公式:
$ f(x) = \max(0,x) $
$ f^{'(x)} = \left{ \begin{array}{r}
0,x \leq 0 \
1,x > 0
\end{array} \right.\ $
接口:torch.relu(x)
功能:对输入逐元素做 ReLU,即 $ \max(0, x) $。
参数:
x:输入张量
注意:x=0 时 ReLU 函数不可导,此时我们默认使用左侧的函数。
ReLU 函数与其导数图像绘制代码:
# 整体流程:同 Sigmoid,左图 ReLU、右图 ReLU 导数(0 左侧为 0、右侧为 1)
import torch
import matplotlib.pyplot as plt
x = torch.linspace(-5, 5, 1000, requires_grad=True)

fig, ax = plt.subplots(1, 2)
fig.set_size_inches(12, 4)
ax[0].plot(x.data, torch.relu(x).data, "purple")
ax[0].set_title("relu(x)")
ax[0].spines["top"].set_visible(False)
ax[0].spines["right"].set_visible(False)
ax[0].spines["left"].set_position("zero")
ax[0].spines["bottom"].set_position("zero")
torch.relu(x).sum().backward()  # 反向传播求 ReLU 梯度
ax[1].plot(x.data, x.grad, "purple")
ax[1].set_title("relu\'(x)")
ax[1].spines["top"].set_visible(False)
ax[1].spines["right"].set_visible(False)
ax[1].spines["left"].set_position("zero")
ax[1].spines["bottom"].set_position("zero")
plt.show()
Softmax 函数
公式:
$ f\left( x_{i} \right) = \frac{e^{x_{i}}}{\sum_{j = 1}^{n}e^{x_{j}}} $
$ \frac{\partial f\left( x_{i} \right)}{\partial x_{j}} = \left{ \begin{array}{r}
f\left( x_{i} \right)\left( 1 - f\left( x_{j} \right) \right),i = j \
- f\left( x_{i} \right)f\left( x_{j} \right),i \neq j
\end{array} \right.\ $
接口:torch.softmax(x, dim)
功能:在指定维度 dim 上对输入做 Softmax,使该维和为 1。
参数:
x:输入张量dim:沿该维计算 Softmax
Softmax 函数直接调用即可,示例代码:
#自定义环境 library/python3-be38bd9cb461ab775f44082e06df14e1
# 整体流程:构造一维输入 → softmax 将原始值转为概率分布(和为 1)→ 打印对比
import torch
x = torch.tensor([2.0, 1.0, 0.1])
output = torch.softmax(x, dim=0)  # dim=0:沿第 0 维(唯一维)做 softmax
print("输入:", x)
print("Softmax输出:", output)  # 各元素 ∈ (0,1),总和 = 1
print("输出之和:", output.sum())
# 二维示例:按行做 softmax(每行和为 1)
x2 = torch.tensor([[1.0, 2.0, 3.0],
                    [1.0, 1.0, 1.0]])
output2 = torch.softmax(x2, dim=1)  # dim=1:沿列方向(每行内部)做 softmax
print("二维Softmax输出:\n", output2)
print("每行之和:", output2.sum(dim=1))  # 均为 1
参数初始化和正则化
全连接层
接口:nn.Linear(in_features, out_features)
功能:全连接层(仿射层),对输入做线性变换并加偏置。
参数:
in_features:输入特征数out_features:输出特征数
在神经网络中,参数主要位于全连接层(仿射层 Affine)中。PyTorch 提供 torch.nn 模块用于神经网络的构建和训练,其中全连接层实现为 Linear 类,内部有属性 weight 和 bias。
示例:定义了一个有5个输入神经元、2个输出神经元的全连接层。
# 整体流程:导入模块 → 创建全连接层(5 个输入特征,2 个输出特征)
import torch
import torch.nn as nn
linear = nn.Linear(5, 2)  # in_features=5, out_features=2,内部有 weight(2,5) 和 bias(2)
常数初始化
接口:
nn.init.zeros_(tensor)nn.init.ones_(tensor)nn.init.constant_(tensor, val)
功能:将张量(如权重)全部初始化为 0、1 或指定常数。
参数:
tensor:待初始化的张量val:constant_中使用的常数
示例代码:
# 整体流程:建全连接层 → 分别演示 zeros_/ones_/constant_ 三种常数初始化
linear = nn.Linear(5, 2)
# 全部参数初始化为 0(zeros_ 为原地操作,下划线表示修改 tensor 自身)
nn.init.zeros_(linear.weight)
print(linear.weight)
nn.init.ones_(linear.weight)  # 全部置 1
print(linear.weight)
nn.init.constant_(linear.weight, 10)  # 第二个参数 val:常数
print(linear.weight)
注意:将权重初始值设为 0 将无法正确进行学习。严格地说,不能将权重初始值设成一样的值。因为这意味着反向传播时权重全部都会进行相同的更新,被更新为相同的值(对称的值)。这使得神经网络拥有许多不同的权重的意义丧失了。为了防止"权重均一化"(瓦解权重的对称结构),必须随机生成初始值。
秩初始化
接口:nn.init.eye_(tensor)
功能: 将张量初始化为单位矩阵(要求二维方阵)。
参数:
tensor:待初始化的二维张量
示例代码:
# 整体流程:建层 → 权重初始化为单位矩阵(要求二维,行/列取较小者构成单位块)
linear = nn.Linear(5, 2)
nn.init.eye_(linear.weight)  # weight 形状 (2,5),得到 2x2 单位块
print(linear.weight)
正态分布初始化
接口:nn.init.normal_(tensor, mean=0.0, std=1.0)
功能:按指定均值和标准差的正态分布初始化张量。
参数:
tensor:待初始化的张量mean:均值std:标准差
示例代码:
# 整体流程:建层 → 按正态分布初始化权重
linear = nn.Linear(5, 2)
nn.init.normal_(linear.weight, mean=0.0, std=1.0)
print(linear.weight)
均匀分布初始化
接口:nn.init.uniform_(tensor, a=0.0, b=1.0)
功能:在区间 [a, b] 上均匀分布初始化张量。
参数:
tensor:待初始化的张量a:下界b:上界
示例代码:
# 整体流程:建层 → 在区间 [a, b] 上均匀分布初始化
linear = nn.Linear(5, 2)
nn.init.uniform_(linear.weight, a=0, b=10)  # a 下界,b 上界
print(linear.weight)
Xavier 初始化(Glorot)
接口:
nn.init.xavier_normal_(tensor):Xavier 正态。均值为 0,标准差为 $ \sqrt{2/(n_{in}+n_{out})} $nn.init.xavier_uniform_(tensor):Xavier 均匀。在$ \left[-\sqrt{6/(n_{in}+n_{out})},\sqrt{6/(n_{in}+n_{out})}\right] $ 内均匀分布
功能:Xavier(Glorot)初始化,按输入/输出维度调整初始范围,使每层输出方差与输入相近,适用于 Sigmoid、Tanh 等,缓解梯度消失或爆炸问题。
参数:
tensor:待初始化的张量
其中 $ n_{in} $ 表示输入数,$ n_{out} $ 表示输出数。
示例代码:
# 整体流程:建层 → 分别用 Xavier 正态、Xavier 均匀初始化
linear = nn.Linear(5, 2)
nn.init.xavier_normal_(linear.weight)  # 按 n_in+n_out 缩放的正态分布
print(linear.weight)
nn.init.xavier_uniform_(linear.weight)  # 按 n_in+n_out 缩放的均匀分布
print(linear.weight)
He 初始化(Kaiming)
接口:
nn.init.kaiming_normal_(tensor, mode='fan_in', nonlinearity='relu'):He 正态分布初始化。均值为0,标准差为$ \sqrt{\frac{2}{n_{in}}} $的正态分布。nn.init.kaiming_uniform_(tensor, ...):He 均匀分布初始化。区间$ \left\lbrack - \sqrt{\frac{6}{n_{in}}},\sqrt{\frac{6}{n_{in}}} \right\rbrack $内均匀分布。
功能:He(Kaiming)初始化,按输入神经元数量调整初始范围,适用于 ReLU 及其变体(如 Leaky ReLU)。
参数:
tensor:待初始化的张量mode:'fan_in'或'fan_out'**fan_in**:指的是考虑前一层(即当前层的输入)的节点数量。当使用'fan_in'模式时,初始化策略倾向于基于进入当前层的数据量来设置权重的尺度。这种方法有助于确保激活值不会因为太大的权重而变得过大,从而避免梯度爆炸问题。**fan_out**:则关注的是后一层(即当前层的输出)的节点数量。选择'fan_out'意味着权重的初始化将更多地考虑到从当前层传递到下一层的信息量。这有助于保持信息流动的有效性,并且对于防止梯度消失特别有用。
nonlinearity:激活函数名,如'relu'、'leaky_relu'
其中$ n_{in} $表示输入数。
示例代码:
# 整体流程:建层 → 分别用 He(Kaiming)正态、均匀初始化,适用于 ReLU
linear = nn.Linear(5, 2)
nn.init.kaiming_normal_(linear.weight)  # 默认 mode='fan_in', nonlinearity='relu'
print(linear.weight)
nn.init.kaiming_uniform_(linear.weight)
print(linear.weight)
随机失活
接口:nn.Dropout(p=0.5)
功能:训练时以概率 p 将元素置 0,其余按 1/(1-p) 缩放;评估时不失活。用于随机关闭神经元以减轻过拟合。
参数:
p:元素被置 0 的概率(默认 0.5)
示例代码:
# 整体流程:实例化 Dropout(p=0.5) → 生成输入 → 前向一次看“失活”效果(约一半置 0、其余放大)
import torch
dropout = torch.nn.Dropout(p=0.5)  # p:被置 0 的概率,训练时生效
x = torch.randint(1, 10, (10,), dtype=torch.float32)  # 随机整数张量,仅作演示
print("Dropout前:", x)
print("Dropout后:", dropout(x))  # 每次调用随机掩码不同
搭建神经网络
自定义模型
接口:继承 nn.Module,实现 __init__ 与 forward(input)。
功能:所有神经网络模块的基类;自定义模型需继承此类并实现前向传播。
参数:在 __init__ 中定义子模块与参数,在 forward 中接收输入并返回输出。
在神经网络框架中,由多个层组成的组件称之为 模块(Module)。在 PyTorch 中模型和各网络层都是 Module。在定义时需主要实现两个方法:
**__init__**:定义网络各层的结构,并初始化参数。forward:根据输入进行前向传播,并返回输出。计算其输出关于输入的梯度,可通过其反向传播函数进行访问(通常自动发生)。forward方法是每次调用的具体实现。
接下来使用 PyTorch 实现下图的神经网络:

- 第 1 个隐藏层:使用 Xavier 正态分布初始化权重,激活函数使用 Tanh。
- 第 2 个隐藏层:使用 He 正态分布初始化权重,激活函数使用 ReLU。
- 输出层:按默认方式初始化,激活函数使用 Softmax。
完整代码:
# 整体流程:
# 1. 继承 nn.Module 定义模型(__init__ 建层与初始化,forward 写前向)
# 2. 实例化并前向
# 3. 用 named_parameters/state_dict 查看参数
import torch
import torch.nn as nn
class Model(nn.Module):
    def __init__(self):
        super(Model, self).__init__()  # 必须调用,注册子模块与参数
        self.linear1 = nn.Linear(3, 4)  # 第1隐藏层:3 入 4 出
        nn.init.xavier_normal_(self.linear1.weight)  # Xavier 正态,适合 Tanh
        self.linear2 = nn.Linear(4, 4)
        nn.init.kaiming_normal_(self.linear2.weight)  # He 正态,适合 ReLU
        self.out = nn.Linear(4, 2)  # 输出层:2 类
    def forward(self, x):
        x = self.linear1(x)
        x = torch.tanh(x)  # 激活
        x = self.linear2(x)
        x = torch.relu(x)
        x = self.out(x)
        x = torch.softmax(x, dim=1)  # dim=1:在特征维做 softmax,每行和为 1
        return x
model = Model()
output = model(torch.randn(10, 3))  # 10 样本、3 特征,randn 标准正态
print("输出:\\n", output)
print("模型参数:")
for name, param in model.named_parameters():  # 返回 (名字, 张量)
    print(name, param)
print("模型参数:\\n", model.state_dict())  # 有序字典,用于保存/加载
查看模型结构和参数数量
接口:torchsummary.summary(model, input_size, batch_size=None, device='cuda')
功能:打印模型结构和各层参数数量。
参数:
model:待查看的模型input_size:输入形状(如(3,)表示 3 个特征)batch_size:可选,批大小device:运行设备
示例代码:
# 整体流程:导入 summary → 传入已建好的 model、输入形状、batch_size、设备,打印结构与参数量
from torchsummary import summary
summary(model, input_size=(3,), batch_size=10, device="cpu")  # (3,) 表示单样本 3 维输入
以上面案例中的第1个隐藏层为例:每个节点有3个权重与1个偏置,计4个参数,4个节点共计16个参数。
顺序构建模型
接口:nn.Sequential(*args) 或 nn.Sequential(OrderedDict([...]))
功能:按顺序组合多个模块,输入依次经过各子模块得到输出。
参数:
*args:按顺序排列的多个nn.Module实例
将各层按顺序传入即可构建模型。
示例代码:
# 整体流程:用 Sequential 按顺序堆叠层 → 定义 init_weights 并用 apply 初始化 → 前向得到输出
import torch
import torch.nn as nn
model = nn.Sequential(  # *args:按顺序的多个 Module,输入依次经过
    nn.Linear(3, 4),
    nn.Tanh(),
    nn.Linear(4, 4),
    nn.ReLU(),
    nn.Linear(4, 2),
    nn.Softmax(dim=1),  # dim=1 在特征维做 softmax
)
def init_weights(m):  # 每个子模块会作为 m 传入
    if type(m) == nn.Linear:
        nn.init.xavier_uniform_(m.weight)
        m.bias.data.fill_(0.01)  # 偏置置为 0.01
model.apply(init_weights)  # 对每个子模块调用 init_weights 一次
output = model(torch.randn(10, 3))
print("输出:\\n", output)
Sequential 类使模型构造变得简单,不必自定义类就可以组合新的架构。然而并不是所有的架构都是简单的顺序架构,当需要更强的灵活性时还是需要自定义模型。
损失函数
分类任务损失函数
二分类交叉熵损失
公式:
$ L = - \frac{1}{n}\sum_{i = 1}^{n}\left( y_{i}\log\widehat{y_{i}} + \left( 1 - y_{i} \right)\log\left( 1 - \widehat{y_{i}} \right) \right) $
其中:
- $ y_{i} $为真实值(通常为0或1)
- $ \widehat{y_{i}} $为预测值(表示样本$ i $为1的概率)
接口:nn.BCELoss(weight=None, reduction='mean')
功能:二分类交叉熵损失(Binary Cross-Entropy),用于二分类任务;输入为概率(如经 Sigmoid 后),目标为 0/1。
参数:
weight:可选,各类别权重reduction:'none'/'mean'/'sum'
示例代码:
# 整体流程:准备真实标签与预测概率(经 sigmoid)→ 实例化 BCELoss → 计算标量损失
import torch
import torch.nn as nn
target = torch.tensor([[1], [0], [0]], dtype=torch.float32)  # 真实标签 0/1
input = torch.randn((3, 1))  # 3 样本 1 维 logits
prediction = torch.sigmoid(input)  # BCELoss 要求输入为概率
loss = nn.BCELoss()  # reduction 默认 'mean'
print(loss(prediction, target))  # 传入 (预测, 目标),顺序不可反
多类交叉熵损失
公式:
$ L = - \frac{1}{n}\sum_{i = 1}^{n}{\sum_{c = 1}^{C}{y_{i,c}\log\widehat{y_{i,c}}}} $
其中:
- C是类别数
- $ y_{i,c} $为真实值(表示$ y_{i} $是否为类别c,通常为0或1)
- $ \widehat{y_{i,c}} $为预测值(表示样本$ i $为类别c的概率)
接口:nn.CrossEntropyLoss(weight=None, ignore_index=-100, reduction='mean')
功能:多类交叉熵损失;输入为未做 Softmax 的 logits,目标为类别索引或类别概率。内部含 LogSoftmax + NLLLoss,故前一层的输出不需再做 Softmax。
参数:
weight:可选,类别权重ignore_index:忽略的类别索引reduction:'none'/'mean'/'sum'
在PyTorch中可使用torch.nn.CrossEntropyLoss 实现:
注意:调用torch.nn.CrossEntropyLoss相当于调用了torch.nn.LogSoftmax之后再调用torch.nn.NLLLoss。即使用CrossEntropyLoss时上一层的输出不需要Softmax激活函数,因为该损失函数内会自动处理。
# 整体流程:准备 logits 与标签(或软标签)→ 实例化 CrossEntropyLoss → 计算损失(内部含 Softmax,无需先 softmax)
import torch
import torch.nn as nn
# 用法一:目标为类别索引(长整型,范围 [0, C-1])
target = torch.tensor([1, 0, 3, 2, 5, 4])  # 6 个样本的类别下标
input = torch.randn((6, 8))  # 6 样本 8 类,未做 softmax 的 logits
loss = nn.CrossEntropyLoss()
print(loss(input, target))
# 用法二:目标为概率分布(软标签)
target = torch.randn(6, 8).softmax(dim=1)  # 每行和为 1
input = torch.randn((6, 8))
print(loss(input, target))
回归任务损失函数
平均绝对误差(MAE)
公式:
$ L = \frac{1}{n}\sum_{i = 1}^{n}\left| y_{i} - \widehat{y_{i}} \right| $
接口:nn.L1Loss(reduction='mean')
功能:平均绝对误差(MAE/L1),对异常值较鲁棒,在 0 处不可导。
参数:
reduction:'none'/'mean'/'sum'
L1 Loss 对异常值鲁棒,但在0点处不可导。
均方误差(MSE)
公式:
$ L = \frac{1}{n}\sum_{i = 1}^{n}\left( y_{i} - \widehat{y_{i}} \right)^{2} $
接口:nn.MSELoss(reduction='mean')
功能:均方误差(MSE/L2),对异常值敏感。
参数:
reduction:'none'/'mean'/'sum'
L2 Loss对异常值敏感,遇到异常值时易发生梯度爆炸。
L1 损失
公式:
$ Smooth\ L1 = \left{ \begin{array}{r}
\frac{1}{2}\left( y_{i} - \widehat{y_{i}} \right)^{2},\left| y_{i} - \widehat{y_{i}} \right| < 1 (L2 \
Loss)\
\left| y_{i} - \widehat{y_{i}} \right| - \frac{1}{2},\left| y_{i} - \widehat{y_{i}} \right| \geq 1 (L1 \
Loss)
\end{array} \right.\ $
接口:nn.SmoothL1Loss(reduction='mean')
功能:平滑 L1:误差绝对值 < 1 时用 L2(平滑可导),≥ 1 时用 L1,兼顾可导性与对异常值的鲁棒性。
参数:
reduction:'none'/'mean'/'sum'
当误差较小时($ \left| y_{i} - \widehat{y_{i}} \right| < 1 $)使用 L2 Loss,使得损失函数平滑可导。当误差较大时($ \left| y_{i} - \widehat{y_{i}} \right| \geq 1 $)使用 L1 Loss 降低异常值的影响。
示例代码:
# 整体流程:定义模型(手动赋 weight/bias)→ 前向算 loss → backward → 优化器 step → zero_grad;演示一次迭代
import torch
import torch.nn as nn
import torch.optim as optim

class Model(nn.Module):
    def __init__(self):
        super(Model, self).__init__()
        self.linear1 = nn.Linear(5, 3)  # 5 入 3 出
        self.linear1.weight.data = torch.tensor(
            [[0.1, 0.2, 0.3], [0.4, 0.5, 0.6], [0.7, 0.8, 0.9],
             [0.10, 1.1, 1.2], [1.3, 1.4, 1.5]]).T  # 手动设权重,.T 转成 (3,5)
        self.linear1.bias.data = torch.tensor([1.0, 2.0, 3.0])
    def forward(self, x):
        return self.linear1(x)

model = Model()
X = torch.tensor([[1, 2, 3, 4, 5], [6, 7, 8, 9, 10]], dtype=torch.float)  # 2 样本 5 特征
target = torch.tensor([[0, 0, 0], [0, 0, 0]], dtype=torch.float)
output = model(X)

loss_fn = nn.MSELoss()  # 均方误差,reduction 默认 'mean'
loss_fn(output, target).backward()  # 反向传播,梯度写入各 param.grad
optimizer = optim.SGD(model.parameters(), lr=1)  # params:要更新的参数,lr 学习率
optimizer.step()  # 按梯度更新参数
optimizer.zero_grad()  # 清空梯度,下次 backward 前必须调
for i in model.state_dict():
    print(i, model.state_dict()[i])
参数更新方法
Momentum 动量法
Momentum(动量法)会保存历史梯度并给予一定的权重,使其也参与到参数更新中:
$ V \leftarrow \alpha V - \eta\nabla $
$ W \leftarrow W + V $
- $ V $:历史(负)梯度的加权和
- $ \alpha $:历史梯度的权重
- $ \nabla $:当前梯度,即$ \ \frac{\partial L}{\partial W} $
- $ \eta $:学习率
接口:torch.optim.SGD(params, lr=..., momentum=0, dampening=0, weight_decay=0)
功能:随机梯度下降;当 momentum > 0 时为动量法,用历史梯度的加权和参与更新,加速收敛、减轻震荡。
参数:
params:待优化参数lr:学习率momentum:动量系数(历史梯度权重)
可以通过torch.optim.SGD() 并设置momentum历史梯度权重参数来使用动量法。
示例:寻找$ f\left( x_{1},x_{2} \right) = 0.05x_{1}^{2} + x_{2}^{2} $的最小值。
# 辅助函数:梯度下降迭代,返回优化轨迹 X_arr(需在外部定义 w、n_iters)
def gradient_descent(X, optimizer, n_iters):
    import numpy as np
    X_arr = X.detach().numpy().copy()
    for epoch in range(n_iters):
        y = X**2 @ w
        y.backward()
        optimizer.step()
        optimizer.zero_grad()
        X_arr = np.vstack([X_arr, X.detach().numpy()])
    return X_arr
# 整体流程:定义变量与优化器 → 用 gradient_descent 跑 SGD 与 Momentum → 画等高线+轨迹对比
import numpy as np
import matplotlib.pyplot as plt
import torch

X = torch.tensor([-7.0, 2.0], requires_grad=True)  # 初始点
w = torch.tensor([[0.05], [1.0]], requires_grad=True)  # 目标函数系数,不更新
lr = 1e-2
n_iters = 500

# 普通 SGD(无动量)
X_clone = X.clone().detach().requires_grad_(True)
X_arr1 = gradient_descent(X_clone, torch.optim.SGD([X_clone], lr=lr), n_iters=n_iters)
plt.plot(X_arr1[:, 0], X_arr1[:, 1], "r")

# 动量法:momentum=0.9 表示历史梯度权重
X_clone = X.clone().detach().requires_grad_(True)
X_arr2 = gradient_descent(X_clone, torch.optim.SGD([X_clone], lr=lr, momentum=0.9), n_iters=n_iters)
plt.plot(X_arr2[:, 0], X_arr2[:, 1], "b")

x1_grid, x2_grid = np.meshgrid(np.linspace(-7, 7, 100), np.linspace(-2, 2, 100))
y_grid = w.detach().numpy()[0, 0] * x1_grid**2 + w.detach().numpy()[1, 0] * x2_grid**2
plt.contour(x1_grid, x2_grid, y_grid, levels=30, colors="gray")
plt.legend(["SGD", "Momentum"])
plt.show()
学习率衰减
等间隔衰减
接口:torch.optim.lr_scheduler.StepLR(optimizer, step_size, gamma=0.1)
功能:等间隔衰减;每 step_size 个 epoch 将学习率乘以 gamma。
参数:
optimizer:要调度的优化器step_size:衰减间隔(epoch 数)gamma:衰减倍数
示例:使学习率每隔 20 epoch 衰减为之前的 0.7。
# 整体流程:建优化器与 StepLR → 每步 optimizer.step 后 scheduler_lr.step() → 左图轨迹、右图学习率曲线
import numpy as np
import matplotlib.pyplot as plt
import torch

X = torch.tensor([-7.0, 2.0], dtype=torch.float32, requires_grad=True)
w = torch.tensor([[0.05], [1.0]], requires_grad=True)
lr = 0.9
n_iters = 1000
optimizer = torch.optim.SGD([X], lr=lr)
scheduler_lr = torch.optim.lr_scheduler.StepLR(optimizer, step_size=20, gamma=0.7)  # 每 20 步 lr*=0.7
X_arr = X.detach().numpy().copy()
lr_list = []

for epoch in range(n_iters):
    y = X**2 @ w
    y.backward()
    optimizer.step()
    optimizer.zero_grad()
    X_arr = np.vstack([X_arr, X.detach().numpy()])
    lr_list.append(optimizer.param_groups[0]["lr"])  # 当前学习率
    scheduler_lr.step()  # 每 epoch 调用一次,到 step_size 的倍数时衰减

plt.rcParams["font.sans-serif"] = ["KaiTi"]
plt.rcParams["axes.unicode_minus"] = False
fig, ax = plt.subplots(1, 2, figsize=(12, 4))
x1_grid, x2_grid = np.meshgrid(np.linspace(-7, 7, 100), np.linspace(-2, 2, 100))
y_grid = w.detach().numpy()[0, 0] * x1_grid**2 + w.detach().numpy()[1, 0] * x2_grid**2
ax[0].contour(x1_grid, x2_grid, y_grid, levels=30, colors="gray")
ax[0].plot(X_arr[:, 0], X_arr[:, 1], "r")
ax[0].set_title("梯度下降过程")
ax[1].plot(lr_list, "k")
ax[1].set_title("学习率衰减")
plt.show()
指定间隔衰减
接口:torch.optim.lr_scheduler.MultiStepLR(optimizer, milestones, gamma=0.1)
功能:在指定 epoch 处衰减;当 epoch 达到 milestones 中某一值时,学习率乘以 gamma。
参数:
optimizer:要调度的优化器milestones:衰减发生的 epoch 列表(如[10, 50, 200])gamma:衰减倍数
示例:使学习率在 epoch 达到 [10, 50, 200] 时衰减为之前的 0.7。
# 整体流程:MultiStepLR 在 milestones 指定的 epoch 处衰减(如 10、50、200 步时 lr*=0.7)
import numpy as np
import matplotlib.pyplot as plt
import torch

X = torch.tensor([-7.0, 2.0], dtype=torch.float32, requires_grad=True)
w = torch.tensor([[0.05], [1.0]], requires_grad=True)
lr = 0.9
n_iters = 400
optimizer = torch.optim.SGD([X], lr=lr)
scheduler_lr = torch.optim.lr_scheduler.MultiStepLR(optimizer, milestones=[10, 50, 200], gamma=0.7)
X_arr = X.detach().numpy().copy()
lr_list = []

for epoch in range(n_iters):
    y = X**2 @ w
    y.backward()
    optimizer.step()
    optimizer.zero_grad()
    X_arr = np.vstack([X_arr, X.detach().numpy()])
    lr_list.append(optimizer.param_groups[0]["lr"])
    scheduler_lr.step()

plt.rcParams["font.sans-serif"] = ["KaiTi"]
plt.rcParams["axes.unicode_minus"] = False
fig, ax = plt.subplots(1, 2, figsize=(12, 4))
x1_grid, x2_grid = np.meshgrid(np.linspace(-7, 7, 100), np.linspace(-2, 2, 100))
y_grid = w.detach().numpy()[0, 0] * x1_grid**2 + w.detach().numpy()[1, 0] * x2_grid**2
ax[0].contour(x1_grid, x2_grid, y_grid, levels=30, colors="gray")
ax[0].plot(X_arr[:, 0], X_arr[:, 1], "r")
ax[0].set_title("梯度下降过程")
ax[1].plot(lr_list, "k")
ax[1].set_title("学习率衰减")
plt.show()
指数衰减
接口:torch.optim.lr_scheduler.ExponentialLR(optimizer, gamma)
功能:指数衰减;每 epoch 学习率乘以 gamma,即 $ 学习率 \leftarrow 学习率 \times \gamma^{epoch} $。
参数:
optimizer:要调度的优化器gamma:底数(每 epoch 的衰减倍数)
示例:使学习率以 0.99 为底数、以 epoch 为指数衰减。
# 整体流程:ExponentialLR 每步 lr *= gamma(0.99),即指数衰减
import numpy as np
import matplotlib.pyplot as plt
import torch

X = torch.tensor([-7.0, 2.0], dtype=torch.float32, requires_grad=True)
w = torch.tensor([[0.05], [1.0]], requires_grad=True)
lr = 0.9
n_iters = 400
optimizer = torch.optim.SGD([X], lr=lr)
scheduler_lr = torch.optim.lr_scheduler.ExponentialLR(optimizer, gamma=0.99)  # 每 epoch lr *= 0.99
X_arr = X.detach().numpy().copy()
lr_list = []

for epoch in range(n_iters):
    y = X**2 @ w
    y.backward()
    optimizer.step()
    optimizer.zero_grad()
    X_arr = np.vstack([X_arr, X.detach().numpy()])
    lr_list.append(optimizer.param_groups[0]["lr"])
    scheduler_lr.step()

plt.rcParams["font.sans-serif"] = ["KaiTi"]
plt.rcParams["axes.unicode_minus"] = False
fig, ax = plt.subplots(1, 2, figsize=(12, 4))
x1_grid, x2_grid = np.meshgrid(np.linspace(-7, 7, 100), np.linspace(-2, 2, 100))
y_grid = w.detach().numpy()[0, 0] * x1_grid**2 + w.detach().numpy()[1, 0] * x2_grid**2
ax[0].contour(x1_grid, x2_grid, y_grid, levels=30, colors="gray")
ax[0].plot(X_arr[:, 0], X_arr[:, 1], "r")
ax[0].set_title("梯度下降过程")
ax[1].plot(lr_list, "k")
ax[1].set_title("学习率衰减")
plt.show()
AdaGrad
AdaGrad(Adaptive Gradient,自适应梯度)会为每个参数适当地调整学习率,并且随着学习的进行,梯度会逐渐减小。
$ H \leftarrow H + \nabla^{2} $
$ W \leftarrow W - \eta\frac{1}{\sqrt{H}}\nabla $
- $ H $:历史梯度的平方和
接口:torch.optim.Adagrad(params, lr=0.01, lr_decay=0, weight_decay=0)
功能:自适应梯度;按参数累积梯度平方和自适应调整学习率,梯度大时步长变小,适合稀疏梯度。
参数:
params:待优化参数lr:初始学习率lr_decay:学习率衰减(可选)
示例:寻找$ f\left( x_{1},x_{2} \right) = 0.05x_{1}^{2} + x_{2}^{2} $的最小值。
# 整体流程:定义 adagrad 手动实现与 gradient_descent → 同一起点跑 SGD / Adagrad / 手写 AdaGrad → 画三条轨迹
import numpy as np
import matplotlib.pyplot as plt
import torch

def adagrad(X, lr, n_iters):
    """AdaGrad 手动实现:H 累积梯度平方和,更新时用 lr/sqrt(H) 做自适应步长"""
    X_arr = X.detach().numpy().copy()
    H = torch.zeros_like(X)  # 历史梯度平方和
    for epoch in range(n_iters):
        grad = 2 * X * w.T  # 当前梯度(对该二次函数求导)
        grad.squeeze_()
        H += grad**2
        X.data -= lr / (torch.sqrt(H) + 1e-8) * grad  # 1e-8 防除零
        X_arr = np.vstack([X_arr, X.detach().numpy()])
    return X_arr

def gradient_descent(X, optimizer, n_iters):
    X_arr = X.detach().numpy().copy()
    for epoch in range(n_iters):
        y = X**2 @ w
        y.backward()
        optimizer.step()
        optimizer.zero_grad()
        X_arr = np.vstack([X_arr, X.detach().numpy()])
    return X_arr

X = torch.tensor([-7.0, 2.0], dtype=torch.float32, requires_grad=True)
w = torch.tensor([[0.05], [1.0]], requires_grad=True)
lr = 0.9
n_iters = 500
X_clone = X.clone().detach().requires_grad_(True)
X_arr1 = gradient_descent(X_clone, torch.optim.SGD([X_clone], lr=lr), n_iters=n_iters)
plt.plot(X_arr1[:, 0], X_arr1[:, 1], "r")
X_clone = X.clone().detach().requires_grad_(True)
X_arr2 = gradient_descent(X_clone, torch.optim.Adagrad([X_clone], lr=lr), n_iters=n_iters)  # Adagrad 自适应 lr
plt.plot(X_arr2[:, 0], X_arr2[:, 1], "b")
X_clone = X.clone().detach().requires_grad_(True)
X_arr1 = adagrad(X_clone, lr=lr, n_iters=n_iters)
plt.plot(X_arr1[:, 0], X_arr1[:, 1], c="orange", linestyle="--", linewidth=3)
x1_grid, x2_grid = np.meshgrid(np.linspace(-7, 7, 100), np.linspace(-2, 2, 100))
y_grid = w.detach().numpy()[0, 0] * x1_grid**2 + w.detach().numpy()[1, 0] * x2_grid**2
plt.contour(x1_grid, x2_grid, y_grid, levels=30, colors="gray")
plt.legend(["SGD", "AdaGrad", "Manual AdaGrad"])
plt.show()
RMSProp
RMSProp(Root Mean Square Propagation,均方根传播)是在 AdaGrad 基础上的改进,采用指数移动加权平均,呈指数地减小过去梯度的尺度。
$ H \leftarrow \alpha H + (1 - \alpha)\nabla^{2} $
$ W \leftarrow W - \eta\frac{1}{\sqrt{H}}\nabla $
- $ H $:历史梯度平方和的指数移动加权平均
- $ \alpha $:权重
接口:torch.optim.RMSprop(params, lr=0.01, alpha=0.99, eps=1e-08, weight_decay=0)
功能:均方根传播;用梯度的指数移动平均平方根缩放学习率,缓解 AdaGrad 学习率过快下降。
参数:
params:待优化参数lr:学习率alpha:平滑系数(梯度平方的衰减)
示例:寻找$ f\left( x_{1},x_{2} \right) = 0.05x_{1}^{2} + x_{2}^{2} $的最小值。
# 整体流程:手写 RMSProp(H 为梯度平方的指数移动平均)与 gradient_descent → 对比 SGD / RMSProp / 手写
import numpy as np
import matplotlib.pyplot as plt
import torch

def rmspropp(X, lr, alpha, n_iters):
    """RMSProp:H = alpha*H + (1-alpha)*grad^2,步长 lr/sqrt(H),alpha 为衰减系数"""
    X_arr = X.detach().numpy().copy()
    H = torch.zeros_like(X)
    for epoch in range(n_iters):
        grad = 2 * X * w.T
        grad.squeeze_()
        H = alpha * H + (1 - alpha) * grad**2  # 指数移动平均,非简单累加
        X.data -= lr / (torch.sqrt(H) + 1e-8) * grad
        X_arr = np.vstack([X_arr, X.detach().numpy()])
    return X_arr

def gradient_descent(X, optimizer, n_iters):
    X_arr = X.detach().numpy().copy()
    for epoch in range(n_iters):
        y = X**2 @ w
        y.backward()
        optimizer.step()
        optimizer.zero_grad()
        X_arr = np.vstack([X_arr, X.detach().numpy()])
    return X_arr

X = torch.tensor([-7.0, 2.0], dtype=torch.float32, requires_grad=True)
w = torch.tensor([[0.05], [1.0]], requires_grad=True)
lr = 1e-1
n_iters = 1000
X_clone = X.clone().detach().requires_grad_(True)
X_arr1 = gradient_descent(X_clone, torch.optim.SGD([X_clone], lr=lr), n_iters=n_iters)
plt.plot(X_arr1[:, 0], X_arr1[:, 1], "r")
X_clone = X.clone().detach().requires_grad_(True)
X_arr2 = gradient_descent(X_clone, torch.optim.RMSprop([X_clone], lr=lr, alpha=0.99), n_iters=n_iters)  # alpha 平滑系数
plt.plot(X_arr2[:, 0], X_arr2[:, 1], "b")
X_clone = X.clone().detach().requires_grad_(True)
X_arr1 = rmspropp(X_clone, lr=lr, alpha=0.99, n_iters=n_iters)
plt.plot(X_arr1[:, 0], X_arr1[:, 1], c="orange", linestyle="--", linewidth=3)
x1_grid, x2_grid = np.meshgrid(np.linspace(-7, 7, 100), np.linspace(-2, 2, 100))
y_grid = w.detach().numpy()[0, 0] * x1_grid**2 + w.detach().numpy()[1, 0] * x2_grid**2
plt.contour(x1_grid, x2_grid, y_grid, levels=30, colors="gray")
plt.legend(["SGD", "RMSProp", "Manual RMSProp"])
plt.show()
Adam
Adam(Adaptive Moment Estimation,自适应矩估计)融合了 Momentum 和 AdaGrad 的方法。
$ v \leftarrow \alpha_{1}v + \left( 1 - \alpha_{1} \right)\nabla $
$ h \leftarrow \alpha_{2}h + \left( 1 - \alpha_{2} \right)\nabla^{2} $
$ \widehat{v} = \frac{v}{1 - \alpha_{1}^{t}} $
$ \widehat{h} = \frac{h}{1 - \alpha_{2}^{t}} $
$ W \leftarrow W - \eta\frac{\widehat{v}}{\sqrt{\widehat{h}}} $
- $ \eta $:学习率
- $ \alpha_{1}、\alpha_{2} $:一次动量系数和二次动量系数
- $ t $:迭代次数,从1开始
接口:torch.optim.Adam(params, lr=0.001, betas=(0.9, 0.999), eps=1e-08, weight_decay=0)
功能:自适应矩估计;结合一阶矩(动量)与二阶矩(类似 AdaGrad)的自适应学习率,常用默认优化器。
参数:
params:待优化参数lr:学习率betas:一阶、二阶矩的衰减率eps:数值稳定项
示例代码:
# 整体流程:手写 Adam(V 一阶矩、H 二阶矩,偏置修正后更新)与 gradient_descent → 对比 SGD / Adam / 手写
import numpy as np
import matplotlib.pyplot as plt
import torch

def adam(X, lr, betas, n_iters):
    """Adam:V 一阶矩,H 二阶矩;V_hat/H_hat 为偏置修正,betas=(β1, β2) 通常 (0.9, 0.999)"""
    X_arr = X.detach().numpy().copy()
    V = torch.zeros_like(X)
    H = torch.zeros_like(X)
    for epoch in range(n_iters):
        grad = 2 * X * w.T
        grad.squeeze_()
        V = betas[0] * V + (1 - betas[0]) * grad  # 一阶矩
        H = betas[1] * H + (1 - betas[1]) * grad**2  # 二阶矩
        V_hat = V / (1 - betas[0] ** (epoch + 1))  # 偏置修正
        H_hat = H / (1 - betas[1] ** (epoch + 1))
        X.data -= lr * V_hat / (torch.sqrt(H_hat) + 1e-8)
        X_arr = np.vstack([X_arr, X.detach().numpy()])
    return X_arr

def gradient_descent(X, optimizer, n_iters):
    X_arr = X.detach().numpy().copy()
    for epoch in range(n_iters):
        y = X**2 @ w
        y.backward()
        optimizer.step()
        optimizer.zero_grad()
        X_arr = np.vstack([X_arr, X.detach().numpy()])
    return X_arr

X = torch.tensor([-7.0, 2.0], dtype=torch.float32, requires_grad=True)
w = torch.tensor([[0.05], [1.0]], requires_grad=True)
lr = 1e-1
n_iters = 1000
X_clone = X.clone().detach().requires_grad_(True)

X_arr1 = gradient_descent(X_clone, torch.optim.SGD([X_clone], lr=lr), n_iters=n_iters)
plt.plot(X_arr1[:, 0], X_arr1[:, 1], "r")
X_clone = X.clone().detach().requires_grad_(True)

X_arr2 = gradient_descent(X_clone, torch.optim.Adam([X_clone], lr=lr, betas=(0.9, 0.999)), n_iters=n_iters)  # betas 一阶、二阶矩衰减
plt.plot(X_arr2[:, 0], X_arr2[:, 1], "b")
X_clone = X.clone().detach().requires_grad_(True)

X_arr1 = adam(X_clone, lr=lr, betas=(0.9, 0.999), n_iters=n_iters)
plt.plot(X_arr1[:, 0], X_arr1[:, 1], c="orange", linestyle="--", linewidth=3, alpha=0.7)
x1_grid, x2_grid = np.meshgrid(np.linspace(-7, 7, 100), np.linspace(-2, 2, 100))
y_grid = w.detach().numpy()[0, 0] * x1_grid**2 + w.detach().numpy()[1, 0] * x2_grid**2
plt.contour(x1_grid, x2_grid, y_grid, levels=30, colors="gray")
plt.legend(["SGD", "Adam", "Manual Adam"])
plt.show()
案例:房价预测
House Prices 数据集:House Prices - Advanced Regression Techniques。
(原文档附带的附件请到语雀源文档查看)
相关字段:
- 特征工程
首先对特征进行处理,数值型特征使用均值填充缺失值,再标准化;类别型特征使用字符串"NaN"填充缺失值,再独特编码。之后构造数据集。
# 整体流程:读数据 → 划分特征/目标与数值/类别 → train_test_split → 数值用均值填充+标准化、类别用 NaN 填充+独热 → ColumnTransformer 组合 → TensorDataset
def create_dataset():
    import pandas as pd
    import torch
    from sklearn.model_selection import train_test_split
    from sklearn.pipeline import Pipeline
    from sklearn.impute import SimpleImputer
    from sklearn.preprocessing import StandardScaler, OneHotEncoder
    from sklearn.compose import ColumnTransformer
    from torch.utils.data import TensorDataset
    data = pd.read_csv("data/house_prices.csv")
    data.drop(["Id"], axis=1, inplace=True)  # axis=1 按列删,inplace 原地修改
    X = data.drop("SalePrice", axis=1)
    y = data["SalePrice"]
    numerical_features = X.select_dtypes(exclude="object").columns  # 数值列
    categorical_features = X.select_dtypes(include="object").columns  # 类别列
    x_train, x_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
    numerical_transformer = Pipeline(
        steps=[
            ("fillna", SimpleImputer(strategy="mean")),  # 缺失值用均值填
            ("std", StandardScaler()),  # 标准化
        ]
    )
    categorical_transformer = Pipeline(
        steps=[
            ("fillna", SimpleImputer(strategy="constant", fill_value="NaN")),
            ("onehot", OneHotEncoder(handle_unknown="ignore")),  # 未知类别忽略
        ]
    )
    preprocessor = ColumnTransformer(
        transformers=[
            ("num", numerical_transformer, numerical_features),
            ("cat", categorical_transformer, categorical_features),
        ]
    )
    x_train = pd.DataFrame(preprocessor.fit_transform(x_train).toarray(), columns=preprocessor.get_feature_names_out())
    x_test = pd.DataFrame(preprocessor.transform(x_test).toarray(), columns=preprocessor.get_feature_names_out())
    train_dataset = TensorDataset(torch.tensor(x_train.values).float(), torch.tensor(y_train.values).float())  # 特征+标签成对
    test_dataset = TensorDataset(torch.tensor(x_test.values).float(), torch.tensor(y_test.values).float())
    return train_dataset, test_dataset, x_train.shape[1]  # 最后一维为特征数
train_dataset, test_dataset, feature_num = create_dataset()
- 搭建模型
# 整体流程:全连接 → BatchNorm → ReLU → Dropout → 输出 1 维(房价)
model = nn.Sequential(
    nn.Linear(feature_num, 128),  # 输入特征数由 create_dataset 得到
    nn.BatchNorm1d(128),  # 一维 BN,稳定训练
    nn.ReLU(),
    nn.Dropout(0.2),  # 20% 失活防过拟合
    nn.Linear(128, 1),  # 回归输出 1 个数
)
- 损失函数
关于房价的预测我们更加关心相对误差$ \frac{\widehat{y} - y}{y} $而非绝对误差$ \widehat{y} - y $,比如房价原本20万元而误差10万元,那么误差可能难以接受;但若房价原本1000万元而误差为10万元,那误差可能并不算大。因此这里我们使用对数来衡量误差:
$ Loss = \sqrt{\frac{1}{n}\sum_{i = 1}^{n}\left( \log\widehat{y} - \log y \right)^{2}} $
# 整体流程:对预测与目标取 log 再算 RMSE,使相对误差更受关注;clamp 保证 log 合法
def log_rmse(pred, target):
    mse = nn.MSELoss()
    pred.squeeze_()  # 去掉多余维
    pred = torch.clamp(pred, 1, float("inf"))  # 限制 ≥1,避免 log≤0
    return torch.sqrt(mse(torch.log(pred), torch.log(target)))
- 模型训练
# 整体流程:Xavier 初始化 → 每 epoch 训练(DataLoader 批训练、log_rmse、backward、step)→ 验证(eval+no_grad)→ 记录并画 loss 曲线
from torch.utils.data import DataLoader
import matplotlib.pyplot as plt

def train(model, train_dataset, test_dataset, lr, epoch_num, batch_size, device):
    def init_weight(layer):
        if type(layer) == nn.Linear:
            nn.init.xavier_normal_(layer.weight)

    model.apply(init_weight)
    model = model.to(device)
    optimizer = torch.optim.Adam(model.parameters(), lr=lr)
    train_loss_list = []
    test_loss_list = []

    for epoch in range(epoch_num):
        model.train()  # Dropout/BatchNorm 按训练行为
        train_loader = DataLoader(train_dataset, batch_size=batch_size, shuffle=True)
        train_loss_accumulate = 0

        for batch_count, (X, y) in enumerate(train_loader):
            X, y = X.to(device), y.to(device)
            output = model(X)
            loss_value = log_rmse(output, y)
            optimizer.zero_grad()
            loss_value.backward()
            optimizer.step()
            train_loss_accumulate += loss_value.item()
            print(f"\repoch:{epoch:0>3}[{'='*int((batch_count+1)/len(train_loader)*50):<50}]", end="")
        this_train_loss = train_loss_accumulate / len(train_loader)
        train_loss_list.append(this_train_loss)

        model.eval()  # 评估模式,Dropout 关闭等
        test_loader = DataLoader(dataset=test_dataset, batch_size=batch_size, shuffle=True)
        test_loss_accumulate = 0
        with torch.no_grad():  # 验证不计算梯度
            for X, y in test_loader:
                X, y = X.to(device), y.to(device)
                output = model(X)
                test_loss_accumulate += log_rmse(output, y).item()  # 用当前 batch 的 loss
        this_test_loss = test_loss_accumulate / len(test_loader)
        test_loss_list.append(this_test_loss)

        print(f" train_loss:{this_train_loss:.6f}, test_loss:{this_test_loss:.6f}")

    return train_loss_list, test_loss_list

device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
train_loss_list, test_loss_list = train(model, train_dataset, test_dataset, 0.1, 200, 64, device)
plt.plot(train_loss_list, "r-", label="train_loss", linewidth=3)
plt.plot(test_loss_list, "k--", label="test_loss", linewidth=2)
plt.legend()
plt.show()
第九章 卷积神经网络
CNN 概述
卷积神经网络(Convolutional Neural Network,CNN)常被用于图像识别、语音识别等各种场合。它在计算机视觉领域表现尤为出色,广泛应用于图像分类、目标检测、图像分割等任务。
卷积神经网络的灵感来自于动物视觉皮层组织的神经连接方式,单个神经元只对有限区域内的刺激作出反应,不同神经元的感知区域相互重叠从而覆盖整个视野。
CNN 中新出现了卷积层(Convolution 层)和池化层(Pooling 层),下图是一个 CNN 的结构:

- 卷积层:在局部区域用卷积核做加权和,提取边缘、纹理等局部特征;参数共享,相比全连接参数量更少。
- 池化层:对特征图做下采样(如取窗口内最大值),降维、减少计算量,并对小位移有一定鲁棒性。
- 全连接层:将前面得到的特征展平后做分类或回归,与前面章节中的全连接用法一致。
典型流程为:卷积 → 激活 → 池化(可重复多段),最后接全连接输出。
卷积层
在全连接层中,相邻层的神经元全部连接在一起,输出的数量可以任意决定,但是却忽视了数据的形状。
比如,输入数据为图像时,图像通常是长、宽、通道方向上的 3 维数据,但是向全连接层输入时却需要将其拉平为 1 维数据,这种情况下 3 维形状的数据中的空间信息可能被全连接层忽视掉。
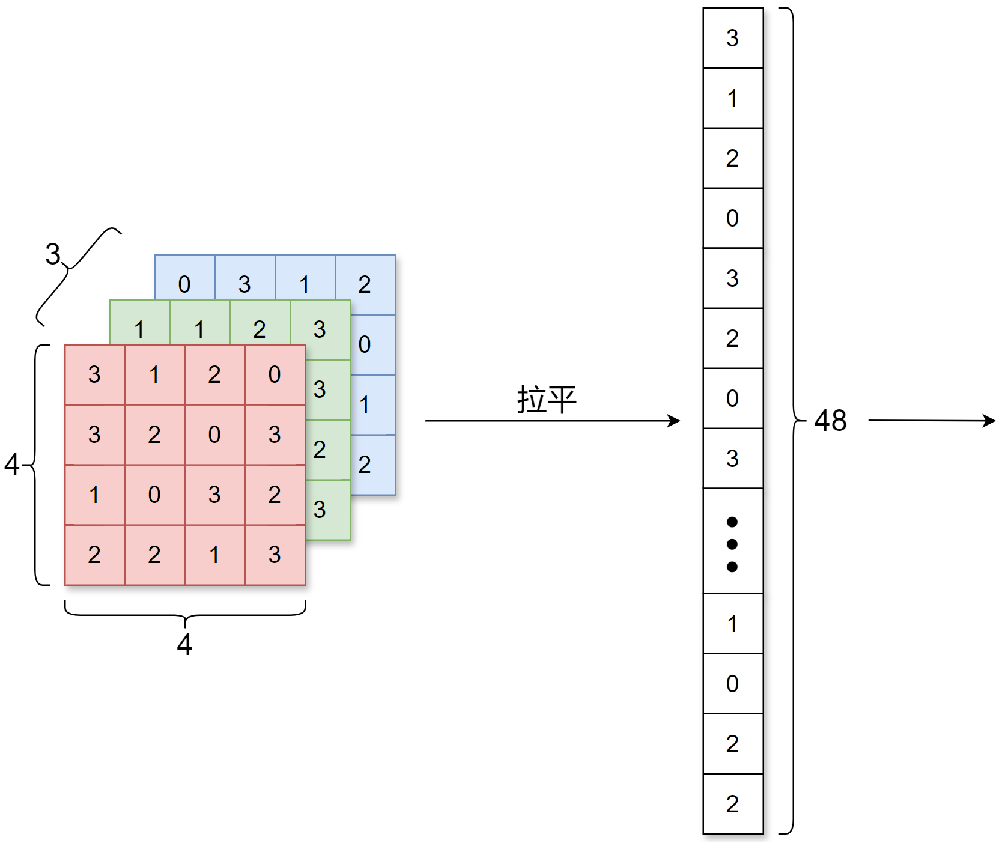
而卷积层可以保持数据形状不变,即接收 3 维形状的输入数据后同样以 3 维形状将数据输出至下一层。在 CNN 中,卷积层的输入、输出数据都称为特征图(feature map);输出特征图上每个位置对应输入的一个局部区域,通道数由卷积核的个数决定。
卷积运算
数学定义(二维离散卷积):设输入为 $ X $(高 $ H $、宽 $ W $),卷积核为 $ K $(高 $ FH $、宽 $ FW $)。在位置 $ (i,j) $ 处的卷积结果为该位置对应的局部块与卷积核逐元素相乘再求和:
$ (X * K)(i,j) = \sum_{a=0}^{FH-1} \sum_{b=0}^{FW-1} X(i+a,j+b) \cdot K(a,b) $
即用大小为 $ FH \times FW $ 的窗口在 $ X $ 上从左到右、从上到下滑动,每个窗口与 $ K $ 做内积(对应元素相乘后求和),得到一个标量;所有位置组成一张输出特征图。若加上偏置 $ b $,则输出为 $ (X*K)(i,j)+b $。
在 CNN 中,卷积层对数据进行卷积运算,相当于图像处理里的滤波器:在输入上滑动卷积核,每个位置将卷积核与对应局部输入逐元素相乘后求和,得到该位置的一个标量;整张图滑动一遍得到一张特征图。
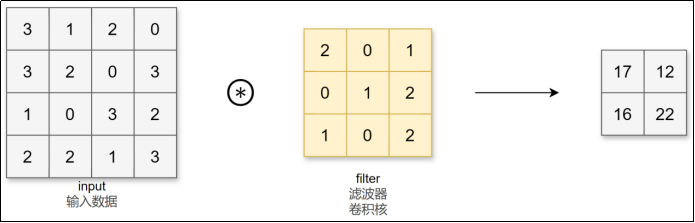
对于输入数据,卷积运算以一定间隔滑动卷积核的窗口并应用。将各个位置上卷积核的元素和输入的对应元素相乘,然后再求和(也称为乘积累加运算、矩阵的内积)。
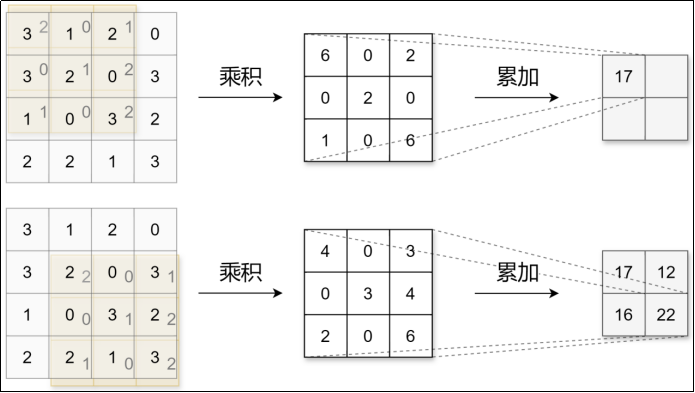
CNN 中,卷积核的参数对应之前的权重。并且 CNN 中也存在偏置。
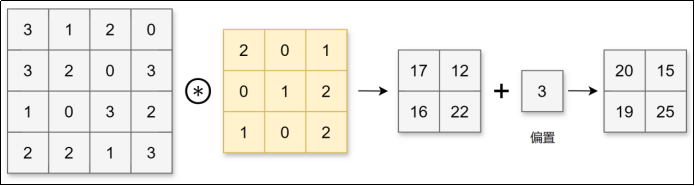
填充
在进行卷积层的处理之前,有时要向输入数据的周围填入固定的数据(比如 0),这称为填充(padding)。例如,对形状为 4×4 的数据进行幅度为 1 的填充,即用幅度为 1、值为 0 的数据填充周围:
可以看到,4×4 的数据进行幅度为 1 的填充后形状变为 6×6,再经过卷积后数据的形状为 4×4。使用填充主要目的是为了调整输出数据的形状大小,避免多次卷积后数据形状大小过小导致无法继续进行卷积运算。运用填充可以令数据形状在经过卷积运算后保持不变。
步幅
应用卷积核的位置间隔称之为步幅(stride)。之前的例子中步幅都为 1,下面我们进行步幅为 3 的卷积运算:
可以看到填充和步幅都会影响输出数据的形状大小。增大填充,输出数据形状大小会变大;增大步幅,输出数据形状大小会变小。
即给定输入形状 $ (H,W) $、卷积核 $ (FH,FW) $、填充 $ P $、步幅 $ S $,输出形状 $ (OH,OW) $ 为:
$ OH = \frac{H + 2P - FH}{S} + 1 $
$ OW = \frac{W + 2P - FW}{S} + 1 $
例如,对于形状为 $ (4,4) $ 的输入数据应用幅度为 1 的填充,并应用步幅为 3、卷积核大小为 $ (3,3) $ 的卷积运算:
$ OH = OW = \frac{4 + 2 - 3}{3} + 1 = 2 $
得到形状为 $ (2,2) $ 的输出数据。
当 $ (H+2P-FH) $ 或 $ (W+2P-FW) $ 不能被 $ S $ 整除时,PyTorch 会向下取整得到输出尺寸,即舍弃最右侧/最下侧无法被卷积核完整覆盖的输入部分。
注:希望卷积后高宽与输入相同(stride=1 时)可设 $ P=(FH-1)/2 $(如 3×3 核常用 padding=1)。
3 维卷积运算
图像是 3 维数据:高、宽、通道(如 RGB 为 3 通道)。卷积时:输入通道数必须与卷积核的通道数一致。对每个空间位置,先在每个通道上做二维卷积,再把各通道的结果相加(可加偏置),得到该位置的一个标量;因此一个卷积核得到一张特征图(一个输出通道)。要得到多通道输出,就使用多个卷积核($ FN $ 个卷积核 → $ FN $ 个输出通道)。
使用 1 个形状为$ (C,FH,FW) $的卷积核,对形状为$ (C,H,W) $的输入数据进行卷积运算,输出 1 张形状为$ (OH,OW) $特征图,即输出的通道数为 1。
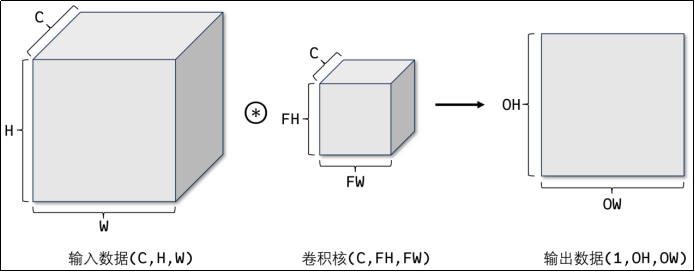
若想在通道方向获得多个卷积运算的输出,需要使用多个卷积核。
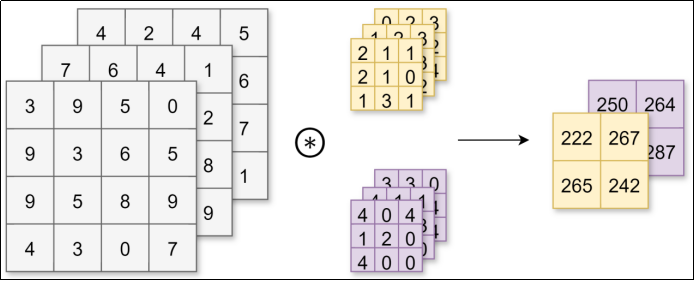
使用 $ FN $ 个卷积核,输出特征图也变为 $ FN $ 个:
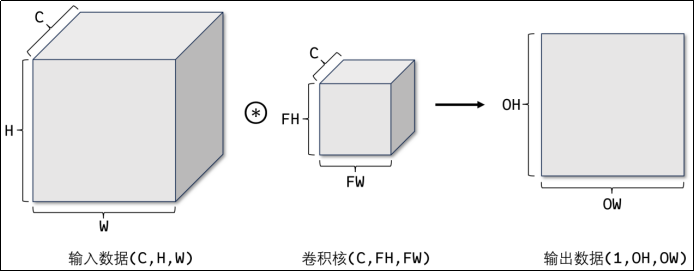
若考虑偏置:每个输出通道有一个标量偏置,与该通道上所有位置的卷积结果相加后再输出。
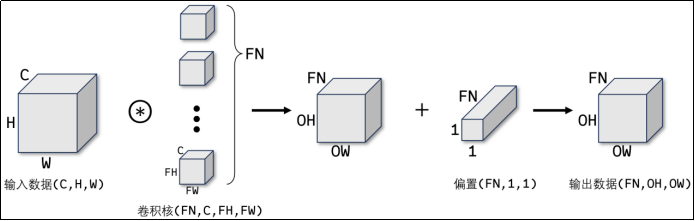
API 使用
接口:torch.nn.Conv2d(in_channels, out_channels, kernel_size, stride=1, padding=0)
参数:
in_channels输入通道数out_channels输出通道数(卷积核个数)kernel_size卷积核大小stride步幅padding填充幅度
示例代码:读入一张图片,转为 PyTorch 需要的 (C,H,W) 格式后做一次卷积,并并排显示原图与卷积结果,便于直观感受卷积的视觉效果。
import torch
import matplotlib.pyplot as plt

img = plt.imread("data/duck.jpg") # 改为其他任意图片均可
print("图片数据形状:", img.shape)
input = torch.tensor(img).permute(2, 0, 1).float() # permute(2, 0, 1) 用于将 (H, W, C) 格式的图像数据转换为 (C, H, W) 格式,以便符合 Conv2d 层的输入要求
print("输入特征图形状:", input.shape)
conv = torch.nn.Conv2d(in_channels=3, out_channels=3, kernel_size=9, stride=3, padding=0, bias=False) # bias=False 用于简化模型,去除偏置项
output = conv(input)
print("输出特征图形状:", output.shape)
output = torch.clamp(output.int(), 0, 255).permute(1, 2, 0).detach().numpy()

fig, ax = plt.subplots(1, 2, figsize=(10, 5))
ax[0].imshow(img)
ax[1].imshow(output)
plt.axis("off")
plt.show()
池化层
池化层缩小长、宽方向上的空间来进行降维,能够缩减模型的大小并提高计算速度。例如,对数据进行步幅为 2 的 2×2 的 Max 池化:
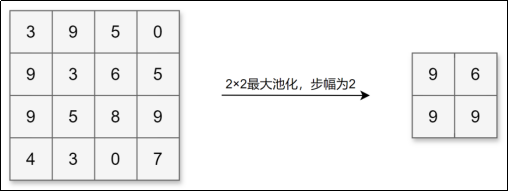
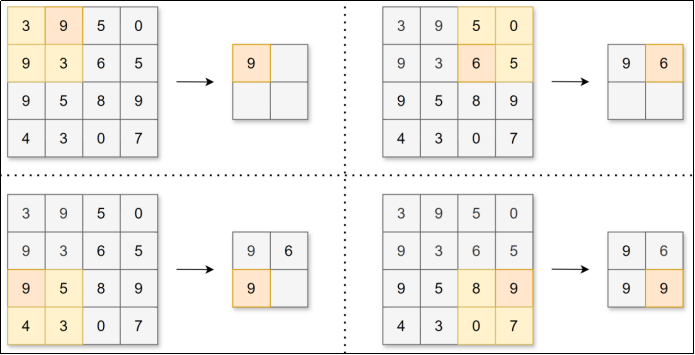
除了 Max 池化(取窗口内最大值,更常用,保留最显著响应)还有 Average 池化(取平均,输出更平滑)。一般将池化窗口与步幅设为相同,如 2×2 窗口、步幅 2,这样高宽各减半。池化也可设 padding。与卷积层不同:池化没有可学习参数,且按通道独立计算,输入输出通道数相同。
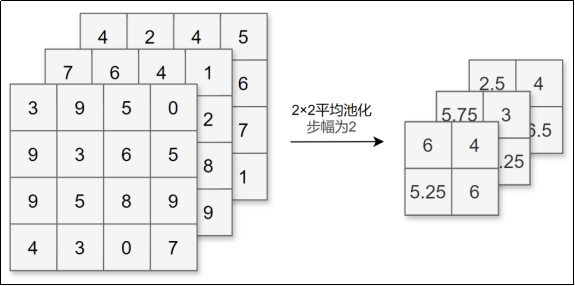
池化对微小偏差具有鲁棒性,数据发生微小偏差时,池化可能返回相同结果。
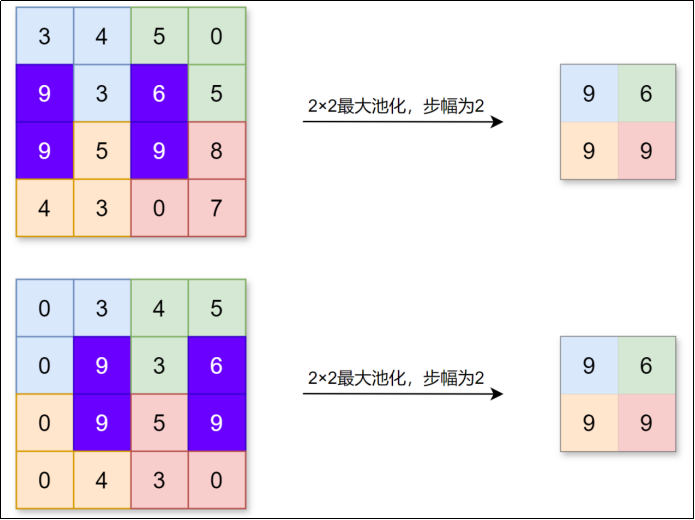
相关 API:
接口:
torch.nn.MaxPool2d(kernel_size, stride=None, padding=0):取窗口内最大值torch.nn.AvgPool2d(kernel_size, stride=None, padding=0):取窗口内平均值
参数:
kernel_size卷积核大小stride步幅。stride默认等于kernel_sizepadding填充幅度
示例:对一张图先做卷积得到 output1,再对 output1 做 MaxPool2d 得到 output2,左中右三图对比原图、卷积后、池化后的效果。
import torch
import matplotlib.pyplot as plt

img = plt.imread("../data/duck.jpg")
print("图片数据形状:", img.shape)

input = torch.tensor(img).permute(2, 0, 1).float()
print("输入特征图形状:", input.shape)

conv = torch.nn.Conv2d(
    in_channels=3, # 输入通道数
    out_channels=3, # 输出通道数
    kernel_size=4, # 卷积核大小
    stride=1, # 步长
    padding=0, # 填充
    bias=False # 禁用偏置项
)

output1 = conv(input)
print("卷积后输出特征图形状:", output1.shape)

pool = torch.nn.AvgPool2d(
    kernel_size=6, # 池化核大小
    stride=6, # 步长
    padding=1 # 填充
)
output2 = pool(output1)
print("池化后输出特征图形状:", output2.shape)

output1 = torch.clamp(output1.int(), 0, 255)
output1 = output1.permute(1, 2, 0).detach().numpy()
output2 = torch.clamp(output2.int(), 0, 255)
output2 = output2.permute(1, 2, 0).detach().numpy()

fig, ax = plt.subplots(1, 3, figsize=(15, 5))
ax[0].imshow(img)
ax[1].imshow(output1)
ax[2].imshow(output2)
plt.axis("off")
plt.show()
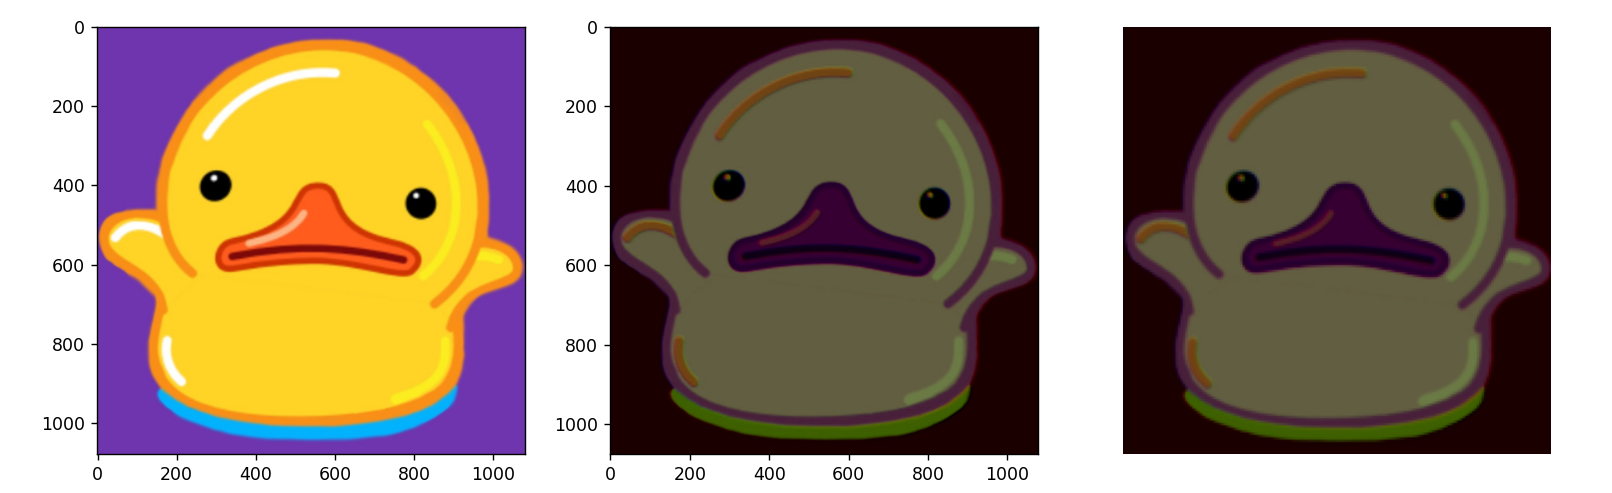
深度卷积神经网络
将网络加深可以提取更多层次的特征(浅层多为边缘纹理,深层多为语义);卷积的权重复用使参数量远小于同规模全连接,因此可以放心堆叠。正是深度 CNN 在 2012 年后推动了这一轮深度学习热潮。
- AlexNet

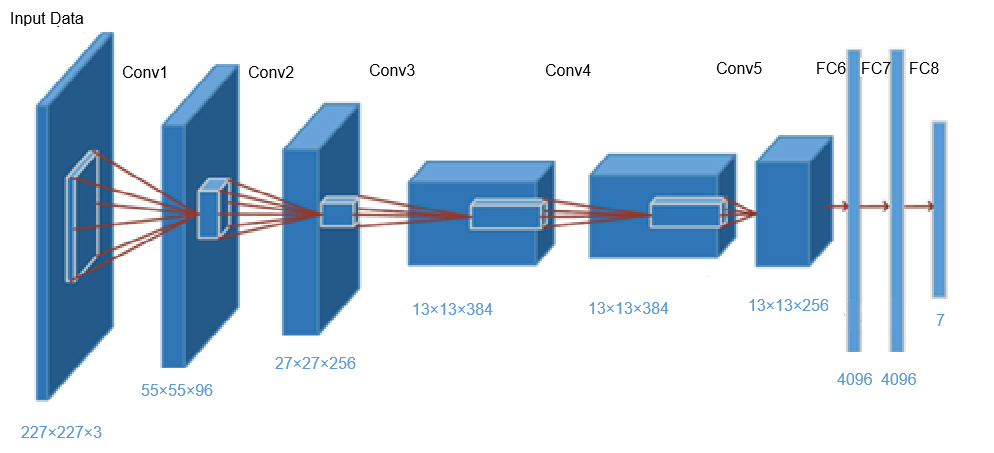
- VGG:2014 年牛津 VGG 组提出。

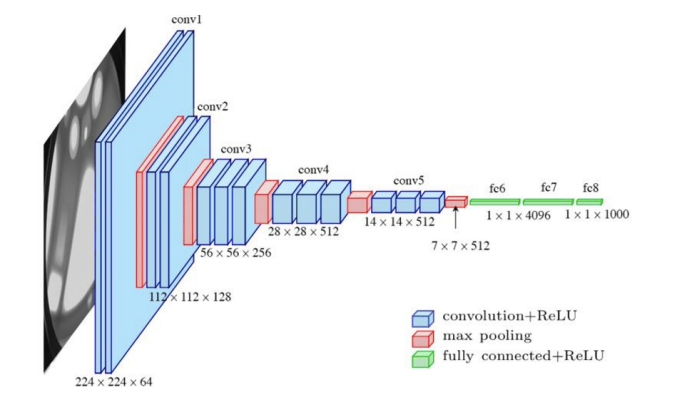
- GoogleNet:2014 年 Google 提出。 核心

- ResNet:2015 年何恺明等(微软)提出。 核心:残差学习,拟合 $ F(x)=h(x)-x $ 而非直接拟合 $ h(x) $,通过跨层 shortcut 把梯度直接传到前面层,从而能训练很深的网络。$ h(x)=F(x)+x $

案例:服装分类
使用 Fashion MNIST 数据集:Fashion MNIST。
每个样本为 28×28 灰度图,对应 10 个类别。标签对应如下:
- 0:T恤/上衣
- 1:裤子
- 2:套头衫
- 3:连衣裙
- 4:外套
- 5:凉鞋
- 6:衬衫
- 7:运动鞋
- 8:包
- 9:靴子
- 加载数据
数据在 csv 中:每行 1 个样本,第 1 列为标签,第 2~785 列为 784 个像素(28×28 展平)。需要 reshape 成 (N, 1, 28, 28),即 NCHW 格式(批量、通道、高、宽);灰度图通道数为 1。
import torch
import pandas as pd
import matplotlib.pyplot as plt
from torch.utils.data import TensorDataset, DataLoader

# ---------- 1. 读取 CSV ----------
# 每行:第 1 列为标签(0~9),第 2~785 列为 784 像素(28×28 展平)
fashion_mnist_train = pd.read_csv("data/fashion-mnist_train.csv")
fashion_mnist_test = pd.read_csv("data/fashion-mnist_test.csv")

# ---------- 2. 转为 Tensor 并调整为 NCHW ----------
# 像素 iloc[:, 1:] → float32,reshape 为 (N, 1, 28, 28);标签 iloc[:, 0] → int64
X_train = torch.tensor(fashion_mnist_train.iloc[:, 1:].values, dtype=torch.float32).reshape(-1, 1, 28, 28)
y_train = torch.tensor(fashion_mnist_train.iloc[:, 0].values, dtype=torch.int64)
X_test = torch.tensor(fashion_mnist_test.iloc[:, 1:].values, dtype=torch.float32).reshape(-1, 1, 28, 28)
y_test = torch.tensor(fashion_mnist_test.iloc[:, 0].values, dtype=torch.int64)

# ---------- 3. 可选:查看某张图 ----------
plt.imshow(X_train[12345, 0, :, :], cmap="gray")  # 第 0 通道即灰度
plt.show()

# ---------- 4. 构建 Dataset,供 DataLoader 按 batch 读取 ----------
train_dataset = TensorDataset(X_train, y_train)
test_dataset = TensorDataset(X_test, y_test)
- 搭建模型
结构示意:输入 28×28×1 → Conv(1→6, 5×5, pad2) → Sigmoid → AvgPool(2×2) → Conv(6→16, 5×5) → Sigmoid → AvgPool(2×2) → Flatten → 全连接 400→120→84→10。400 的由来:第二段池化后特征图形状为 (16, 5, 5),展平后 16×5×5=400。
import torch
import torch.nn as nn

# 按结构顺序堆叠:卷积 → 激活 → 池化 → … → 展平 → 全连接
model = nn.Sequential(
    # 第一段:1 通道 → 6 通道,5×5 卷积,padding=2 使高宽不变仍为 28×28
    nn.Conv2d(1, 6, kernel_size=5, padding=2),
    nn.Sigmoid(),
    nn.AvgPool2d(kernel_size=2, stride=2),   # 28×28 → 14×14
    # 第二段:6 → 16 通道,5×5 卷积(无 padding),再池化
    nn.Conv2d(6, 16, kernel_size=5),
    nn.Sigmoid(),
    nn.AvgPool2d(kernel_size=2, stride=2),   # 10×10 → 5×5,展平后 16×5×5=400
    nn.Flatten(),
    # 全连接:400 → 120 → 84 → 10(10 类)
    nn.Linear(400, 120),
    nn.Sigmoid(),
    nn.Linear(120, 84),
    nn.Sigmoid(),
    nn.Linear(84, 10),
)

# 调试用:逐层前向,打印每层输出形状,便于核对 400 等尺寸
X = torch.rand(size=(1, 1, 28, 28), dtype=torch.float32)
for layer in model:
    X = layer(X)
    print(f"{layer.__class__.__name__:<12} output shape: {X.shape}")
设计思路:这是 CNN 里常见的卷积特征提取 + 全连接分类结构,大致有三点说法:
- 卷积部分:逐层做「卷积 → 激活 → 池化」,相当于先提取层次化特征——浅层多学到边缘、纹理,深层多学到更抽象的部件甚至整体形状;同时空间尺寸逐渐变小、通道数逐渐变多,既压缩了空间信息又用更多通道表示更丰富的模式,计算量也可控。
- 池化:每段后的池化做降采样,减少后续计算量,并带来一定的平移不变性(物体稍微移动一点,池化后特征变化较小)。
- 展平 + 全连接:卷积输出仍是「多通道×高×宽」的 3 维张量;展平后变成一维向量,再用几层全连接做分类决策(把抽象特征映射到 10 个类别的分数)。也就是说,前面负责「从像素里抽出有用特征」,后面负责「根据特征判类别」。
整体思路来自 LeNet 等经典网络:先局部、逐层抽象,再在最后一截用全连接做分类;后面的 VGG、ResNet 等只是把卷积部分加深、加宽,最后仍常用全连接头出类别。
- 模型训练
要点:对 Linear 和 Conv2d 用 Xavier 初始化;损失用 CrossEntropyLoss(多分类),优化器用 SGD。model.train() 与 model.eval() 会切换 Dropout 等行为(训练时随机失活,验证时不失活);验证阶段用 torch.no_grad() 关闭梯度以省显存、提速。每 epoch 在训练集上更新参数,在测试集上只做前向并统计准确率。
def train(model, train_dataset, test_dataset, lr, epoch_num, batch_size, device):
    # ---------- 初始化 ----------
    def init_weights(layer):
        if type(layer) == nn.Linear or type(layer) == nn.Conv2d:
            nn.init.xavier_uniform_(layer.weight)
    model.apply(init_weights)
    model.to(device)
    loss_fn = nn.CrossEntropyLoss()
    optimizer = torch.optim.SGD(model.parameters(), lr=lr)

    for epoch in range(epoch_num):
        # ---------- 训练阶段 ----------
        model.train()  # 启用 Dropout 等训练行为
        train_loader = DataLoader(dataset=train_dataset, batch_size=batch_size, shuffle=True)
        loss_accumulate = 0.0
        train_correct_accumulate = 0
        for batch_count, (X, y) in enumerate(train_loader):
            X, y = X.to(device), y.to(device)
            output = model(X)
            loss_value = loss_fn(output, y)
            optimizer.zero_grad()
            loss_value.backward()
            optimizer.step()
            loss_accumulate += loss_value.item()
            _, pred = output.max(1)  # 预测类别
            train_correct_accumulate += pred.eq(y).sum().item()
            # 进度条
            print(f"\repoch:{epoch:02d}[{'='*int((batch_count+1)/len(train_loader)*50):<50}]", end="")
        this_loss = loss_accumulate / len(train_loader)
        this_train_acc = train_correct_accumulate / len(train_dataset)

        # ---------- 验证阶段 ----------
        model.eval()  # 关闭 Dropout 等,使用确定性子层
        test_loader = DataLoader(dataset=test_dataset, batch_size=batch_size, shuffle=False)
        test_correct_accumulate = 0
        with torch.no_grad():  # 不计算梯度,省显存、提速
            for X, y in test_loader:
                X, y = X.to(device), y.to(device)
                output = model(X)
                _, pred = output.max(1)
                test_correct_accumulate += pred.eq(y).sum().item()
        this_test_acc = test_correct_accumulate / len(test_dataset)
        print(f" loss:{this_loss:.6f}, train_acc:{this_train_acc:.6f}, test_acc:{this_test_acc:.6f}")

# 有 GPU 用 cuda,否则 cpu;按 batch 训练
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
train(model, train_dataset, test_dataset, lr=0.9, epoch_num=20, batch_size=256, device=device)
一起交流
分享你的思考,让讨论更进一步。